<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://aladinodigitale.it/feed.xml" rel="self" type="application/atom+xml" /><link href="https://aladinodigitale.it/" rel="alternate" type="text/html" /><updated>2026-09-24T23:49:27+00:00</updated><id>https://aladinodigitale.it/feed.xml</id><title type="html">Aladino Digitale</title><subtitle>AI generativa per immagini, video e codice – usata sul campo.</subtitle><author><name>Aladino Digitale</name><email>alessio@aladinodigitale.it</email></author><entry><title type="html">Quando l’open source sblocca il silicio: il caso AMD e l’inferenza AI locale</title><link href="https://aladinodigitale.it/2026/09/24/open-source-amd-strix-halo.html" rel="alternate" type="text/html" title="Quando l’open source sblocca il silicio: il caso AMD e l’inferenza AI locale" /><published>2026-09-24T00:00:00+00:00</published><updated>2026-09-24T00:00:00+00:00</updated><id>https://aladinodigitale.it/2026/09/24/open-source-amd-strix-halo</id><content type="html" xml:base="https://aladinodigitale.it/2026/09/24/open-source-amd-strix-halo.html"><![CDATA[<p>Quando si parla del vantaggio di NVIDIA nell’intelligenza artificiale, si tende naturalmente a pensare alle GPU. Più potenza di calcolo, più memoria, Tensor Core sempre più sofisticati.</p>

<p>Ma una parte enorme di quel vantaggio non è nel silicio.</p>

<p>È nel software.</p>

<p>CUDA esiste dal 2006. In quasi vent’anni NVIDIA ha costruito intorno alle proprie GPU un ecosistema verticale composto da compiler, runtime, librerie matematiche, kernel ottimizzati, profiler, framework e strumenti di sviluppo. Quando un nuovo modello arriva sul mercato, nella maggior parte dei casi buona parte del lavoro necessario per farlo girare bene su NVIDIA è già stata fatta.</p>

<p>AMD parte da una posizione diversa. ROCm è sviluppato direttamente da AMD ed è in larga parte open source, ma è un ecosistema più giovane e ancora meno uniforme. Su hardware consumer recente non è raro incontrare feature non ancora ottimizzate, percorsi software alternativi, differenze tra <a href="https://rocmdocs.amd.com/projects/HIP/">HIP</a> e <a href="https://www.amd.com/en/products/graphics/ecosystems/vulkan.html">Vulkan</a>, regressioni o semplicemente workload che nessuno aveva ancora studiato in dettaglio.</p>

<p>A prima vista può sembrare solamente uno svantaggio.</p>

<p>Negli ultimi mesi, però, osservando quello che sta succedendo intorno a hardware come <a href="https://www.amd.com/en/products/processors/laptop/ryzen/ai-300-series/amd-ryzen-ai-max-plus-395.html">Strix Halo</a>, ho iniziato a vederci anche qualcosa di molto più interessante.</p>

<p>Perché quando lo stack è aperto, un collo di bottiglia non deve necessariamente aspettare che il vendor decida di risolverlo.</p>

<p>Può farlo qualcun altro.</p>

<p>E qualcun altro ancora può prendere quella soluzione, modificarla, misurarla, combinarla con un’altra idea e infine tentare di riportarne la parte generalizzabile upstream.</p>

<p>Quello che sta emergendo non è semplicemente “una community che rende AMD più veloce”.</p>

<p>È qualcosa che assomiglia sempre di più a un <strong>co-design distribuito tra modelli, rappresentazioni numeriche, algoritmi di inferenza, runtime e hardware</strong>.</p>

<hr />

<h2 id="il-primo-cambio-di-prospettiva-quantizzare-non-significa-solo-occupare-meno-memoria">Il primo cambio di prospettiva: quantizzare non significa solo occupare meno memoria</h2>

<p>Per anni abbiamo raccontato la quantizzazione quasi esclusivamente come un compromesso.</p>

<p>Un modello a 4 bit occupa meno memoria di uno a 8 o 16 bit, al prezzo di una certa perdita di precisione.</p>

<p>È vero, naturalmente. Ma su una macchina come Strix Halo manca un pezzo importante della storia.</p>

<p>Durante il decode di un LLM, molto spesso il problema non è la quantità di operazioni che la GPU può teoricamente eseguire. Il problema è la velocità con cui i pesi possono essere letti dalla memoria.</p>

<p>Se per generare ogni token devo attraversare decine di gigabyte di pesi, leggere meno bit significa anche spostare meno dati.</p>

<p>La quantizzazione diventa quindi una tecnica per sfruttare meglio la memory bandwidth.</p>

<p>È in questo contesto che lavori come <strong><a href="https://github.com/charlie12345/ROCmFPX">ROCmFPX</a> di <a href="https://github.com/charlie12345">Carlo Pasquale</a></strong> diventano particolarmente interessanti.</p>

<p>ROCmFP4 e le successive varianti non sono semplicemente nuovi nomi per una Q4 tradizionale. Sono formati e layout pensati esplicitamente per l’esecuzione su hardware AMD, con compromessi differenti tra dimensione, precisione e velocità. Nel repository compaiono oggi diversi percorsi specifici per Strix Halo, sia HIP sia Vulkan.</p>

<p>Ma il passaggio concettuale successivo è ancora più importante.</p>

<p>Forse la domanda sbagliata è:</p>

<p>“Questo modello è Q4 o Q8?”</p>

<p>La domanda più interessante diventa:</p>

<p><strong>quali pesi conviene quantizzare, a quale precisione, e per quale motivo?</strong></p>

<p>Qui è utile anche il lavoro di <strong>Salvatore Sanfilippo, <a href="https://github.com/antirez">antirez</a>, con <a href="https://github.com/antirez/ds4">DwarfStar/DS4</a></strong>.</p>

<p>Nelle ricette per i grandi modelli MoE, per esempio, non tutti i tensori vengono trattati allo stesso modo. I routed experts possono essere compressi molto aggressivamente, mentre altre componenti — proiezioni, shared experts, output — vengono mantenute a precisione superiore. Anche l’importance matrix viene usata per guidare la quantizzazione.</p>

<p>Non è più semplicemente “comprimere un modello”.</p>

<p>È una forma di <strong>allocazione del budget di precisione</strong>.</p>

<p>Spendere più bit dove servono davvero e meno dove il modello può permetterselo.</p>

<hr />

<h2 id="quando-la-quantizzazione-entra-nel-runtime">Quando la quantizzazione entra nel runtime</h2>

<p>Il lavoro di <strong><a href="https://huggingface.co/jcbtc/activity/community">Ciru</a></strong> parte da ROCmFPX e spinge questa idea ancora oltre.</p>

<p><a href="https://llm.ciru.ai/dualview#explainer">DualView</a>, per esempio, parte da una rappresentazione Q7 dei pesi, ma permette alla GPU di vederli in modi diversi a seconda della fase dell’inferenza.</p>

<p>Durante il decode usa la rappresentazione compatta, riducendo i byte che devono essere letti per ciascun token.</p>

<p>Durante il prefill espone invece gli stessi valori sotto forma di una compute view Q8, adatta ai percorsi INT8 nativi dell’hardware.</p>

<p>Non viene fatta una seconda quantizzazione: cambia la rappresentazione utilizzata per il calcolo.</p>

<p>È un dettaglio tecnico che nasconde un’idea molto più generale:</p>

<p><strong>non esiste necessariamente una rappresentazione numerica migliore in assoluto. Può esistere una rappresentazione migliore per ciascuna fase dell’inferenza.</strong></p>

<p>ActiveFPX e PromptForge proseguono nella stessa direzione, arrivando a costruire percorsi di esecuzione specifici per le forme delle matrici effettivamente prodotte da modelli come Qwen 3.8.</p>

<p>A quel punto diventa difficile tracciare una linea netta tra “formato del modello” e “runtime”.</p>

<p>La quantizzazione è ormai parte del motore di esecuzione.</p>

<hr />

<h2 id="quando-un-modello-sblocca-unistruzione-della-gpu">Quando un modello sblocca un’istruzione della GPU</h2>

<p>Un altro esempio che trovo particolarmente elegante riguarda MTP, Multi-Token Prediction.</p>

<p>Nel normale decode autoregressivo un LLM genera essenzialmente un token alla volta.</p>

<p>Questo limita il parallelismo disponibile in alcune operazioni.</p>

<p>Ma con MTP il modello può proporre più token futuri, che vengono poi verificati insieme dal modello principale.</p>

<p>Questa verifica batched cambia la forma del problema.</p>

<p>Ed è qui che entra in gioco una caratteristica molto specifica di Strix Halo: le istruzioni matrix IU4 disponibili su gfx1151 (Strix Halo).</p>

<p>Nel lavoro ROCmFPX, un percorso sperimentale W4A4 collega proprio questi due mondi: pesi a quattro bit, attivazioni a quattro bit e istruzioni matrix IU4.</p>

<p>La cosa interessante non è tanto il risultato numerico del benchmark. È la catena causale:</p>

<p><strong>il modello introduce MTP → MTP crea una verifica batched → la verifica batched rende utile una determinata operazione matrix → il runtime può finalmente sfruttare un’istruzione hardware specifica.</strong></p>

<p>A questo punto non stiamo più semplicemente ottimizzando un kernel.</p>

<p>Stiamo collegando una caratteristica dell’architettura del modello a una caratteristica della microarchitettura della GPU.</p>

<p>Ed è proprio questo uno degli aspetti più interessanti dell’open source: chi sviluppa il runtime può osservare entrambe le estremità del problema.</p>

<hr />

<h2 id="poi-qualcuno-apre-il-profiler">Poi qualcuno apre il profiler</h2>

<p>Non tutte le ottimizzazioni nascono da un nuovo formato numerico.</p>

<p><a href="https://github.com/ggml-org/llama.cpp">llama.cpp</a> ha oltre 23 mila fork; tra questi, diversi sono oggetto di lavoro di ricerca per ottimizzazioni specifiche per determinati scenari, hardware, etc. Tra queste, interessante è il lavoro di <strong><a href="https://github.com/Nathanw1014">Nathan Wilson</a></strong>, il cui fork per Strix Halo rappresenta bene l’altra faccia del processo di ottimizzazione: profiling sistematico, identificazione dei colli di bottiglia, patch piccole e verificabili.</p>

<p>Un esempio riguarda Flash Attention e la KV cache quantizzata. In alcuni percorsi il runtime finiva per dequantizzare gli stessi dati più volte. Modificando il flusso in modo da effettuare la dequantizzazione una sola volta e riutilizzarne il risultato, si elimina lavoro ridondante.</p>

<p>Lo stesso repository contiene interventi su MoE prefill, percorsi MMID, layout dei dati e kernel HIP/Vulkan. Ma forse la parte più importante è un’altra: Nathan separa chiaramente le patch candidate all’upstream da quelle che rimangono specifiche per Strix Halo.</p>

<p>Alcuni esperimenti producono miglioramenti importanti, altri quasi nulla, altri ancora peggiorano le prestazioni.</p>

<p>Ed è perfettamente normale.</p>

<p>Open source non significa automaticamente software migliore.</p>

<p>Significa che l’esperimento è visibile, riproducibile e falsificabile.</p>

<p>Qualcun altro può ripeterlo.</p>

<p>Può trovare un workload nel quale non funziona, può capire perché, può proporre una soluzione migliore.</p>

<hr />

<h2 id="e-se-il-problema-non-fosse-la-gpu">E se il problema non fosse la GPU?</h2>

<p>Con modelli sempre più complessi, anche concentrarsi esclusivamente sulla velocità dei kernel GPU comincia a essere limitante. <a href="https://github.com/Aristo94/EngramHalo.cpp">EngramHalo</a>, il fork di <a href="https://github.com/Aristo94">Aristo94</a> dedicato a Qwen 3.8 Flash-Next, è un buon esempio perché prova a sfruttare alcune caratteristiche particolari dell’architettura del modello invece di trattarlo come un Transformer tradizionale.</p>

<p>Una di queste è Qwen Sparse Attention (QSA). Con la normale attention, all’aumentare del contesto cresce anche la quantità di informazioni passate che bisogna considerare. QSA parte invece dall’idea che, per il token corrente, gran parte di un contesto molto lungo non sia necessariamente rilevante: un piccolo indexer individua quindi i blocchi del passato che vale la pena recuperare, e l’attention può concentrarsi principalmente su quelli.</p>

<p>Ma avere un algoritmo concettualmente sparse non significa necessariamente eseguirlo in modo davvero sparse. Se il runtime individua i token rilevanti ma continua comunque a leggere una grande porzione della KV cache per poi escludere ciò che non serve tramite una maschera, dal punto di vista logico sta facendo sparse attention, ma dal punto di vista della memoria continua a muovere molti dati inutilmente.</p>

<p>Uno degli interventi interessanti di EngramHalo è proprio qui: usa gli indici prodotti da QSA per effettuare un vero sparse gather, raccogliendo prima soltanto le righe K/V selezionate in un buffer compatto e facendo lavorare l’attention direttamente su quello. In termini semplici, invece di leggere tutto e poi scartare ciò che non serve, cerca di leggere direttamente solo ciò che servirà.</p>

<p>Qwen 3.8 Flash-Next introduce poi un’altra struttura particolare: la grande Engram table, una memoria associativa basata su n-gram. Brevi sequenze di token vengono usate per indirizzare direttamente alcune righe di una gigantesca tabella di embedding. La tabella può quindi contenere decine di miliardi di parametri senza che sia necessario attraversarli tutti a ogni token: per ciascuna inferenza ne viene consultata soltanto una piccolissima parte.</p>

<p>Questa caratteristica rende la Engram table molto diversa dai normali pesi di un layer e apre una possibilità interessante: non è indispensabile mantenerla interamente nella memoria più veloce. Può essere lasciata su storage e consultata on demand. EngramHalo sfrutta esplicitamente questa possibilità nel proprio percorso ottimizzato per Strix Halo, combinandola con QSA sparse gather, MTP e altre modifiche al runtime.</p>

<p>Non è un’idea isolata, in realtà. Antirez, in DS4, adotta una strategia molto simile: per Qwen 3.8 Flash-Next i 95,37 GiB di n-gram BF16 rimangono direttamente sul disco e il runtime legge dal GGUF soltanto le righe selezionate, senza caricare o mappare l’intera tabella in memoria. Anche qui il presupposto è lo stesso: se una struttura è enorme ma viene consultata in modo fortemente sparso, tenerla sempre residente è uno spreco.</p>

<p>È qui che il caso EngramHalo, e più in generale il confronto con DS4, diventa particolarmente interessante per il discorso più ampio. L’ottimizzazione non consiste semplicemente nel far eseguire alla GPU la stessa operazione un po’ più velocemente. Consiste nel guardare alla struttura del modello e chiedersi quale sia il modo più naturale di mapparla sull’intero sistema.</p>

<p>Una macchina basata su Strix Halo non è soltanto una GPU. È CPU, GPU, cache, memoria unificata e tipicamente NVMe, ciascuna con capacità, latenza e banda differenti. E anche il modello non è più un blocco uniforme di pesi: alcune strutture devono essere attraversate continuamente, altre richiedono accessi sparsi, altre ancora sono enormi ma vengono consultate solo in pochi punti.</p>

<p>Il compito del runtime diventa quindi non soltanto eseguire operazioni matematiche, ma decidere quali dati devono trovarsi dove, quali devono essere mossi e quali possono invece rimanere dove sono finché non servono.</p>

<p>Ed è proprio questo che rende implementazioni come EngramHalo un esempio così interessante del ruolo dell’open source: l’architettura del modello è pubblica, i runtime sono modificabili e il comportamento dell’hardware può essere osservato e misurato. Questo permette a sviluppatori indipendenti di arrivare, anche per strade diverse, a soluzioni simili: sparse attention che sia davvero sparse anche dal punto di vista della memoria, strutture enormi tenute su storage e recuperate on demand, runtime che ragionano sempre meno come semplici esecutori di kernel e sempre più come orchestratori dell’intero sistema.</p>

<hr />

<h2 id="quando-unidea-esce-da-una-black-box">Quando un’idea esce da una black box</h2>

<p>Un passaggio interessante in questa storia è quello che collega <a href="https://github.com/peonist-ai/halogen-flash-server">Halogen</a>, <a href="https://github.com/pwilkin">pwilkin</a> e Ciru. Halogen, sviluppato da Peonist.ai, è un engine specifico per Qwen 3.8 Flash Next e AMD Strix Halo; mostra quanto si possa spingere lontano l’ottimizzazione quando si costruisce un runtime molto specializzato per una combinazione precisa di modello e hardware, ma il core del motore è proprietario. Il contributo di pwilkin è stato diverso: ha riprodotto in un’implementazione aperta basata su llama.cpp alcune delle idee che permettevano a Halogen di ottenere un prefill particolarmente veloce su Qwen 3.8 Flash-Next, rendendo disponibili kernel, configurazioni e percorso di esecuzione in una forma che altri potessero studiare e modificare.</p>

<p>È proprio da qui che il caso diventa interessante per il tema dell’open source. Una tecnica che inizialmente era osservabile soprattutto attraverso il comportamento di un runtime chiuso diventa improvvisamente codice ispezionabile e riutilizzabile. Ciru ha potuto prendere quel lavoro, adattarlo ai propri formati di peso e al proprio runtime e integrarlo con altre ottimizzazioni. Il valore non sta quindi soltanto nella velocità ottenuta, ma nel passaggio di stato dell’idea: da soluzione incorporata in un prodotto specifico a building block che può essere verificato, modificato e combinato con contributi indipendenti.</p>

<p>È un esempio quasi didattico di come può funzionare la circolazione dell’innovazione in un ecosistema aperto: un’idea emerge in un’implementazione specializzata, qualcuno la ricostruisce in forma open, altri la incorporano e la trasformano ulteriormente. Non è necessario che tutti i pezzi della catena siano open perché questo accada, ma è nel momento in cui l’implementazione diventa aperta che il ritmo di riuso e contaminazione può accelerare davvero.</p>

<hr />

<h2 id="dal-laboratorio-allecosistema">Dal laboratorio all’ecosistema</h2>

<p>C’è però un problema con tutta questa innovazione.</p>

<p>A un certo punto hai:</p>

<ul>
  <li>un branch di llama.cpp;</li>
  <li>un kernel sperimentale;</li>
  <li>una quantizzazione custom;</li>
  <li>un container diverso;</li>
  <li>una determinata versione di ROCm;</li>
  <li>tre environment variable;</li>
  <li>e un README di quattro pagine.</li>
</ul>

<p>Tecnicamente funziona.</p>

<p>Praticamente quasi nessuno lo userà.</p>

<p>Qui entra in gioco un contributo meno spettacolare dal punto di vista algoritmico, ma fondamentale per la maturazione dell’ecosistema: quello di <strong><a href="https://github.com/kyuz0">Donato Capitella kyuz0</a></strong>.</p>

<p><a href="https://github.com/kyuz0/amd-strix-halo-toolboxes">Le AMD Strix Halo Toolboxes</a> trasformano molti di questi esperimenti in ambienti riproducibili. Oggi raccolgono stack ROCm e Vulkan, configurazioni per Qwen Flash-Next, EngramHalo e anche l’integrazione con <a href="https://github.com/halo-box/strix-llama.cpp">strix-llama di halo-box</a>.</p>

<p>È facile sottovalutare questo passaggio.</p>

<p>Ma un’ottimizzazione non diventa realmente parte dell’ecosistema quando qualcuno scrive la patch.</p>

<p>Lo diventa quando qualcun altro riesce a riprodurla.</p>

<hr />

<h2 id="il-problema-successivo-troppe-buone-idee">Il problema successivo: troppe buone idee</h2>

<p>Arrivati qui emerge un paradosso.</p>

<p>La libertà di sperimentare produce tanti fork; se ciascuna innovazione rimane nel proprio fork, l’ecosistema rischia di frammentarsi.</p>

<p>È qui che progetti come <strong>halo-box/strix-llama.cpp</strong> diventano interessanti.</p>

<p>Il progetto mantiene volutamente una distinzione tra ciò che può essere generalizzato e ciò che rimane specifico di gfx1151. La base rimane vicina a llama.cpp upstream, mentre le ottimizzazioni più aggressive per Strix Halo possono essere integrate e sperimentate separatamente.</p>

<p>Forse è proprio questo il ciclo naturale di maturazione:</p>

<p><strong>esperimento → fork → benchmark → confronto → integrazione → upstream.</strong></p>

<p>Non tutte le idee arriveranno alla fine del percorso.</p>

<p>E non devono farlo.</p>

<p>Le ottimizzazioni strettamente legate a Strix Halo possono restare in uno stack specializzato.</p>

<p>Quelle generalizzabili possono risalire verso llama.cpp, ROCm, PyTorch o altri progetti upstream.</p>

<p>Nel frattempo tool come quelli di Donato possono renderle utilizzabili senza costringere ogni utente a ricostruire manualmente l’intera genealogia delle patch.</p>

<hr />

<h2 id="non-è-solo-una-storia-di-llm">Non è solo una storia di LLM</h2>

<p>La cosa che mi convince maggiormente che non si tratti di un’anomalia temporanea di llama.cpp è che lo stesso pattern sta comparendo nella generazione di immagini e video.</p>

<p>Con <strong>MiniMax H3</strong>, per esempio, uno dei colli di bottiglia su RDNA3.5 è l’attention su sequenze molto lunghe.</p>

<p>Il percorso generico funziona.</p>

<p>Ma conoscere contemporaneamente la forma precisa dei tensori prodotti dal modello e le caratteristiche di gfx1151 permette di costruire un percorso attention specializzato, evitando trasformazioni e movimenti di dati inutili.</p>

<p>Il risultato interessante non è il numero di secondi risparmiati.</p>

<p>È che qualcuno, al di fuori del team che ha progettato il modello e al di fuori del team che ha progettato la GPU, può studiare entrambi e trovare una <a href="https://github.com/Yasei-no-otoko/ComfyUI-RDNA35-Attention">rappresentazione più efficiente del problema</a>.</p>

<p>Con <strong>Qwen Image 2.1</strong> il concetto arriva ancora più lontano.</p>

<p>Non si interviene soltanto sul kernel.</p>

<p>Si possono combinare attention ottimizzate per l’hardware con tecniche che evitano di ricalcolare completamente parti del modello quando <a href="https://github.com/ciru-ai/ComfyUI-CiruImageAccelerator">l’informazione cambia poco tra uno step e il successivo</a>.</p>

<hr />

<h2 id="conclusione-il-valore-dellapertura">Conclusione: il valore dell’apertura</h2>

<p>La cosa che trovo più interessante in tutta questa storia non è stabilire se AMD possa o meno recuperare il vantaggio accumulato da CUDA. È osservare cosa diventa possibile quando modello, runtime e buona parte dello stack software sono aperti. Un problema di prestazioni non appartiene più necessariamente al team che ha progettato la GPU, a quello che ha creato il modello o ai maintainer del framework: chiunque abbia competenze sufficienti può attraversare questi confini, capire dove si perde tempo o banda e provare una soluzione. È esattamente quello che vediamo nei lavori menzionati qui sopra e molti altri in community: idee nate indipendentemente che possono essere studiate, modificate, combinate e verificate da persone che spesso non appartengono alla stessa organizzazione e non si sono mai coordinate a priori.</p>

<p>Per me è questo il valore aggiunto più importante dell’open source. Non semplicemente avere accesso al codice, e nemmeno disporre di sviluppatori che fanno gratuitamente il lavoro che dovrebbe fare il vendor. È creare un ambiente in cui l’innovazione può avvenire <strong>senza dover essere pianificata centralmente</strong>. Un formato numerico nato per risolvere un problema può suggerire un nuovo kernel; un’ottimizzazione scritta per un modello può rivelare una proprietà utile della GPU; qualcuno può prendere entrambe, integrarle in un altro runtime e scoprire qualcosa che nessuno dei progetti originali aveva previsto. Anche gli esperimenti che non sopravvivono lasciano dietro di sé benchmark, codice, discussioni e conoscenza tecnica riutilizzabile.</p>

<p>Naturalmente questo ha un costo: duplicazione degli sforzi, fork incompatibili, esperimenti che si rivelano vicoli ciechi e una user experience che, soprattutto nelle fasi iniziali, è molto lontana dalla prevedibilità di uno stack maturo come CUDA. Ma la frammentazione che vediamo oggi può essere anche il laboratorio dal quale emergeranno le soluzioni di domani. Progetti come halo-box provano già a raccogliere idee nate altrove; kyuz0 le rende più facilmente riproducibili; ciò che si dimostra abbastanza generale può infine arrivare negli upstream. In questo processo non è necessario che sopravvivano tutti i repository: è molto più importante che possano sopravvivere <strong>le idee</strong>.</p>

<p>Da ingegnere che lavora da molto tempo con l’open source, probabilmente guardo questo fenomeno con una certa predisposizione favorevole. Ma Strix Halo mi sembra un caso particolarmente concreto di qualcosa che ho visto molte volte: l’apertura non sostituisce l’investimento del produttore, ma può moltiplicarne gli effetti. AMD fornisce il silicio e sviluppa ROCm; i progetti upstream costruiscono le fondamenta comuni; una comunità distribuita esplora contemporaneamente strade che nessuna singola azienda potrebbe probabilmente prioritizzare tutte. Il risultato è che, mesi dopo aver acquistato una macchina, quello stesso hardware può fare cose che al momento del lancio erano lente, difficili o semplicemente non previste. <strong>Il silicio non è cambiato. È aumentata la conoscenza collettiva di come usarlo.</strong> Ed è forse questa la parte più interessante della storia.</p>

<hr />

<h2 id="riferimenti-e-approfondimenti">Riferimenti e approfondimenti</h2>

<ul>
  <li><a href="https://github.com/charlie12345/ROCmFPX">ROCmFPX — Carlo Pasquale</a></li>
  <li><a href="https://github.com/antirez/ds4">DwarfStar/DS4 — Salvatore Sanfilippo (antirez)</a></li>
  <li><a href="https://huggingface.co/jcbtc/activity/community">Ciru — profilo Hugging Face</a></li>
  <li><a href="https://llm.ciru.ai/dualview#explainer">DualView — Ciru</a></li>
  <li><a href="https://huggingface.co/jcbtc/Qwen3.8-27B-CIRU-ActiveFPX-PromptForge">Qwen3.8-27B CIRU ActiveFPX/PromptForge — Hugging Face</a></li>
  <li><a href="https://github.com/Nathanw1014">Nathan Wilson — fork llama.cpp per Strix Halo</a></li>
  <li><a href="https://github.com/Aristo94/EngramHalo.cpp">EngramHalo — Aristo94</a></li>
  <li><a href="https://github.com/peonist-ai/halogen-flash-server">Halogen Flash Server — Peonist.ai</a></li>
  <li><a href="https://github.com/pwilkin">pwilkin — GitHub</a></li>
  <li><a href="https://github.com/kyuz0/amd-strix-halo-toolboxes">AMD Strix Halo Toolboxes — kyuz0 (Donato Capitella)</a></li>
  <li><a href="https://github.com/halo-box/strix-llama.cpp">strix-llama.cpp — halo-box</a></li>
  <li><a href="https://github.com/Yasei-no-otoko/ComfyUI-RDNA35-Attention">ComfyUI RDNA35 Attention — Yasei-no-otoko</a></li>
  <li><a href="https://github.com/ciru-ai/ComfyUI-CiruImageAccelerator">ComfyUI CiruImageAccelerator — ciru-ai</a></li>
  <li><a href="https://rocmdocs.amd.com/projects/HIP/">HIP — ROCm documentation</a></li>
  <li><a href="https://www.amd.com/en/products/graphics/ecosystems/vulkan.html">AMD — Vulkan ecosystem</a></li>
  <li><a href="https://www.amd.com/en/products/processors/laptop/ryzen/ai-300-series/amd-ryzen-ai-max-plus-395.html">AMD Ryzen AI Max+ 395 — scheda prodotto</a></li>
  <li><a href="https://github.com/ggml-org/llama.cpp">llama.cpp — ggml-org</a></li>
</ul>]]></content><author><name>Alessio Soldano</name></author><category term="AI locale" /><category term="open source" /><category term="AMD" /><category term="Strix Halo" /><category term="ROCm" /><category term="llama.cpp" /><category term="quantizzazione" /><category term="LLM" /><category term="inferenza" /><summary type="html"><![CDATA[Il vantaggio di NVIDIA nell'AI non sta solo nel silicio, ma nello software che lo circonda. Attorno ad AMD Strix Halo sta però emergendo un ecosistema open source che sta imparando a sfruttare l'hardware meglio e più in fretta di quanto il vendor da solo avrebbe potuto: formati di quantizzazione dedicati, runtime che sfruttano istruzioni specifiche della GPU e ottimizzazioni nate dalla community.]]></summary></entry><entry><title type="html">Approfondimento del denoising: scheduler, sampler e low-step LoRA</title><link href="https://aladinodigitale.it/2026/08/10/sampler-scheduler-low-step-lora.html" rel="alternate" type="text/html" title="Approfondimento del denoising: scheduler, sampler e low-step LoRA" /><published>2026-08-10T00:00:00+00:00</published><updated>2026-08-10T00:00:00+00:00</updated><id>https://aladinodigitale.it/2026/08/10/sampler-scheduler-low-step-lora</id><content type="html" xml:base="https://aladinodigitale.it/2026/08/10/sampler-scheduler-low-step-lora.html"><![CDATA[<p>L’uscita di un nuovo modello generativo tende a produrre sempre la stessa sequenza: benchmark, esempi, confronti, prompt, classifiche. Con MiniMax H3, presentato a fine luglio e reso disponibile con i pesi pochi giorni dopo, è successo naturalmente anche questo.</p>

<p>Ma c’è un altro aspetto, secondo me più interessante: quando un modello può essere eseguito localmente e il suo workflow è accessibile, diventa possibile <strong>guardare dentro il processo di generazione</strong>, separarne i componenti e sperimentare.</p>

<p>È quello che sta succedendo in questi giorni attorno a H3. Nel giro di pochissimo tempo sono comparsi workflow ComfyUI, quantizzazioni, implementazioni alternative, sampler specifici e LoRA pensati per ridurre drasticamente il numero di step necessari. Non è tanto H3 in sé il tema di questo post: è piuttosto l’occasione per capire cosa significhino davvero alcune delle voci che troviamo nei workflow — <em>scheduler</em>, <em>sampler</em>, <em>sigma shift</em>, <em>steps</em>, <em>low-step LoRA</em> — e soprattutto perché intervenire su queste componenti possa migliorare la qualità, ridurre il tempo di generazione, o entrambe le cose.</p>

<p>L’obiettivo non è entrare nei dettagli dell’architettura specifica di H3, dei suoi Transformer, dell’attention o del training. Ci interessa un livello più alto: <strong>come avviene il sampling di una moderna pipeline generativa e dove possiamo intervenire per renderlo più efficiente</strong>.</p>

<blockquote>
  <p>Nota terminologica: userò spesso “denoising” nel senso intuitivo di processo iterativo che porta da uno stato rumoroso al contenuto finale. H3 è in realtà un modello basato su <em>flow matching</em>, non un diffusion model classico. Vedremo tra poco perché, per il discorso che ci interessa, l’astrazione resta comunque molto utile.</p>
</blockquote>

<hr />

<h2 id="prima-di-sampler-e-scheduler-come-nasce-unimmagine-o-un-video">Prima di sampler e scheduler: come nasce un’immagine o un video?</h2>

<p>Semplificando molto, una pipeline moderna di generazione può essere vista così:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>prompt / immagini / video / audio di riferimento
                    │
                    ▼
          encoder / conditioning
                    │
                    ▼
             latent iniziale
                    │
                    ▼
         ┌───────────────────┐
         │  GENERAZIONE      │
         │    ITERATIVA      │
         │                   │
         │   model forward   │
         │        ↓          │
         │   latent update   │
         │        ↓          │
         │   model forward   │
         │        ↓          │
         │        ...        │
         └───────────────────┘
                    │
                    ▼
              latent finale
                    │
                    ▼
                 VAE
                    │
                    ▼
             immagine / video
</code></pre></div></div>

<p>Il prompt e gli eventuali riferimenti vengono prima trasformati in rappresentazioni che il modello possa usare come <em>conditioning</em>. Nel caso di un’immagine o di un video non lavoriamo normalmente direttamente sui pixel: il contenuto viene rappresentato in uno spazio compresso, il <strong>latent space</strong>.</p>

<p>La parte che ci interessa è il blocco centrale.</p>

<p>La generazione non avviene in una singola esecuzione del modello. Si parte da un latent fortemente rumoroso e lo si trasforma progressivamente fino a ottenere un latent che il VAE possa infine decodificare in pixel.</p>

<p>Per un video il concetto è lo stesso, anche se il latent è molto più grande: deve rappresentare non soltanto altezza e larghezza, ma anche il tempo. In H3, inoltre, audio e video vengono generati congiuntamente nello stesso sistema.</p>

<p>Ed è proprio questo loop iterativo a costare molto.</p>

<hr />

<h2 id="diffusion-e-flow-matching-abbastanza-teoria-da-non-raccontare-bugie">Diffusion e flow matching: abbastanza teoria da non raccontare bugie</h2>

<p>Nei diffusion model classici il punto di partenza concettuale è un processo che aggiunge progressivamente rumore ai dati. Il modello impara poi a percorrere in qualche modo il processo inverso. A seconda della parametrizzazione può predire rumore, score, velocity o altre quantità correlate.</p>

<p>Il <strong>flow matching</strong> guarda il problema da una prospettiva leggermente diversa.</p>

<p>Immaginiamo una distribuzione semplice, come il rumore gaussiano, e la distribuzione complessa delle immagini o dei video che vogliamo generare. Tra le due esiste idealmente un percorso continuo. Il modello impara un <strong>campo vettoriale</strong>: dato il punto in cui ci troviamo lungo quel percorso, ci dice in quale direzione dobbiamo muoverci.</p>

<p>In forma molto astratta:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>rumore                                      video
  ● ───────────────────────────────────────► ●

       il modello impara "come muoversi"
       lungo questa trasformazione
</code></pre></div></div>

<p>H3 appartiene a questa seconda famiglia.</p>

<p>Questa distinzione è importante dal punto di vista matematico, ma per quello che vogliamo capire possiamo usare un’astrazione comune:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>stato corrente
      │
      ▼
   MODELLO
      │
      ▼
predizione di come evolvere lo stato
      │
      ▼
 aggiornamento
      │
      ▼
stato successivo
</code></pre></div></div>

<p>Da qui in avanti ragioneremo soprattutto come se avessimo un modello <em>flow-based</em>, perché è il caso di H3 e rende particolarmente intuitivo il ruolo di scheduler e sampler. Molte delle idee, però, si ritrovano anche nelle pipeline diffusion tradizionali.</p>

<hr />

<h2 id="sigma-dove-siamo-lungo-il-viaggio">Sigma: dove siamo lungo il viaggio</h2>

<p>Serve ora una coordinata che descriva <strong>a che punto del processo ci troviamo</strong>.</p>

<p>In molte implementazioni questa coordinata viene espressa tramite <code class="language-plaintext highlighter-rouge">sigma</code>.</p>

<p>L’intuizione utile è:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>sigma alto                                sigma basso

rumore  ───────────────────────────────────────► contenuto
 1.0                                               0.0
</code></pre></div></div>

<p>Non bisogna interpretare sigma semplicemente come “quanto rumore tolgo in questo step”. È piuttosto un’indicazione del <strong>livello di rumore dello stato corrente</strong>, ovvero della nostra posizione lungo la traiettoria.</p>

<p>A sigma molto alto il contenuto è ancora quasi tutto da determinare. A sigma basso la struttura è già sostanzialmente emersa e ci troviamo vicino al risultato finale.</p>

<p>Il modello riceve quindi qualcosa che, semplificando, assomiglia a:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>latent corrente
sigma / timestep
conditioning
</code></pre></div></div>

<p>e produce una predizione.</p>

<p>Nel caso di un flow model possiamo pensarla come una <strong>velocity</strong>, cioè una direzione locale:</p>

<blockquote>
  <p>“Se ti trovi qui, a questo punto del percorso, devi muoverti in questa direzione.”</p>
</blockquote>

<p>Una singola esecuzione completa del modello viene chiamata <strong>forward pass</strong>.</p>

<h3 id="timeline-curva-dei-sigma-e-griglia-di-riferimento">Timeline, curva dei sigma e griglia di riferimento</h3>

<p>Fin qui abbiamo usato <code class="language-plaintext highlighter-rouge">sigma</code> come coordinata del processo, ma nelle implementazioni compare spesso anche un’altra coordinata: il <strong>timestep</strong> (o, più genericamente, <code class="language-plaintext highlighter-rouge">t</code>), cioè una posizione lungo la timeline ideale della generazione.</p>

<p>Le due cose non sono necessariamente la stessa cosa.</p>

<p>Possiamo pensare a <code class="language-plaintext highlighter-rouge">t</code> come a una coordinata astratta lungo il percorso:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>t = 1                                      t = 0
rumore  ───────────────────────────────────► contenuto
</code></pre></div></div>

<p>Il <em>model sampling</em> definisce poi una relazione:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>sigma = f(t)
</code></pre></div></div>

<p>che associa a ogni posizione della timeline il corrispondente livello di rumore. Se disegnassimo <code class="language-plaintext highlighter-rouge">sigma</code> in funzione di <code class="language-plaintext highlighter-rouge">t</code>, otterremmo quella che nel seguito chiameremo <strong>curva dei sigma</strong>.</p>

<p>Questa curva non deve essere lineare. Due timestep equidistanti possono quindi corrispondere a valori di sigma molto diversi tra loro.</p>

<p>Nella pratica il computer non rappresenta una curva continua con infiniti punti. Un’implementazione può costruire una <strong>griglia di riferimento</strong> molto più fitta degli step che useremo davvero per generare: una tabella di timestep e dei corrispondenti sigma. In ComfyUI, per i flow model discreti come quello usato da H3, questa griglia contiene normalmente molti più punti — tipicamente 1000 — rispetto ai 4, 8 o 20 step di una generazione.</p>

<p>È importante non confondere le due cose:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>griglia di riferimento del modello
moltissimi punti che descrivono t → sigma
                    │
                    ▼
               scheduler
                    │
                    ▼
pochi sigma realmente usati nella generazione
</code></pre></div></div>

<p>Quei molti punti <strong>non sono altrettanti forward del modello</strong>. Servono a descrivere la relazione tra timeline e sigma e, per alcuni scheduler, a fornire i livelli da cui scegliere i punti effettivi di sampling.</p>

<p>Vedremo tra poco che il <em>sigma shift</em> interviene proprio sulla funzione <code class="language-plaintext highlighter-rouge">f(t)</code>, deformando questa curva.</p>

<hr />

<h2 id="il-vero-costo-quante-volte-eseguiamo-il-modello">Il vero costo: quante volte eseguiamo il modello?</h2>

<p>Questo è uno dei concetti più importanti dell’intero discorso.</p>

<p>Supponiamo che la generazione usi 20 valutazioni del modello:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>sigma 1.00
    │
    ├── model forward
    ▼
sigma ...
    │
    ├── model forward
    ▼
sigma ...
    │
    ├── model forward
    ▼
   ...
    ▼
sigma 0.00
</code></pre></div></div>

<p>Ogni forward significa attraversare l’intero denoiser/Transformer con un latent che, soprattutto nel caso di un video, può essere enorme.</p>

<p>Per questo una prima approssimazione molto utile è:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>tempo di sampling ≈ NFE × costo di un forward
</code></pre></div></div>

<p>Una singola esecuzione del modello è una <strong>function evaluation (FE)</strong>, che nel nostro discorso coincide con un forward del denoiser. <strong>NFE</strong> significa invece <em>Number of Function Evaluations</em>: è il <strong>numero totale</strong> di FE richieste dalla generazione.</p>

<p>Quindi, per esempio:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>NFE = 20  →  il denoiser viene valutato 20 volte
</code></pre></div></div>

<p>Non sempre <code class="language-plaintext highlighter-rouge">steps = NFE</code>: alcuni sampler possono richiedere più di una FE per uno stesso step. Per confrontare davvero il costo di due strategie di sampling, quindi, <strong>NFE</strong> è più significativo del semplice numero di step mostrato nell’interfaccia.</p>

<p>A questo punto emerge il problema fondamentale:</p>

<blockquote>
  <p>La traiettoria ideale è continua, ma noi possiamo permetterci di interrogare il modello soltanto un numero limitato di volte.</p>
</blockquote>

<p>Se abbiamo un budget di 20, 8 o addirittura 4 forward, <strong>dove conviene farli? E come usiamo le predizioni ottenute per muoverci da un punto al successivo?</strong></p>

<p>Sono esattamente le domande a cui rispondono scheduler e sampler.</p>

<hr />

<h2 id="scheduler-dove-spendere-il-budget-di-calcolo">Scheduler: dove spendere il budget di calcolo</h2>

<p>Abbiamo ora due cose:</p>

<ol>
  <li>una relazione <code class="language-plaintext highlighter-rouge">t → sigma</code>, definita dal <em>model sampling</em>;</li>
  <li>un budget limitato di valutazioni del modello.</li>
</ol>

<p>Lo <strong>scheduler</strong> deve trasformare queste informazioni nella piccola sequenza di sigma che useremo davvero durante la generazione.</p>

<p>Supponiamo, per semplicità, che la relazione tra timeline e sigma fosse lineare e di voler fare pochi step. Potremmo ottenere una sequenza come:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>1.00 ─── 0.75 ─── 0.50 ─── 0.25 ─── 0.00
</code></pre></div></div>

<p>Ma non è affatto detto che distribuire le valutazioni in questo modo sia la scelta migliore. Potrebbe essere più utile concentrare i punti in una certa zona del percorso:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>1.00 ─ 0.96 ─ 0.87 ───── 0.55 ───────── 0.00
</code></pre></div></div>

<p>oppure fare quasi il contrario.</p>

<p>In ComfyUI, nomi come:</p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">simple</code></li>
  <li><code class="language-plaintext highlighter-rouge">karras</code></li>
  <li><code class="language-plaintext highlighter-rouge">exponential</code></li>
  <li><code class="language-plaintext highlighter-rouge">beta</code></li>
  <li><code class="language-plaintext highlighter-rouge">normal</code></li>
</ul>

<p>indicano strategie diverse per costruire questa sequenza.</p>

<p>L’output dello scheduler è quindi essenzialmente:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>sigma_0, sigma_1, sigma_2, ... sigma_n
</code></pre></div></div>

<p>Con <code class="language-plaintext highlighter-rouge">steps = 4</code>, per esempio, ci saranno normalmente quattro intervalli da percorrere e un sigma terminale pari a zero.</p>

<h3 id="cosa-significa-allora-simple">Cosa significa allora <code class="language-plaintext highlighter-rouge">simple</code>?</h3>

<p>Nel caso di ComfyUI il nome è molto letterale.</p>

<p>Lo scheduler <code class="language-plaintext highlighter-rouge">simple</code> guarda la <strong>griglia di riferimento dei sigma del modello</strong> che abbiamo appena introdotto e ne prende un certo numero di punti a intervalli approssimativamente regolari negli indici, aggiungendo poi <code class="language-plaintext highlighter-rouge">sigma = 0</code> come termine finale.</p>

<p>Quindi <code class="language-plaintext highlighter-rouge">simple</code> non significa che il processo di denoising nel suo complesso sia “semplice”, e soprattutto non ci dice ancora <strong>come</strong> verrà aggiornato il latent tra un sigma e il successivo.</p>

<p>Dice soltanto, in sostanza:</p>

<blockquote>
  <p>“Dato il numero di step richiesto, scegli in modo semplice i livelli di sigma ai quali faremo le valutazioni.”</p>
</blockquote>

<p>Altri scheduler costruiscono la sequenza con criteri differenti. Karras ed exponential, per esempio, distribuiscono i sigma secondo specifiche trasformazioni matematiche del range; <code class="language-plaintext highlighter-rouge">beta</code> privilegia certe regioni della griglia secondo una distribuzione beta; <code class="language-plaintext highlighter-rouge">normal</code> lavora sulla timeline del modello e la riconverte in sigma.</p>

<p>Per il momento ci basta il principio generale:</p>

<blockquote>
  <p><strong>lo scheduler decide dove, lungo la traiettoria, spendere le nostre FE.</strong></p>
</blockquote>

<p>Non abbiamo ancora stabilito come usare la predizione ottenuta in quei punti per arrivare al successivo. Quello sarà il compito del sampler.</p>

<hr />

<h2 id="sigma-shift-cambiare-la-geometria-della-timeline">Sigma shift: cambiare la geometria della timeline</h2>

<p>A complicare — o rendere più interessante — il quadro c’è il <strong>sigma shift</strong>.</p>

<p>Ora possiamo descriverlo in modo più preciso: lo shift interviene sulla relazione <code class="language-plaintext highlighter-rouge">sigma = f(t)</code> che abbiamo introdotto prima. <strong>Non sceglie gli step</strong>; modifica il valore di sigma associato ai diversi punti della timeline.</p>

<p>Nel caso del flow sampling usato da H3 in ComfyUI, la trasformazione ha la forma:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>sigma(t) = shift × t / (1 + (shift - 1) × t)
</code></pre></div></div>

<p>Con <code class="language-plaintext highlighter-rouge">shift = 1</code> la relazione è lineare: <code class="language-plaintext highlighter-rouge">sigma = t</code>. Aumentando lo shift, gran parte della timeline viene invece mappata verso sigma più alti.</p>

<p>Possiamo quindi immaginare la catena così:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>timeline t
      │
      │  model sampling + sigma shift
      ▼
relazione / curva t → sigma
      │
      │  discretizzata nella griglia di riferimento
      ▼
   scheduler
      │
      ▼
pochi sigma effettivamente usati
</code></pre></div></div>

<p>Uno shift forte può far sì che molti punti della timeline corrispondano ancora a sigma relativamente alti. Per esempio, in un modello con shift elevato, una sequenza apparentemente uniforme sulla timeline può produrre valori del tipo:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>1.000 → 0.973 → 0.923 → 0.800 → 0.000
</code></pre></div></div>

<p>anziché:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>1.000 → 0.750 → 0.500 → 0.250 → 0.000
</code></pre></div></div>

<p>Il concetto importante non è il valore specifico: è che <strong>la relazione tra “posizione nello step” e livello di rumore non deve essere necessariamente lineare</strong>.</p>

<p>Scheduler e sigma shift sono quindi concettualmente vicini: entrambi influenzano <em>dove</em> vengono spese le valutazioni del modello. Non sono però equivalenti.</p>

<p>Il sigma shift fa parte della parametrizzazione della curva di sampling del modello; lo scheduler decide come campionare un numero finito di punti su quella curva.</p>

<p>Ed entrambi possono contribuire allo stesso obiettivo pratico: usare meglio ogni costosa valutazione del denoiser.</p>

<hr />

<h2 id="sampler-come-ci-muoviamo-tra-due-punti">Sampler: come ci muoviamo tra due punti</h2>

<p>Ora abbiamo una sequenza:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>sigma_0 → sigma_1 → sigma_2 → ... → 0
</code></pre></div></div>

<p>A ciascun punto chiediamo al modello una direzione.</p>

<p>Resta però da decidere <strong>come usare quella direzione per aggiornare il latent</strong>.</p>

<p>Questo è il compito del <strong>sampler</strong>, o più precisamente del solver numerico.</p>

<h3 id="euler-segui-la-direzione-corrente">Euler: segui la direzione corrente</h3>

<p>Il caso più intuitivo è Euler.</p>

<p>Il modello dice:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>sei qui ● ─────────► vai in questa direzione
</code></pre></div></div>

<p>e il sampler compie un passo verso il sigma successivo usando quella previsione.</p>

<p>In forma concettuale:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>prediction = model(x, sigma)
x_next = x + prediction × step_size
</code></pre></div></div>

<p>È semplice ed economico: tipicamente una valutazione del modello per ogni intervallo.</p>

<p>Il limite è altrettanto intuitivo. Se la traiettoria curva molto, una direzione misurata nel punto di partenza diventa meno accurata quanto più grande è il passo.</p>

<h3 id="heun-e-i-metodi-che-verificano-la-traiettoria">Heun e i metodi che verificano la traiettoria</h3>

<p>Un metodo di ordine superiore può fare qualcosa del genere:</p>

<ol>
  <li>chiede al modello la direzione corrente;</li>
  <li>calcola dove arriverebbe;</li>
  <li>interroga nuovamente il modello nel punto stimato;</li>
  <li>combina le due predizioni per ottenere un aggiornamento migliore.</li>
</ol>

<p>Il risultato numerico può essere più accurato, ma abbiamo pagato due forward invece di uno.</p>

<p>Questo evidenzia perché <strong>contare soltanto gli step può essere fuorviante</strong>.</p>

<h3 id="multistep-ricordarsi-il-passato">Multistep: ricordarsi il passato</h3>

<p>I metodi <em>multistep</em> adottano una strategia particolarmente interessante per i grandi modelli generativi.</p>

<p>Invece di interrogare più volte il denoiser nello stesso intervallo, conservano le predizioni ottenute negli step precedenti:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>sigma A → prediction A
sigma B → prediction B
sigma C → prediction C
</code></pre></div></div>

<p>e usano questa storia per stimare meglio come sta cambiando la traiettoria.</p>

<p>L’obiettivo è ottenere un’integrazione più accurata senza necessariamente raddoppiare il numero di costosi forward.</p>

<p>Questo è il principio che rende sampler multistep particolarmente interessanti quando il denoiser è enorme: <strong>ottenere più valore da ogni singola FE</strong>.</p>

<hr />

<h2 id="dpm-ancestral-sde-perché-esistono-così-tanti-sampler">DPM++, ancestral, SDE: perché esistono così tanti sampler?</h2>

<p>Le dropdown di ComfyUI possono diventare rapidamente intimidatorie:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>euler
euler_ancestral
heun
dpmpp_2m
dpmpp_2m_sde
dpmpp_3m_sde
res_multistep
...
</code></pre></div></div>

<p>Non sono semplicemente varianti “più o meno buone” dello stesso algoritmo.</p>

<p>Cambiano diverse proprietà:</p>

<ul>
  <li>l’ordine del solver;</li>
  <li>il fatto che sia single-step o multistep;</li>
  <li>quante valutazioni del modello richieda;</li>
  <li>se il processo sia deterministico;</li>
  <li>se venga reintrodotta stocasticità durante il sampling;</li>
  <li>come vengano trattate le predizioni precedenti.</li>
</ul>

<p>Un sampler <em>ancestral</em> o SDE, per esempio, può reintrodurre rumore durante il percorso. Questo può essere utile per varietà e texture, ma per un video la stocasticità deve fare i conti anche con la coerenza temporale.</p>

<p>Non esiste quindi “il sampler migliore” in assoluto.</p>

<p>Esiste un sampler più o meno adatto a:</p>

<ul>
  <li>quel modello;</li>
  <li>quello scheduler;</li>
  <li>quel numero di step;</li>
  <li>quel tipo di contenuto;</li>
  <li>il compromesso qualità/tempo che vogliamo ottenere.</li>
</ul>

<hr />

<h2 id="ridurre-gli-step-perché-non-basta-semplicemente-scrivere-4">Ridurre gli step: perché non basta semplicemente scrivere 4</h2>

<p>A questo punto potrebbe sembrare che la soluzione sia banale: se 20 forward costano troppo, impostiamo <code class="language-plaintext highlighter-rouge">steps = 4</code>.</p>

<p>Il problema è che con quattro valutazioni i salti diventano enormi.</p>

<p>Immaginiamo una traiettoria curva:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>traiettoria corretta

A ●
    \
     \
      ●
       \
        \____ ● B
</code></pre></div></div>

<p>Con tanti step piccoli una previsione locale leggermente imprecisa viene presto corretta dalla chiamata successiva.</p>

<p>Con quattro step, invece, potremmo chiedere al modello di fare qualcosa del genere:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>A ● ───────────────────────► B'
</code></pre></div></div>

<p>Una piccola imprecisione nella direzione iniziale produce un errore molto più grande alla fine del salto.</p>

<p>Scheduler e sampler possono aiutarci a scegliere punti migliori e integrarli meglio, ma a un certo punto emerge un limite: <strong>il modello stesso non è stato necessariamente addestrato per lavorare bene con una discretizzazione così aggressiva</strong>.</p>

<p>È qui che entrano in gioco i low-step LoRA.</p>

<hr />

<h2 id="low-step-lora-questa-volta-cambiamo-il-modello">Low-step LoRA: questa volta cambiamo il modello</h2>

<p>Un <strong>LoRA</strong> modifica il comportamento del modello aggiungendo adattamenti a basso rango ai suoi pesi. È un meccanismo molto più leggero rispetto alla distribuzione di un checkpoint completo.</p>

<p>Nel caso dei LoRA per <em>few-step inference</em>, l’obiettivo non è cambiare lo stile del video o insegnare un nuovo personaggio. L’obiettivo è modificare il denoiser affinché produca predizioni utili <strong>quando il sampling usa pochissimi step</strong>.</p>

<p>Il contrasto con scheduler e sampler è importante.</p>

<p>Scheduler:</p>

<blockquote>
  <p><strong>Dove</strong> interrogo il modello?</p>
</blockquote>

<p>Sampler:</p>

<blockquote>
  <p><strong>Come</strong> uso le sue predizioni per muovermi?</p>
</blockquote>

<p>Low-step LoRA:</p>

<blockquote>
  <p>Come modifico <strong>il modello stesso</strong> perché le sue predizioni restino buone quando lo interrogo molto meno spesso?</p>
</blockquote>

<p>Un LoRA di questo tipo viene tipicamente addestrato o distillato per uno specifico regime few-step. Per questo spesso arriva accompagnato da indicazioni precise sul numero di step, sullo scheduler e sul sampler da utilizzare.</p>

<p>Non è un generico interruttore “turbo”.</p>

<p>Se un LoRA è stato ottimizzato, per esempio, per una certa sequenza di quattro sigma, cambiare arbitrariamente scheduler significa chiedere al modello di lavorare fuori dalla configurazione per la quale è stato adattato.</p>

<p>Questa è una differenza importante rispetto a una normale ottimizzazione implementativa: <strong>qui qualità e velocità vengono scambiate già durante l’addestramento/adattamento del modello</strong>.</p>

<hr />

<h2 id="un-workflow-reale-minimax-h3-in-comfyui">Un workflow reale: MiniMax H3 in ComfyUI</h2>

<p>Ed eccoci finalmente al motivo per cui H3 è un esempio così utile.</p>

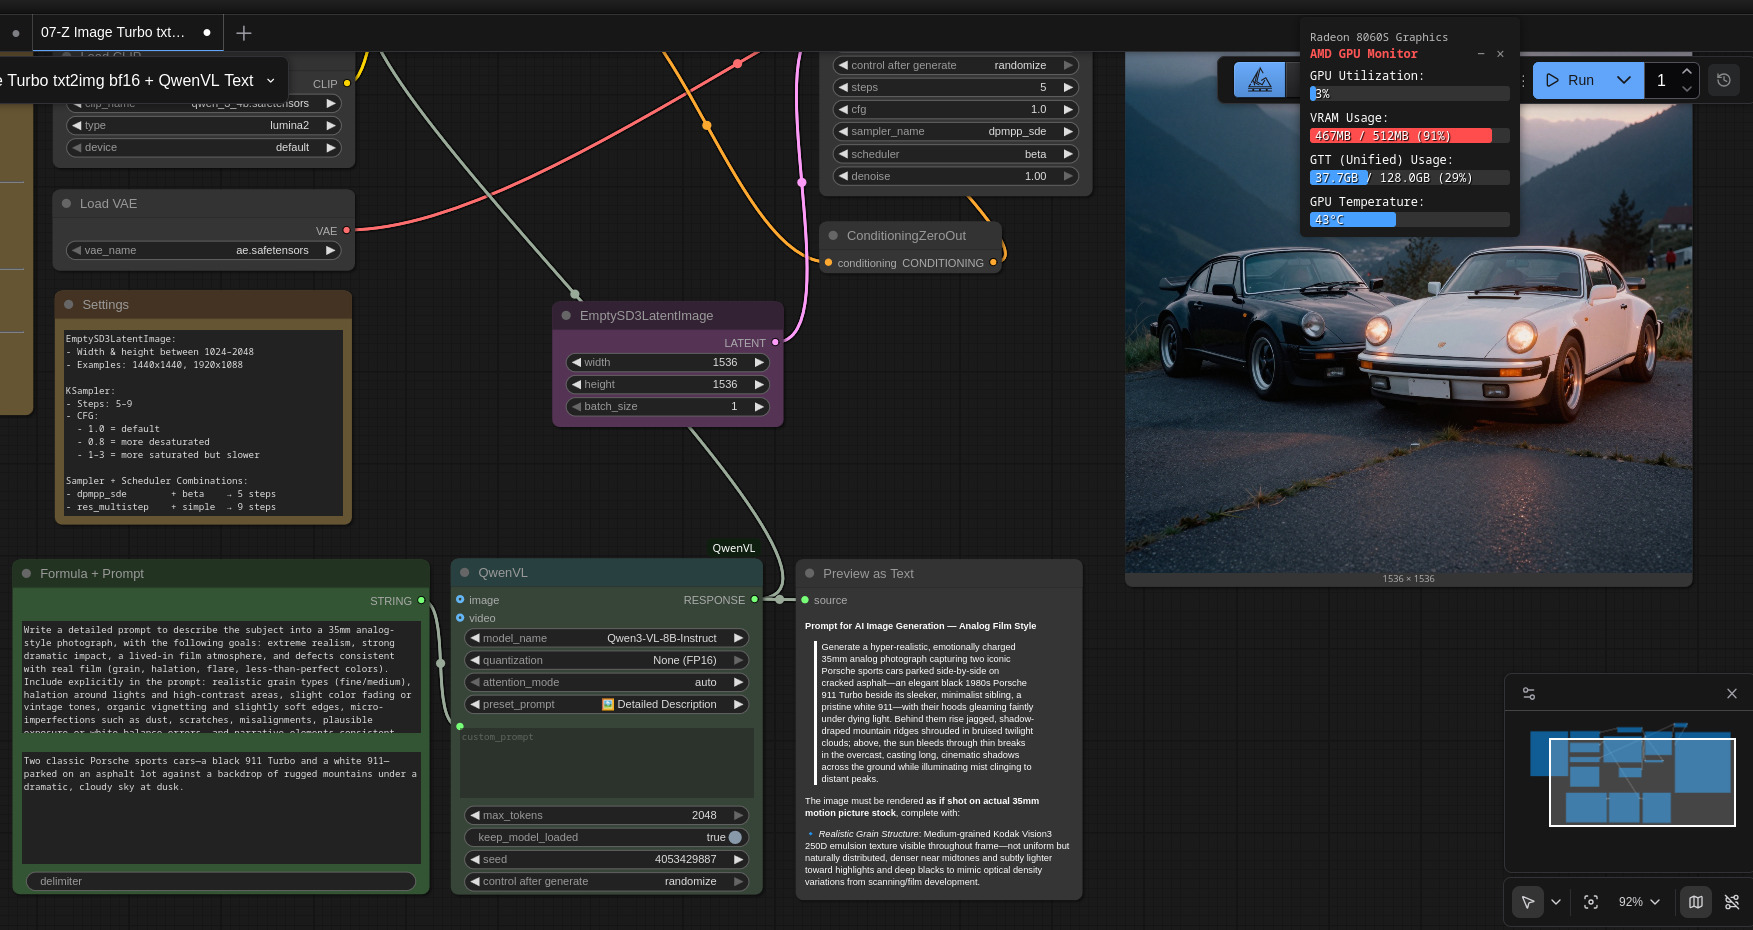
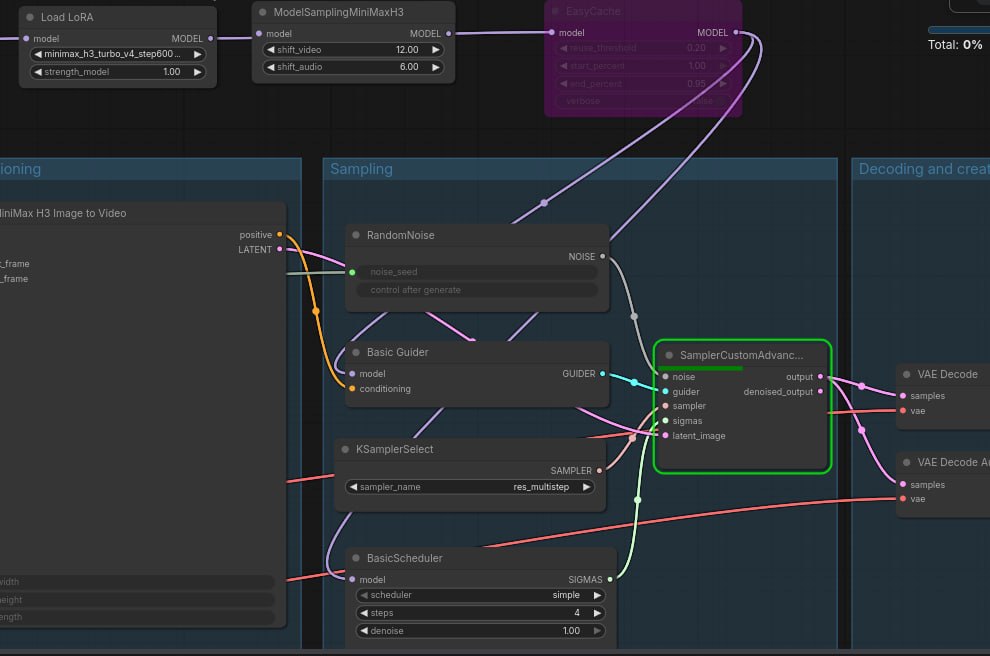
<p>Un workflow ComfyUI per H3 con un Turbo LoRA può contenere contemporaneamente questi blocchi:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Load LoRA
    │
    ▼
ModelSamplingMiniMaxH3
sigma shift
    │
    ▼
BasicScheduler
scheduler = simple
steps = 4
    │
    │ produce i sigma
    ▼
SamplerCustomAdvanced ◄──── KSamplerSelect
                          res_multistep
</code></pre></div></div>

<figure class=""><img src="/assets/images/sampler-scheduler-low-step-lora/comfyui-workflow.jpg" alt="Workflow ComfyUI per MiniMax H3 con Turbo LoRA" /><figcaption>
      Un workflow ComfyUI per MiniMax H3 con Turbo LoRA: model sampling, scheduler, sampler e campionatore avanzato cooperano per generare in soli 4 step.

    </figcaption></figure>

<p>A prima vista può sembrare che <code class="language-plaintext highlighter-rouge">simple</code>, <code class="language-plaintext highlighter-rouge">res_multistep</code>, <code class="language-plaintext highlighter-rouge">sigma shift</code> e <code class="language-plaintext highlighter-rouge">4 steps</code> siano quattro modi diversi di controllare la stessa cosa.</p>

<p>In realtà sono quattro pezzi distinti che cooperano.</p>

<h3 id="1-il-turbo-lora">1. Il Turbo LoRA</h3>

<p>Modifica H3 affinché possa lavorare in un regime few-step.</p>

<h3 id="2-modelsamplingminimaxh3">2. <code class="language-plaintext highlighter-rouge">ModelSamplingMiniMaxH3</code></h3>

<p>Imposta la particolare relazione tra timeline e sigma utilizzata dal modello. H3 gestisce inoltre video e audio su schedule differenti, pur generandoli congiuntamente.</p>

<h3 id="3-basicscheduler-simple">3. <code class="language-plaintext highlighter-rouge">BasicScheduler: simple</code></h3>

<p>Prende la curva dei sigma risultante e seleziona i punti da utilizzare per i quattro step.</p>

<p>Il risultato non è necessariamente una sequenza lineare di sigma: <code class="language-plaintext highlighter-rouge">simple</code> lavora sulla griglia del modello, che è già stata deformata dal sigma shift.</p>

<h3 id="4-ksamplerselect-res_multistep">4. <code class="language-plaintext highlighter-rouge">KSamplerSelect: res_multistep</code></h3>

<p>Non produce sigma.</p>

<p>Riceve i sigma scelti dallo scheduler e decide come integrare il percorso tra un punto e l’altro, utilizzando anche informazioni provenienti dalle predizioni precedenti.</p>

<p>Infine <code class="language-plaintext highlighter-rouge">SamplerCustomAdvanced</code> mette insieme:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>noise iniziale
conditioning
modello
sampler
lista dei sigma
</code></pre></div></div>

<p>ed esegue effettivamente il loop.</p>

<p>Visto così, il workflow smette di essere una collezione di dropdown misteriose e diventa la rappresentazione esplicita di un algoritmo numerico.</p>

<hr />

<h2 id="tre-modi-diversi-di-rendere-più-veloce-la-generazione">Tre modi diversi di rendere più veloce la generazione</h2>

<p>A questo punto possiamo organizzare le ottimizzazioni in modo abbastanza pulito.</p>

<h3 id="1-ridurre-il-costo-di-ogni-forward">1. Ridurre il costo di ogni forward</h3>

<p>Per esempio:</p>

<ul>
  <li>ridurre risoluzione;</li>
  <li>ridurre il numero di frame;</li>
  <li>quantizzare i pesi;</li>
  <li>usare kernel di attention più efficienti;</li>
  <li>sfruttare sparse attention;</li>
  <li>migliorare l’implementazione hardware.</li>
</ul>

<p>In questo caso:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>NFE invariato
×
forward più economico
=
generazione più veloce
</code></pre></div></div>

<h3 id="2-fare-meno-forward">2. Fare meno forward</h3>

<p>È il territorio dei modelli few-step e dei low-step LoRA:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>NFE: 20 → 8 → 4
</code></pre></div></div>

<p>Se il costo del denoiser domina il tempo totale, la riduzione può essere enorme.</p>

<h3 id="3-ottenere-più-valore-da-ogni-forward">3. Ottenere più valore da ogni forward</h3>

<p>Qui entrano scheduler e sampler.</p>

<p>Un migliore posizionamento dei sigma e un solver più adatto possono produrre:</p>

<ul>
  <li>più qualità a parità di NFE;</li>
  <li>qualità simile riducendo NFE.</li>
</ul>

<p>Ed è per questo che qualità e velocità non sono problemi separati.</p>

<hr />

<h2 id="lobiettivo-vero-quality-per-compute">L’obiettivo vero: quality per compute</h2>

<p>Dire “questo sampler è più veloce” è spesso una semplificazione sbagliata.</p>

<p>Se due sampler hanno entrambi <code class="language-plaintext highlighter-rouge">NFE = 20</code>, il tempo trascorso nel denoiser sarà grossomodo simile. Uno dei due potrebbe però produrre una qualità migliore.</p>

<p>A quel punto potremmo scoprire che con il sampler migliore basta <code class="language-plaintext highlighter-rouge">NFE = 12</code> per raggiungere la qualità che l’altro otteneva con <code class="language-plaintext highlighter-rouge">NFE = 20</code>.</p>

<p><strong>È lì che nasce il vero speed-up.</strong></p>

<p>Lo stesso ragionamento vale per uno scheduler.</p>

<p>E per un low-step LoRA il concetto viene spinto ancora oltre: adattiamo il modello affinché possa estrarre molto più risultato da pochissime valutazioni.</p>

<p>La metrica mentale più utile diventa quindi qualcosa del tipo:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>                qualità ottenuta
efficienza = ───────────────────────
              compute necessario
</code></pre></div></div>

<p>Non stiamo cercando semplicemente di rendere il timer più piccolo. Stiamo cercando di ottenere il miglior risultato possibile per una quantità limitata di compute.</p>

<hr />

<h2 id="quattro-step-non-significano-automaticamente-cinque-volte-più-veloce">Quattro step non significano automaticamente cinque volte più veloce</h2>

<p>C’è però un’ultima precisazione importante.</p>

<p>Se il sampling passa da <code class="language-plaintext highlighter-rouge">NFE = 20</code> a <code class="language-plaintext highlighter-rouge">NFE = 4</code>, <strong>la parte di denoising</strong> può teoricamente avvicinarsi a un’accelerazione di 5×.</p>

<p>Ma la pipeline completa comprende anche:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>text / vision encoding
conditioning
preparazione dei latent
sampling
VAE video decode
VAE audio decode
encoding/mux del video finale
</code></pre></div></div>

<p>Questi costi non scompaiono riducendo gli step.</p>

<p>Quindi:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>tempo totale =
    costi fissi
  + NFE × costo_forward
  + decoding/output
</code></pre></div></div>

<p>Più il denoiser domina il runtime, più la riduzione di NFE si avvicina allo speed-up teorico. Più sono importanti encoder e VAE, meno il guadagno complessivo sarà proporzionale.</p>

<p>Anche questo è un motivo per cui, parlando di performance, è utile distinguere <strong>sampling time</strong> e <strong>end-to-end generation time</strong>.</p>

<hr />

<h2 id="il-valore-di-poter-vedere-il-workflow">Il valore di poter vedere il workflow</h2>

<p>Ed è qui che torniamo, solo alla fine, all’apertura del modello.</p>

<p>Se utilizziamo un generatore video esclusivamente attraverso un’API, vediamo qualcosa di molto semplice:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>prompt → video
</code></pre></div></div>

<p>Il provider può utilizzare internamente distillazione, scheduler particolari, solver proprietari, caching, sparse attention o qualsiasi altra ottimizzazione. Per noi il processo rimane una scatola nera.</p>

<p>Con pesi eseguibili localmente e strumenti modulari come ComfyUI vediamo invece:</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>conditioning
     ↓
model sampling
     ↓
scheduler
     ↓
sampler
     ↓
latent
     ↓
VAE
</code></pre></div></div>

<p>E possiamo intervenire.</p>

<p>Non perché ogni utente debba inventarsi un nuovo solver numerico, ma perché la possibilità di osservare e modificare il workflow rende molto più facile <strong>capire cosa sta realmente succedendo</strong>.</p>

<p>H3 è semplicemente l’esempio del momento. La community ha avuto accesso al modello, ComfyUI ha reso visibili i pezzi della pipeline e nel giro di pochi giorni sono partiti gli esperimenti: nuovi workflow, quantizzazioni, few-step LoRA, scheduler e sampler alternativi.</p>

<p>Ed è proprio questo il punto più interessante.</p>

<p>L’AI aperta non significa soltanto poter scaricare un file molto grande invece di chiamare un’API.</p>

<p>Significa anche poter aprire il cofano, seguire i cavi e scoprire che dietro un apparentemente banale pulsante <strong>Generate</strong> c’è un problema molto concreto di calcolo numerico:</p>

<blockquote>
  <p>abbiamo una traiettoria continua, un numero limitato di costose valutazioni del modello e dobbiamo decidere <strong>dove farle, come usarle e quanto possiamo permetterci di distanziarle</strong>.</p>
</blockquote>

<p>Una volta capito questo, <code class="language-plaintext highlighter-rouge">simple</code>, <code class="language-plaintext highlighter-rouge">Karras</code>, <code class="language-plaintext highlighter-rouge">res_multistep</code>, <code class="language-plaintext highlighter-rouge">4 steps</code> e <code class="language-plaintext highlighter-rouge">Turbo LoRA</code> smettono di sembrare formule magiche.</p>

<p>Sono semplicemente strumenti diversi per rispondere a quelle tre domande.</p>

<hr />

<h2 id="riferimenti-e-approfondimenti">Riferimenti e approfondimenti</h2>

<ul>
  <li><a href="https://www.minimax.io/news/minimax-h3-open-source">MiniMax — MiniMax H3 open-source announcement</a></li>
  <li><a href="https://github.com/MiniMax-AI/MiniMax-H3">MiniMax H3 — repository ufficiale</a></li>
  <li><a href="https://docs.comfy.org/tutorials/video/minimax/minimax-h3">ComfyUI — workflow MiniMax H3</a></li>
  <li><a href="https://arxiv.org/abs/2210.02747">Flow Matching for Generative Modeling — Lipman et al.</a></li>
  <li><a href="https://github.com/Comfy-Org/ComfyUI/blob/master/comfy/samplers.py">ComfyUI — implementazione degli scheduler</a></li>
  <li><a href="https://github.com/Comfy-Org/ComfyUI/blob/master/comfy_extras/nodes_minimax_h3.py">ComfyUI — nodi MiniMax H3 e sigma shift</a></li>
  <li><a href="https://huggingface.co/larryvrh/MiniMax-H3-Turbo-Lora">MiniMax H3 Turbo LoRA — esempio community few-step</a></li>
</ul>]]></content><author><name>Alessio Soldano</name></author><category term="AI locale" /><category term="generative AI" /><category term="ComfyUI" /><category term="MiniMax H3" /><category term="flow matching" /><category term="LoRA" /><category term="sampler" /><category term="scheduler" /><summary type="html"><![CDATA[Quando un modello generativo può essere eseguito localmente, diventa possibile guardare dentro il processo di generazione. Vediamo cosa significano davvero scheduler, sampler, sigma shift, steps e low-step LoRA in una pipeline moderna come MiniMax H3.]]></summary></entry><entry><title type="html">SWE-bench Pro in locale: misurare davvero i coding agent senza farsi ingannare dai benchmark</title><link href="https://aladinodigitale.it/2026/05/31/swe-bench-pro-local.html" rel="alternate" type="text/html" title="SWE-bench Pro in locale: misurare davvero i coding agent senza farsi ingannare dai benchmark" /><published>2026-05-31T00:00:00+00:00</published><updated>2026-05-31T00:00:00+00:00</updated><id>https://aladinodigitale.it/2026/05/31/swe-bench-pro-local</id><content type="html" xml:base="https://aladinodigitale.it/2026/05/31/swe-bench-pro-local.html"><![CDATA[<p>Negli ultimi mesi sto esplorando i limiti e le problematiche relative all’utilizzo di modelli locali per attività di coding agent. Non parlo solo di completamento del codice, ma di strumenti che leggono una codebase, eseguono comandi, modificano file, lanciano test e provano a risolvere un problema in autonomia.</p>

<p>A quel punto la domanda diventa inevitabile: <strong>come si misura davvero la qualità di un modello in questo scenario?</strong></p>

<p>I benchmark classici sui modelli di linguaggio aiutano fino a un certo punto. Sapere che un modello è forte su HumanEval, MMLU, GPQA o su un generico “coding score” è interessante, ma dice poco su quello che succede quando lo metti dentro un agente, gli dai una issue reale, un repository non banale, una shell, dei test e gli chiedi di produrre una patch funzionante.</p>

<p>Per questo i benchmark della famiglia SWE-bench sono diventati così importanti. E per questo mi sono messo a guardare con attenzione <a href="https://labs.scale.com/leaderboard/swe_bench_pro_public"><strong>SWE-bench Pro</strong></a>.</p>

<p>Non tanto per pubblicare un numero da leaderboard, ma per rispondere a una domanda molto più pratica:</p>

<blockquote>
  <p>Se eseguo lo stesso modello in locale con quantizzazioni diverse, quanto cambia davvero la capacità di risolvere task di coding agent?</p>
</blockquote>

<p>Questo post è il primo pezzo del percorso. Racconta cos’è SWE-bench Pro, perché esiste, quali problemi prova a risolvere rispetto ai benchmark precedenti, e cosa significa provare a eseguirlo in locale.</p>

<p>I risultati veri arriveranno probabilmente più avanti, per ora proviamo a costruire un metodo.</p>

<hr />

<h2 id="perché-serve-un-altro-benchmark">Perché serve un altro benchmark</h2>

<p>SWE-bench nasce con un’idea molto semplice e molto potente: prendere issue reali da repository GitHub reali e chiedere a un modello di generare una patch che risolva il problema.</p>

<p>Non quindi:</p>

<ul>
  <li>scrivere una funzione isolata;</li>
  <li>completare poche righe di codice;</li>
  <li>rispondere a una domanda teorica;</li>
  <li>scegliere tra quattro opzioni.</li>
</ul>

<p>Ma lavorare su una codebase vera.</p>

<p>In un task di SWE-bench il modello riceve una descrizione del problema, ha accesso al repository, deve modificare i file corretti e alla fine viene valutato eseguendo una suite di test. Se i test che prima fallivano passano e quelli che già passavano continuano a passare, la patch viene considerata corretta.</p>

<p>Questo è molto più vicino a quello che ci interessa quando parliamo di coding agent.</p>

<p>Il problema è che i benchmark, quando diventano popolari, iniziano anche a saturarsi.</p>

<p>Saturazione significa almeno tre cose:</p>

<ol>
  <li>i modelli migliorano davvero e risolvono sempre più casi;</li>
  <li>gli strumenti attorno ai modelli vengono ottimizzati specificamente per quel benchmark;</li>
  <li>i task pubblici finiscono in dataset, esempi, discussioni, traiettorie, post, repository e materiale di training.</li>
</ol>

<p>A quel punto diventa difficile capire quanto uno score misuri davvero capacità generale e quanto invece misuri familiarità, ottimizzazione sul benchmark o, nei casi peggiori, contaminazione.</p>

<p>Questo è diventato particolarmente evidente con SWE-bench Verified. Verified nasceva come subset più pulito e umanamente verificato di SWE-bench, composto da 500 problemi considerati risolvibili da sviluppatori reali. Per un certo periodo è stato uno dei riferimenti principali per confrontare modelli e agenti.</p>

<p>Poi però il benchmark è diventato talmente centrale da essere sempre meno informativo. Se i casi sono pubblici, discussi, riutilizzati e magari inclusi indirettamente nei dati di training, il numero finale continua a essere interessante, ma va letto con cautela.</p>

<p>SWE-bench Pro nasce anche da qui: dalla necessità di avere task più realistici, più lunghi, più vari e meno facilmente saturabili.</p>

<hr />

<h2 id="cosè-swe-bench-pro">Cos’è SWE-bench Pro</h2>

<p>SWE-bench Pro è un benchmark per valutare coding agent su task software di maggiore complessità rispetto a SWE-bench classico e Verified.</p>

<p>La differenza non è solo quantitativa, ma qualitativa. L’obiettivo è avvicinarsi di più a problemi da sviluppo software reale: codebase più complesse, linguaggi diversi, task più lunghi, modifiche che coinvolgono più file e patch meno banali.</p>

<p>La struttura del benchmark è divisa in tre insiemi principali:</p>

<ul>
  <li><strong>Public set</strong>: 731 task pubblici, rilasciati su Hugging Face;</li>
  <li><strong>Commercial set</strong>: 276 task provenienti da repository proprietari di startup partner, non rilasciati pubblicamente;</li>
  <li><strong>Held-out set</strong>: 858 task tenuti privati, pensati per misurare overfitting e generalizzazione futura.</li>
</ul>

<p>Questa divisione è importante.</p>

<p>Il public set è quello che possiamo scaricare ed eseguire localmente. È utilissimo per esperimenti riproducibili, confronti tra configurazioni, studio degli errori e analisi metodologiche.</p>

<p>Ma proprio perché è pubblico non può essere considerato completamente immune alla contaminazione.</p>

<p>Il commercial set e l’held-out set servono invece a preservare una parte del benchmark fuori dalla portata diretta di training, tuning e ottimizzazioni pubbliche. Sono più adatti a misurazioni “da leaderboard” o a confronti controllati, ma non sono eseguibili liberamente in locale.</p>

<p>Quindi la prima cosa da chiarire è questa:</p>

<blockquote>
  <p>Eseguire i 731 casi pubblici di SWE-bench Pro è utile, ma non equivale a eseguire il benchmark privato completo.</p>
</blockquote>

<p>Non è un dettaglio. È il tipo di distinzione che può cambiare completamente il significato di uno score.</p>

<hr />

<h2 id="contaminazione-il-problema-non-sparisce">Contaminazione: il problema non sparisce</h2>

<p>SWE-bench Pro è stato progettato anche per ridurre il rischio di contaminazione. Ad esempio, i subset open source usano repository con licenze copyleft forti, mentre il subset commerciale contiene codice proprietario non rilasciato pubblicamente.</p>

<p>Questo aiuta, ma non rende magico il public set.</p>

<p>Se un task è pubblico, allora in linea di principio può finire:</p>

<ul>
  <li>nei dati di training;</li>
  <li>in issue e discussioni online;</li>
  <li>in repository di esperimenti;</li>
  <li>in log di agenti pubblicati;</li>
  <li>in post tecnici;</li>
  <li>in dataset derivati;</li>
  <li>in patch usate per esempi e tutorial.</li>
</ul>

<p>Quindi, se un modello ottiene un buon risultato sul public set, non possiamo automaticamente dire: “ecco la sua capacità su problemi mai visti”.</p>

<p>Però questo non significa che il public set sia inutile. Dipende dalla domanda.</p>

<p>Se voglio confrontare in assoluto due modelli frontier e dichiarare chi sia migliore in generale, la contaminazione è un problema serio.</p>

<p>Se invece voglio confrontare <strong>lo stesso modello</strong> in più quantizzazioni, sullo stesso hardware, con lo stesso agente, lo stesso prompt e lo stesso subset di task, allora il public set può essere estremamente utile.</p>

<p>In quel caso non sto cercando di misurare la capacità assoluta del modello nel mondo. Sto cercando di misurare una variazione relativa:</p>

<blockquote>
  <p>quanto degrada il comportamento agentico passando, ad esempio, da una quantizzazione più conservativa a una più aggressiva?</p>
</blockquote>

<p>È una domanda molto pratica. Ed è esattamente il tipo di domanda che mi interessa per l’AI locale.</p>

<hr />

<h2 id="quando-un-task-si-considera-passato">Quando un task si considera passato</h2>

<p>Il funzionamento di base è questo.</p>

<p>Per ogni istanza del benchmark esiste:</p>

<ul>
  <li>una descrizione del problema;</li>
  <li>un repository in uno specifico stato iniziale;</li>
  <li>una patch “gold”, cioè la soluzione attesa o di riferimento;</li>
  <li>una serie di test che devono passare dopo la correzione.</li>
</ul>

<p>Il modello non deve produrre una spiegazione. Deve produrre una patch.</p>

<p>L’evaluator applica la patch al repository e lancia i test selezionati. In genere si distinguono due categorie:</p>

<ul>
  <li><strong>fail-to-pass</strong>: test che prima fallivano e che devono passare dopo la patch;</li>
  <li><strong>pass-to-pass</strong>: test che già passavano e devono continuare a passare.</li>
</ul>

<p>Una patch è considerata corretta solo se risolve il problema senza rompere il comportamento già esistente.</p>

<p>Questo è il punto che rende SWE-bench interessante. Non basta che la patch “sembri sensata”. Non basta che il modello spieghi bene cosa voleva fare. Non basta nemmeno che modifichi il file giusto.</p>

<p>Alla fine contano i test.</p>

<p>Naturalmente anche qui bisogna stare attenti: la qualità del benchmark dipende dalla qualità dei test. Se i test sono deboli, una patch può passare pur essendo concettualmente sbagliata. Se i test sono fragili o troppo legati all’ambiente, una patch corretta può fallire. Per questo l’esecuzione locale del benchmark non è soltanto “lancio un comando e leggo una percentuale”: richiede attenzione metodologica.</p>

<hr />

<h2 id="quanti-test-quante-ripetizioni-quale-score">Quanti test, quante ripetizioni, quale score?</h2>

<p>Una tentazione naturale sarebbe prendere i 731 task pubblici, lanciarli tutti una volta e leggere il risultato finale.</p>

<p>È un punto di partenza, ma non basta sempre.</p>

<p>Ci sono almeno quattro aspetti da considerare.</p>

<h3 id="1-il-subset">1. Il subset</h3>

<p>Se uso tutti i 731 casi pubblici, ottengo un numero più stabile, ma spendo molto tempo.</p>

<p>Se uso 10, 20 o 50 casi, posso iterare più velocemente, ma il risultato è molto più rumoroso.</p>

<p>Per fare debugging dell’infrastruttura bastano pochi casi. Per confrontare seriamente quantizzazioni diverse serve un subset più ampio, e possibilmente scelto con criterio: linguaggi diversi, repository diversi, patch di dimensioni diverse, task facili e task difficili.</p>

<h3 id="2-le-ripetizioni">2. Le ripetizioni</h3>

<p>I coding agent sono sistemi non deterministici. Anche a temperature bassa o zero possono esserci differenze dovute al backend, al parsing dei tool, al comportamento dell’agente, ai timeout e alla gestione dei comandi.</p>

<p>Una singola esecuzione può essere informativa, ma non racconta tutta la storia.</p>

<p>Per confronti seri avrebbe senso ripetere almeno alcuni task più volte, soprattutto se si vogliono confrontare modelli o quantizzazioni vicini tra loro.</p>

<h3 id="3-il-tipo-di-fallimento">3. Il tipo di fallimento</h3>

<p>Uno score finale dice poco.</p>

<p>È molto più utile classificare i fallimenti:</p>

<ul>
  <li>patch vuota;</li>
  <li>patch non applicabile;</li>
  <li>patch applicabile ma test falliti;</li>
  <li>timeout;</li>
  <li>errore nell’ambiente Docker;</li>
  <li>modello che modifica test o file non ammessi;</li>
  <li>agente che non riesce a interagire correttamente con il container;</li>
  <li>patch plausibile ma incompleta.</li>
</ul>

<p>Nel mio primo esperimento locale, ad esempio, una patch generata da Qwen3.6 35B A3B quantizzato non ha passato il task, ma questo è comunque stato utile: la patch era non vuota, si applicava, i test partivano e arrivavano a un risultato concreto. Questo significa che la pipeline stava finalmente misurando qualcosa di reale.</p>

<h3 id="4-il-tempo">4. Il tempo</h3>

<p>La validazione di una patch è una cosa. Generare la patch con un agente locale è un’altra.</p>

<p>La validazione con Docker può richiedere decine di secondi o minuti per istanza. La generazione della patch, invece, può richiedere molto di più, soprattutto se il modello locale è lento, il task è lungo e l’agente fa molti passaggi.</p>

<p>Quindi un esperimento completo non si pianifica solo contando i task. Si pianifica anche stimando:</p>

<ul>
  <li>tempo di generazione;</li>
  <li>tempo di validazione;</li>
  <li>spazio disco per immagini e output;</li>
  <li>parallelismo sostenibile;</li>
  <li>probabilità di timeout;</li>
  <li>costo di ripetere più run.</li>
</ul>

<hr />

<h2 id="perché-eseguire-swe-bench-pro-in-locale">Perché eseguire SWE-bench Pro in locale</h2>

<p>A questo punto uno potrebbe chiedersi: perché complicarsi la vita?</p>

<p>Se esistono leaderboard pubbliche, perché scaricare dataset, immagini Docker, agenti, modelli locali e mettersi a far girare tutto su una macchina consumer?</p>

<p>La risposta, nel mio caso, è semplice: <strong>perché le leaderboard non rispondono a tutte le domande pratiche</strong>.</p>

<p>A me interessa capire, ad esempio:</p>

<ul>
  <li>un modello locale quantizzato a 4 bit perde molto rispetto a 6 o 8 bit?</li>
  <li>un MoE piccolo-attivo ma grande-totale si comporta meglio o peggio di un denso più piccolo?</li>
  <li>un modello più lento ma più accurato conviene davvero in un workflow agentico?</li>
  <li>quanto impatta la dimensione del contesto?</li>
  <li>quanto la quantizzazione della KV-cache?</li>
  <li>quali errori fa il modello quando fallisce?</li>
  <li>il problema è la qualità del modello o l’infrastruttura attorno?</li>
</ul>

<p>Queste domande non si risolvono guardando un punteggio su Artificial Analysis o una tabella di benchmark pubblica.</p>

<p>Bisogna eseguire esperimenti controllati.</p>

<p>Nel mio caso il contesto è quello già discusso in altri post: un sistema basato su <strong>AMD Ryzen AI Max+ 395 (Strix Halo)</strong> con <strong>128 GB di memoria unificata</strong>, usato per inferenza locale con modelli openweight.</p>

<p>È una macchina interessante perché permette di caricare modelli relativamente grandi, ma costringe anche a fare i conti con compromessi reali: quantizzazione, velocità di prefill, velocità di generazione, memoria, backend, contesto, tool call, stabilità.</p>

<p>SWE-bench Pro diventa quindi un modo per spostare la domanda da:</p>

<blockquote>
  <p>quanti token al secondo fa questo modello?</p>
</blockquote>

<p>A:</p>

<blockquote>
  <p>questo modello, in questa configurazione, riesce davvero a portare a casa patch corrette su task realistici?</p>
</blockquote>

<p>Sono due domande molto diverse.</p>

<hr />

<h2 id="il-percorso-pratico-prima-validare-il-verificatore">Il percorso pratico: prima validare il verificatore</h2>

<p>Una volta scaricato il <a href="https://github.com/scaleapi/SWE-bench_Pro-os">progetto</a> del benchmark da GitHub, la prima cosa che ho fatto non è stata generare patch con un modello locale.</p>

<p>Prima ho voluto verificare che il sistema di valutazione funzionasse.</p>

<p>Per farlo ho usato le <strong>gold patch</strong>, cioè le patch ufficiali associate alle istanze del benchmark. L’idea è semplice: se applico la patch corretta e l’evaluator non la riconosce come corretta, il problema non è il modello. È il benchmark setup.</p>

<p>Ho quindi preparato:</p>

<ul>
  <li>il CSV con le istanze pubbliche;</li>
  <li>il JSON con le gold patch;</li>
  <li>subset piccoli da 1, 10 e poi 73 casi;</li>
  <li>l’esecuzione locale dell’evaluator con Docker.</li>
</ul>

<figure class=""><img src="/assets/images/swe-bench-pro-local/gold-patches.jpg" alt="" /><figcaption>
      Validazione delle gold patch tramite l’evaluator SWE-bench Pro.

    </figcaption></figure>

<p>Questo passaggio è stato fondamentale, perché ha fatto emergere subito problemi locali legati a disponibilità di spazio disco assegnato alla macchina virtuale, permessi e SELinux.</p>

<hr />

<h2 id="poi-generare-patch-con-un-modello-locale">Poi generare patch con un modello locale</h2>

<p>Per generare patch ho usato <a href="https://github.com/SWE-agent/mini-swe-agent"><strong>mini-swe-agent</strong></a>, collegato a un modello locale esposto tramite API compatibile OpenAI.</p>

<p>Il modello del primo esperimento è stato <strong>Qwen3.6 35B A3B</strong>, quantizzato a 6 bit (KV-cache a 8 bit), servito localmente tramite LM Studio. Non è una scelta pensata per battere una leaderboard. È una scelta utile per iniziare a testare una pipeline locale con un modello openweight realistico per il mio hardware.</p>

<figure class=""><img src="/assets/images/swe-bench-pro-local/gen-patches.jpg" alt="" /><figcaption>
      Generazione di patch con mini-swe-agent e un modello locale.

    </figcaption></figure>

<p>Anche qui, però, le cose non hanno funzionato al primo colpo e hanno richiesto migliorie allo script di esecuzione e file di configurazione per tool calling text-based, indicare il percorso corretto dove trovare le working directory nelle immagini Docker, …</p>

<hr />

<h2 id="il-primo-risultato-una-patch-vera-ma-non-corretta">Il primo risultato: una patch vera, ma non corretta</h2>

<p>Dopo questi aggiustamenti, la pipeline ha prodotto finalmente una patch non vuota.</p>

<p>Questo, da solo, era già un risultato.</p>

<p>La patch è stata convertita nel formato atteso dall’evaluator SWE-bench Pro e validata con lo stesso meccanismo usato per le gold patch.</p>

<p>Il task scelto era un caso NodeBB relativo alla gestione dello stato di validazione email nell’Admin Control Panel e nella logica di conferma.</p>

<p>La patch generata dal modello non ha passato il benchmark.</p>

<p>E non è sorprendente.</p>

<p>Il punto interessante è che non ha fallito per un problema infrastrutturale. La patch si applicava, i test partivano, NodeBB veniva avviato, e la suite selezionata arrivava a un risultato concreto: 300 test eseguiti, 297 passati e 3 falliti.</p>

<figure class=""><img src="/assets/images/swe-bench-pro-local/eval.jpg" alt="" /><figcaption>
      Risultato della validazione: la patch è applicabile ma non risolve completamente il task.

    </figcaption></figure>

<p>Questo è esattamente il tipo di fallimento utile.</p>

<p>Non “non funziona niente”.</p>

<p>Ma:</p>

<blockquote>
  <p>il modello ha prodotto una patch plausibile, applicabile, ma semanticamente incompleta o sbagliata.</p>
</blockquote>

<p>Nel caso specifico, la modifica sembrava troppo locale e probabilmente non affrontava davvero il problema più ampio della validazione email e del fallback sui dati scaduti o mancanti.</p>

<p>Questo è il tipo di dato che voglio raccogliere nei prossimi esperimenti: non solo quanti task passano, ma <strong>come</strong> falliscono quelli che non passano.</p>

<hr />

<h2 id="cosa-ho-imparato-fin-qui">Cosa ho imparato fin qui</h2>

<p>Questa prima fase mi ha confermato alcune cose.</p>

<p>La prima: eseguire SWE-bench Pro in locale è possibile, ma non è un comando magico. Serve trattarlo come un vero sistema sperimentale.</p>

<p>La seconda: prima di misurare i modelli bisogna validare l’infrastruttura. Le gold patch sono indispensabili per capire se il verificatore funziona.</p>

<p>La terza: gli errori più fastidiosi non arrivano necessariamente dal modello. Possono arrivare da Docker, SELinux, entrypoint, working directory, immagini non adatte allo scaffold dell’agente, parser dei tool o limiti di spazio disco.</p>

<p>La quarta: un benchmark di coding agent non misura solo il modello. Misura l’intero sistema:</p>

<ul>
  <li>modello;</li>
  <li>quantizzazione;</li>
  <li>backend di inferenza;</li>
  <li>prompt;</li>
  <li>agente;</li>
  <li>tool calling;</li>
  <li>container;</li>
  <li>test harness;</li>
  <li>timeout;</li>
  <li>parser dell’output;</li>
  <li>strategia di retry.</li>
</ul>

<p>Questo rende i risultati più difficili da interpretare, ma anche molto più interessanti.</p>

<hr />

<h2 id="perché-questo-conta-per-la-quantizzazione">Perché questo conta per la quantizzazione</h2>

<p>Il motivo per cui mi interessa davvero eseguire SWE-bench Pro in locale è la quantizzazione.</p>

<p>Quando si usano modelli openweight su hardware consumer, la quantizzazione non è un dettaglio tecnico. È spesso ciò che rende possibile o impossibile usare un certo modello.</p>

<p>Ma la domanda importante non è solo:</p>

<blockquote>
  <p>quanto è veloce Q4 rispetto a Q6?</p>
</blockquote>

<p>La domanda è:</p>

<blockquote>
  <p>quanto perde Q4 in capacità agentica rispetto a Q6 o Q8?</p>
</blockquote>

<p>Un modello quantizzato più aggressivamente può essere abbastanza buono in chat, ma fallire più spesso quando deve:</p>

<ul>
  <li>mantenere coerenza su molti step;</li>
  <li>leggere output lunghi;</li>
  <li>produrre patch precise;</li>
  <li>evitare modifiche inutili;</li>
  <li>seguire istruzioni rigide;</li>
  <li>non perdersi nella logica di una codebase reale.</li>
</ul>

<p>SWE-bench Pro permette di iniziare a misurare proprio questo.</p>

<p>Non perfettamente. Non senza rumore. Non senza problemi di contaminazione sul public set.</p>

<p>Ma in modo molto più concreto di un semplice confronto di token al secondo o di score sintetici.</p>

<hr />

<h2 id="prossimi-passi">Prossimi passi</h2>

<p>Questo post non contiene ancora una tabella di risultati.</p>

<p>Volutamente.</p>

<p>Prima volevo raccontare il metodo, i problemi incontrati e il motivo per cui secondo me vale la pena fare questo tipo di <a href="https://github.com/asoldano/SWE-bench_Pro-os/commits/prime-prove/">esperimento</a>.</p>

<p>I prossimi passi saranno:</p>

<ol>
  <li>selezionare un subset più ragionato dei 731 task pubblici;</li>
  <li>classificare i task per linguaggio, repository e dimensione della gold patch;</li>
  <li>eseguire più modelli o più quantizzazioni con lo stesso scaffold;</li>
  <li>distinguere i fallimenti infrastrutturali dai fallimenti del modello;</li>
  <li>confrontare non solo il pass rate, ma anche i tipi di errore.</li>
</ol>

<p>Solo a quel punto avrà senso parlare di numeri.</p>

<p>Per ora il risultato è più modesto, ma importante: la pipeline locale funziona. Il modello locale produce patch. L’evaluator le valida. E i fallimenti iniziano a essere informativi.</p>

<p>Per il resto… servirà tempo ;-)</p>]]></content><author><name>Alessio Soldano</name></author><category term="AI locale" /><category term="LLM" /><category term="coding agent" /><category term="SWE-bench" /><category term="SWE-bench Pro" /><category term="benchmark" /><category term="quantizzazione" /><category term="mini-swe-agent" /><category term="Docker" /><category term="Qwen3.6" /><summary type="html"><![CDATA[SWE-bench Pro nasce per valutare coding agent su task software più realistici e meno saturi dei benchmark precedenti. Ho iniziato a eseguirlo in locale per capire quanto la quantizzazione impatti davvero sulla qualità dei modelli openweight.]]></summary></entry><entry><title type="html">Speculative decoding: quando il problema non è solo leggere il prompt, ma anche generare la risposta</title><link href="https://aladinodigitale.it/2026/04/28/speculative-decoding.html" rel="alternate" type="text/html" title="Speculative decoding: quando il problema non è solo leggere il prompt, ma anche generare la risposta" /><published>2026-04-28T00:00:00+00:00</published><updated>2026-04-28T00:00:00+00:00</updated><id>https://aladinodigitale.it/2026/04/28/speculative-decoding</id><content type="html" xml:base="https://aladinodigitale.it/2026/04/28/speculative-decoding.html"><![CDATA[<p>Negli ultimi mesi si è parlato molto di modelli locali, coding agent e inferenza su hardware consumer. Una delle cose che ho sottolineato più volte è che, quando si usa un coding agent su una codebase reale, uno dei colli di bottiglia principali è spesso la fase di <strong>prefill</strong>.</p>

<p>Il modello deve leggere istruzioni, file, cronologia della conversazione, output dei tool, porzioni di codice e magari anche parti del progetto ripetute più volte nel contesto. In quei casi, il problema non è tanto “quanto velocemente scrive”, ma “quanto costa fargli rileggere tutto”.</p>

<p>Questo articolo, però, parla di un’altra fase della pipeline: la <strong>generazione</strong> vera e propria, cioè il momento in cui il modello produce la risposta token dopo token.</p>

<p>Le due cose non sono in contraddizione. Sono problemi diversi.</p>

<p>Il prefill si affronta con ottimizzazioni come riuso della KV-cache, prefix caching, gestione più intelligente del contesto, riduzione del prompt, attenzione più efficiente e, in alcuni casi, quantizzazione della KV-cache. Lo <strong>speculative decoding</strong>, invece, prova ad accelerare soprattutto la fase successiva: quella in cui il modello ha già letto il contesto e deve iniziare a scrivere.</p>

<p>E questa fase può diventare un problema, soprattutto quando si usano modelli locali densi, grandi e qualitativamente interessanti, ma non velocissimi in generazione.</p>

<p>Nel mio caso un modello da testare è sicuramente <a href="https://huggingface.co/Qwen/Qwen3.6-27B"><em>Qwen3.6 27B</em></a>, denso, interessante per attività di coding, ma non esattamente un fulmine quando deve generare molti token su hardware locale. Ho una macchina basata su AMD Ryzen AI Max+ 395 con 128GB di memoria unificats, quindi posso caricare anche modelli relativamente importanti, ma questo non significa automaticamente avere una velocità di decode paragonabile a quella di un servizio cloud.</p>

<p>Da qui nasce l’interesse per lo <strong>speculative decoding</strong>, inteso come tassello nello stack di ottimizzazioni che rendono sempre più praticabile l’uso locale di modelli avanzati.</p>

<hr />

<h2 id="lidea-dello-speculative-decoding">L’idea dello speculative decoding</h2>

<p>Lo speculative decoding è una famiglia di tecniche che prova ad accelerare la generazione facendo una cosa apparentemente semplice: qualcuno prova a indovinare i prossimi token, e il modello principale verifica se vanno bene.</p>

<p>La versione più intuitiva è questa:</p>

<ol>
  <li>un modello piccolo e veloce, chiamato spesso <strong>draft model</strong>, propone una sequenza di token;</li>
  <li>il modello principale, più grande e più lento, controlla quella sequenza;</li>
  <li>i token compatibili con quello che il modello principale avrebbe prodotto vengono accettati;</li>
  <li>quando la previsione sbaglia, il modello principale riprende il controllo.</li>
</ol>

<p>Il punto importante è che il modello piccolo non decide davvero la risposta. Propone soltanto una bozza. Il modello principale mantiene il diritto di veto.</p>

<p>Una formulazione semplice potrebbe essere:</p>

<blockquote>
  <p>Il draft model non sostituisce il modello grande. Cerca solo di anticiparlo.</p>
</blockquote>

<p>Se il draft model indovina spesso, il sistema può evitare parte del lavoro token-by-token e generare più velocemente. Se invece indovina poco, il vantaggio si riduce o sparisce.</p>

<p>La <a href="https://github.com/ggml-org/llama.cpp/blob/master/docs/speculative.md">documentazione di <code class="language-plaintext highlighter-rouge">llama.cpp</code></a> descrive proprio il draft model come l’approccio più comune allo speculative decoding: un modello molto più piccolo genera draft che vengono poi verificati dal modello principale. La stessa documentazione elenca anche implementazioni senza draft model, tra cui varianti basate su n-gram.</p>

<hr />

<h2 id="perché-se-ne-parla-proprio-ora">Perché se ne parla proprio ora</h2>

<p>Lo speculative decoding non è un’idea nata ieri. La cosa interessante è che sta diventando più accessibile negli strumenti che molte persone usano davvero per l’inferenza locale.</p>

<p>Da un lato ci sono applicazioni come <a href="https://lmstudio.ai">LM Studio</a>, che permettono di attivare speculative decoding in modo relativamente semplice e, cosa molto utile dal punto di vista didattico, mostrano visivamente i token proposti dal draft model e accettati dal modello principale. LM Studio ha documentato questa funzionalità spiegando che il draft model deve essere compatibile con il modello principale, in particolare lato vocabolario/tokenizer.</p>

<p>Dall’altro lato c’è <strong>llama.cpp</strong>, che nelle versioni recenti sta sperimentando varie forme di speculative decoding, incluse modalità con draft model e modalità n-gram. La <a href="https://github.com/ggml-org/llama.cpp/blob/master/docs/speculative.md">documentazione attuale di llama.cpp</a> elenca più implementazioni per <code class="language-plaintext highlighter-rouge">llama-server</code>, tra cui <code class="language-plaintext highlighter-rouge">draft</code>, <code class="language-plaintext highlighter-rouge">ngram-cache</code>, <code class="language-plaintext highlighter-rouge">ngram-simple</code>, <code class="language-plaintext highlighter-rouge">ngram-map-k</code> e <code class="language-plaintext highlighter-rouge">ngram-mod</code>.</p>

<p>Questo è rilevante perché, con modelli recenti come Qwen3.5 e Qwen3.6, il supporto e le combinazioni praticabili sono in evoluzione rapida. Una <a href="https://github.com/thc1006/qwen3.6-speculative-decoding-rtx3090">PR recente di llama.cpp</a> (#19493) ha ad esempio abilitato il draft-model speculative decoding per i modelli Qwen3.5/3.6 MoE (Mixture of Experts), aprendo la strada a nuovi esperimenti.</p>

<p>Questo spiega anche una differenza pratica importante: in <strong>LM Studio</strong> oggi la demo più semplice può richiedere coppie di modelli più vecchie o già supportate, mentre usando direttamente una versione recente di <strong>llama.cpp</strong> si possono fare esperimenti più avanzati con Qwen3.5/Qwen3.6.</p>

<p>LM Studio usa llama.cpp come backend in molti casi, ma non espone necessariamente subito ogni funzionalità appena arrivata upstream. Per questo ha senso fare due esempi separati: uno in LM Studio per capire visivamente il meccanismo, e uno in llama.cpp per un caso più vicino al mio workflow reale.</p>

<hr />

<h2 id="demo-1-vedere-speculative-decoding-in-lm-studio">Demo 1: vedere speculative decoding in LM Studio</h2>

<p>La prima demo che voglio usare nell’articolo non serve a dimostrare il massimo speedup possibile. Serve a far vedere il concetto.</p>

<p>Il setup è questo:</p>

<ul>
  <li>applicazione: <strong>LM Studio</strong>;</li>
  <li>modello principale: <strong>Qwen 3 14B</strong>;</li>
  <li>draft model: <strong>Qwen 3 0.6B</strong>;</li>
  <li>speculative decoding abilitato;</li>
  <li>visualizzazione dei token accettati dal draft model attiva.</li>
</ul>

<p>Chiaramente non scelgo questa coppia perché sia lo stato dell’arte per il coding locale. La scelgo perché, nel mio setup, è una delle combinazioni che LM Studio permette di usare facilmente per mostrare il meccanismo.</p>

<p>La cosa interessante è la visualizzazione: durante la generazione, LM Studio può evidenziare i token proposti dal draft model e accettati dal modello principale. Dal punto di vista didattico è molto efficace, perché trasforma un concetto un po’ astratto in qualcosa che si vede davvero.</p>

<p>Vediamo dunque come la risposta ad un prompt direttamente nella console di LMStudio viene servita Qwen3 14B generando in media attorno ai 14 token/s.</p>

<figure class=""><img src="/assets/images/speculative-decoding/lmstudio-baseline.png" alt="" /><figcaption>
      LM Studio con speculative decoding non attivo.

    </figcaption></figure>

<p>Una volta attivato speculative decoding molti token (in verde qui sotto) vengono correttamente indovinati dal modello draft Qwen 3 0.6B, portando ad una generazione media attorno ai 24 token/s.</p>

<figure class=""><img src="/assets/images/speculative-decoding/lmstudio-spec-dec.png" alt="Chat LM Studio con token/s visibili" /><figcaption>
      Chat in LM Studio con speculative decoding attivo.

    </figcaption></figure>

<p>Quello che voglio mostrare è semplice:</p>

<ul>
  <li>il draft model prova a generare token in anticipo;</li>
  <li>il modello principale li verifica;</li>
  <li>alcuni token vengono accettati;</li>
  <li>più token vengono accettati, più il meccanismo può diventare utile;</li>
  <li>quando il draft model non indovina, il vantaggio si riduce.</li>
</ul>

<p>Questa demo è utile soprattutto per capire una cosa: speculative decoding non è “il modello piccolo che risponde al posto di quello grande”. È più simile a un assistente che prova a completare le frasi, mentre il modello grande controlla che il completamento sia corretto.</p>

<hr />

<h2 id="il-limite-della-demo-in-lm-studio">Il limite della demo in LM Studio</h2>

<p>La demo in LM Studio è bella perché rende visibile il meccanismo. Ma non rappresenta necessariamente un caso d’uso reale attuale.</p>

<p>In particolare mi interessa soprattutto capire se queste tecniche possono aiutare quando uso un modello locale moderno e più pesante per attività di coding.</p>

<p>Uno scenario rappresentativo è dunque simile a questo:</p>

<ul>
  <li>modello denso;</li>
  <li>buona qualità su codice;</li>
  <li>generazione non velocissima;</li>
  <li>task di refactoring o modifica di una codebase reale;</li>
  <li>output lungo abbastanza da rendere percepibile la differenza.</li>
</ul>

<p>Per questo la seconda demo usa un approccio diverso: <strong>Qwen3.6 27B</strong> con llama.cpp e speculative decoding basato su <strong>n-gram</strong>.</p>

<hr />

<h2 id="draft-model-e-n-gram-due-strade-diverse">Draft model e n-gram: due strade diverse</h2>

<p>Nel primo esempio abbiamo visto la forma più intuitiva di speculative decoding: un secondo modello, più piccolo, propone token.</p>

<p>Ma non è l’unica possibilità.</p>

<p>In llama.cpp esistono anche approcci “draftless”, cioè senza un vero draft model separato. Tra questi ci sono le modalità basate su <strong>n-gram</strong>.</p>

<p>Un n-gram, semplificando, è una sequenza di token. L’idea è cercare sequenze già viste nel prompt o nella generazione corrente e usarle per proporre i token successivi.</p>

<p>Invece di chiedere a un modello piccolo “secondo te cosa viene dopo?”, il sistema fa qualcosa di più meccanico:</p>

<blockquote>
  <p>Ho già visto una sequenza simile nel contesto. Dopo quella sequenza, quali token venivano? Proviamo a proporli anche qui.</p>
</blockquote>

<p>Questo approccio ha caratteristiche diverse dal draft model.</p>

<table>
  <thead>
    <tr>
      <th>Aspetto</th>
      <th>Draft model</th>
      <th>N-gram speculative decoding</th>
    </tr>
  </thead>
  <tbody>
    <tr>
      <td>Usa un secondo modello</td>
      <td>Sì</td>
      <td>Non necessariamente</td>
    </tr>
    <tr>
      <td>Richiede compatibilità tokenizer/vocabolario</td>
      <td>Sì</td>
      <td>No, perché lavora sui token del modello principale</td>
    </tr>
    <tr>
      <td>Consuma memoria aggiuntiva</td>
      <td>Sì</td>
      <td>Molto meno</td>
    </tr>
    <tr>
      <td>Capisce semanticamente il testo</td>
      <td>In parte, tramite il draft model</td>
      <td>No, sfrutta pattern e ripetizioni</td>
    </tr>
    <tr>
      <td>Caso ideale</td>
      <td>Draft model piccolo ma ben allineato</td>
      <td>Testi ripetitivi, codice, refactoring, output strutturati</td>
    </tr>
    <tr>
      <td>Rischio principale</td>
      <td>Il draft model è troppo lento o poco allineato</td>
      <td>Il testo non contiene pattern utili</td>
    </tr>
  </tbody>
</table>

<p>La documentazione di llama.cpp indica che le implementazioni con draft model possono essere combinate con implementazioni senza draft model, e mostra anche esempi in cui <code class="language-plaintext highlighter-rouge">ngram-mod</code> viene usato insieme a un draft model.</p>

<p>Per il mio secondo esempio, però, l’interesse principale è proprio valutare l’approccio n-gram, perché non richiede di caricare un altro modello e perché il codice è un dominio in cui la ripetizione è spesso molto forte.</p>

<hr />

<h2 id="perché-n-gram-ha-senso-nel-codice">Perché n-gram ha senso nel codice</h2>

<p>Nel testo creativo, ogni frase può essere nuova. In un refactoring di codice, ad esempio Java, invece, moltissime parti dell’output sono prevedibili o assomigliano a qualcosa che è già nel contesto.</p>

<p>Pensiamo a una classe Java reale. Dentro potremmo trovare:</p>

<ul>
  <li>dichiarazioni di package;</li>
  <li>import;</li>
  <li>annotazioni;</li>
  <li>firme di metodi;</li>
  <li>nomi di classi già presenti;</li>
  <li>nomi di variabili ricorrenti;</li>
  <li>pattern di logging;</li>
  <li>strutture <code class="language-plaintext highlighter-rouge">try/catch</code>;</li>
  <li>chiamate a servizi;</li>
  <li>test simili;</li>
  <li>blocchi ripetuti con piccole variazioni.</li>
</ul>

<p>Quando chiediamo a un modello di fare refactoring, spesso non gli stiamo chiedendo di inventare tutto da zero. Gli stiamo chiedendo di riconoscere una struttura, modificarla, ripeterla in modo coerente e adattarla.</p>

<p>Questo è esattamente il tipo di situazione in cui un approccio basato su n-gram può avere senso, non perché capisca il codice, ma perché il codice contiene molte sequenze che ritornano.</p>

<hr />

<h2 id="demo-2-refactoring-java-con-qwen36-27b-e-llamacpp">Demo 2: refactoring Java con Qwen3.6 27B e llama.cpp</h2>

<p>Ho dunque configurato Claude Code per utilizzare in inferenza un modello Qwen3.6 27B servito da una versione recentissima di llama.cpp, così da disporre delle ultime patch e poter attivare con successo n-gram speculative decoding.</p>

<p>Il task prevedeva di fare refactoring di una classe di diverse centinaia di righe di codice, deprecando tutti i metodi e delegando ad una nuova versione in cui la logica della classe stessa fosse mantenuta ma il codice fosse ri-organizzato e modernizzato con pattern più idiomatici. Altri task che si sarebbero prestati a questo test avrebbero potuto coinvolgere ad esempio:</p>

<ul>
  <li>semplificazione di una classe troppo lunga;</li>
  <li>aggiunta o riorganizzazione di test;</li>
  <li>separazione di responsabilità tra metodi;</li>
  <li>estrazione di logica duplicata in metodi privati.</li>
</ul>

<p>Ho eseguito lo stesso refactoring anche senza speculative decoding; lo scopo chiaramente era quello di capire se la tecnica permettesse veramente di recuperare del tempo in fase di generazione.</p>

<h3 id="perché-qwen36-27b">Perché Qwen3.6 27B</h3>

<p>Qwen3.6 27B è interessante perché rappresenta bene una categoria di modelli che, su AMD Strix Halo, sono allo stesso tempo desiderabili (essendo densi, ben si prestano a coding e ragionamento con agenti) e accettabili in fase di prefill ma estremamente lenti in generazione (di nuovo perché densi).</p>

<p>Desiderabili perché un modello denso di questa taglia può essere molto interessante per coding, ragionamento tecnico e agenti locali.
Quindi speculative deconding diventa una possibile soluzione per rendere più fluido l’utilizzo di un buon modello altrimenti inadatto.</p>

<h3 id="esecuzione">Esecuzione</h3>

<p>Ho specificato questi parametri nel avviare llama-server</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>--draft-min 4 --draft-max 16 --spec-ngram-size-n 12 --spec-type ngram-mod
</code></pre></div></div>

<p>in sostanza controllando le dimensioni dei gruppi di token da pescare (e provare ad usare) dalle generazioni precedenti e contesto.</p>

<p>Nei log ho visto varie statistiche sull’utilizzo di ngram-mod, in particolare verso la fine del test</p>

<div class="language-text highlighter-rouge"><div class="highlight"><pre class="highlight"><code>statistics ngram_mod: #calls(b,g,a) = 43 10790 883, #gen drafts = 884, #acc drafts = 883, #gen tokens = 13766, #acc tokens = 7096, dur(b,g,a) = 145.503, 393.013, 64.153 ms
</code></pre></div></div>

<p>Rispetto alla baseline senza speculative decoding, l’esecuzione ngram ha permesso di risparmiare circa 5 min a fronte degli oltre 27 richiesti dal sistema per completare il refactoring.</p>

<p>Va detto che in realtà il modello ha generato molto meno codice “ripetuto” di quanto ci si potesse aspettare perché Claude Code ha fatto uso intelligente dei tool di cui disponeva, ad esempio per effettuare sostituzioni di testo in modo deterministico e efficiente.</p>

<hr />

<h2 id="come-leggere-il-risultato-senza-farsi-ingannare">Come leggere il risultato senza farsi ingannare</h2>

<p>Speculative decoding è una tecnica facile da fraintendere.</p>

<p>Un errore comune è guardare solo quanti token sono stati accettati dal draft o dall’n-gram e concludere che allora il sistema è sicuramente più veloce. Non è detto.</p>

<p>Il risultato netto dipende da vari fattori:</p>

<ul>
  <li>quanto costa generare i draft;</li>
  <li>quanto costa verificarli;</li>
  <li>quanto spesso vengono accettati;</li>
  <li>quanto è lungo l’output;</li>
  <li>quanto è ripetitivo il testo;</li>
  <li>quale parte della pipeline è davvero il collo di bottiglia;</li>
  <li>quanto è efficiente l’implementazione nel backend;</li>
  <li>che hardware stiamo usando.</li>
</ul>

<p>Se il problema principale è il prefill, speculative decoding non risolve il problema principale.</p>

<p>Se il modello genera già molto velocemente, il guadagno percepito può essere marginale.</p>

<p>Se il testo è poco ripetitivo, n-gram può aiutare poco.</p>

<p>Se invece il modello è lento in generazione e deve produrre molto codice strutturato, allora anche un guadagno parziale può cambiare la percezione d’uso.</p>

<p>È importante anche ricordare che i risultati variano molto. Ci sono test recenti su Qwen3.6-35B-A3B (un modello MoE) con RTX 3090 in cui varie configurazioni di speculative decoding <a href="https://github.com/thc1006/qwen3.6-speculative-decoding-rtx3090/blob/master/README.md">non hanno prodotto uno speedup netto rispetto alla baseline</a>. È utile però notare che quel risultato riguarda un’architettura MoE, che ha dinamiche diverse rispetto a un modello denso come il 27B usato qui.</p>

<p>Questo non significa che speculative decoding “non funzioni”. Significa che non è una funzione magica da attivare aspettandosi automaticamente il doppio dei token al secondo.
Nel mio caso il test ha mostrato come si possa ottenere un miglioramento con il modello Qwen3.6 27B, ma probabilmente non tale da preferirlo ad un genericamente ben più veloce modello MoE come il Qwen3.5 122B A10B.</p>

<p>Resta il fatto che la ricerca attorno queste tecniche di ottimizzazione è super interessante e non è da escludere che nuovi algoritmi ed implementazioni ribaltino le conclusioni derivate da queste prove.</p>]]></content><author><name>Alessio Soldano</name></author><category term="AI locale" /><category term="LLM" /><category term="speculative decoding" /><category term="llama.cpp" /><category term="LM Studio" /><category term="Qwen3.6" /><category term="coding agent" /><summary type="html"><![CDATA[Lo speculative decoding accelera la generazione token per token usando un modello piccolo o pattern ricorrenti. Vediamo come funziona e se può aiutare con un modello denso come Qwen3.6 27B.]]></summary></entry><entry><title type="html">Benchmark LLM in locale: quale modello usare con Claude Code?</title><link href="https://aladinodigitale.it/2026/02/16/benchmark-modelli-agenti.html" rel="alternate" type="text/html" title="Benchmark LLM in locale: quale modello usare con Claude Code?" /><published>2026-02-16T00:00:00+00:00</published><updated>2026-02-16T00:00:00+00:00</updated><id>https://aladinodigitale.it/2026/02/16/benchmark-modelli-agenti</id><content type="html" xml:base="https://aladinodigitale.it/2026/02/16/benchmark-modelli-agenti.html"><![CDATA[<style>
.page-scroll-box {
  max-height: 30em;   /* ~20 righe */
  overflow-y: auto;
  overflow-x: hidden;      /* niente scroll orizzontale */
  white-space: pre-wrap;  /* mantiene i newline MA va a capo */
  word-break: break-word;
  padding: 8px 10px;
  border: 1px solid #ccc;
  background: #f8f8f8;
  font-family: ui-monospace, SFMono-Regular, Menlo, Consolas, monospace;
  font-size: 0.9em;
}
</style>

<h2 id="introduzione">Introduzione</h2>

<p>Negli ultimi mesi il numero di modelli eseguibili in locale per coding agent è cresciuto rapidamente: <em>gpt-oss 20B e 120B, Qwen3-Coder, Qwen3-Coder-Next, GLM 4.5-Air, 4.6-Flash, 4.7-Flash</em> sono solo alcuni esempi.</p>

<p>Se si dispone di una macchina con parecchia memoria – nel mio caso un <strong>AMD Ryzen AI Max+ 395 con 128GB di RAM unificata</strong> – la tentazione è semplice: verificare quanta memoria serve e scegliere il modello più grande che “ci sta”.</p>

<p>In pratica, però, la scelta è molto più sottile quando lo usecase non è un semplice <em>chatbot</em>. Per un <em>coding agent</em> la velocità diventa subito un aspetto critico, e la velocità non è un numero unico. In questo post provo a descrivere un possibile metodo di analisi basato su <code class="language-plaintext highlighter-rouge">llama-bench</code>, concentrandomi sugli aspetti di performance su singola richiesta.</p>

<hr />

<h2 id="prompt-processing-speed-e-token-generation-speed">Prompt processing speed e token generation speed</h2>

<p>Quando si misura la velocità di un LLM locale, si guardano in genere due grandezze:</p>

<ul>
  <li><strong>Prompt processing speed (pps)</strong>: quanti token al secondo il modello riesce a processare quando riceve un prompt.</li>
  <li><strong>Token generation speed (tgs)</strong>: quanti token al secondo riesce a generare in output.</li>
</ul>

<p>Le due fasi sono molto diverse. Durante il prompt processing il modello deve leggere tutto il contesto (system prompt, file di codice, diff, tool output, cronologia) e costruire la KV cache. Solo dopo inizia la generazione token per token.</p>

<p>Nei grafici che seguono trovi le metriche <strong>pp512</strong> e <strong>tg128</strong>:</p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">pp512</code> è la velocità media nel processare blocchi da 512 token.</li>
  <li><code class="language-plaintext highlighter-rouge">tg128</code> è la velocità media nel generare 128 token.</li>
</ul>

<p>Sono valori standardizzati che permettono confronti coerenti tra modelli e backend diversi.</p>

<hr />

<h2 id="ambiente-di-test">Ambiente di test</h2>

<p>I test sono stati eseguiti su:</p>

<ul>
  <li>AMD Ryzen AI Max+ 395 (Strix Halo)</li>
  <li>128GB di memoria unificata</li>
  <li>llama.cpp build: ff4affb4c (8067)</li>
  <li>backend:
    <ul>
      <li>ROCm 7.2</li>
      <li>Vulkan (RADV)</li>
    </ul>
  </li>
</ul>

<p><a href="https://github.com/ROCm/ROCm">ROCm</a> è lo stack ufficiale AMD per il calcolo GPU basato su <a href="https://rocm.docs.amd.com/projects/HIP/en/latest/what_is_hip.html">HIP</a>. <a href="https://www.vulkan.org/">Vulkan</a>, nel caso di <a href="https://docs.mesa3d.org/drivers/radv.html">Mesa RADV</a>, è il driver open source che permette di usare la GPU via API Vulkan anche per workload compute. <a href="https://github.com/ggml-org/llama.cpp">llama.cpp</a> supporta entrambi, ma le differenze di comportamento possono essere significative, anche a parità di hardware.</p>

<p>Ho selezionato quattro modelli che ritengo interessanti per l’inferenza nel mio ambiente: la coppia di modelli <strong>gpt-oss</strong> da 20B e 120B che già avevo presentato in passato, <strong>GLM 4.7-Flash</strong> ossia la versione leggera (classe 30B) di quello che è stato il modello state-of-the-art di <em>Z.ai</em> fino a qualche giorno fa, e <strong>Qwen3-coder-next</strong> recentemente rilasciato da <em>Qwen</em> specificatamente per utilizzo con <em>coding agents</em>.</p>

<p>Conscio delle differenze in termini di qualità dei risultati ottenibili (che non sono però oggetto di discussione diretta in questo post) e dei diversi requisiti di memoria per le quantizzazioni prescelte, mi sono focalizzato sulle performance velocistiche.</p>

<p><a href="/assets/images/benchmark-modelli-agenti/llama-bench.png" target="_blank">
  <img src="/assets/images/benchmark-modelli-agenti/llama-bench.png" style="margin:6px;" />
</a></p>

<hr />

<h2 id="1-dimensione-del-contesto-il-parametro--d">1) Dimensione del contesto: il parametro <code class="language-plaintext highlighter-rouge">-d</code></h2>

<p>Ho eseguito i test con:</p>

<p><code class="language-plaintext highlighter-rouge">-d 0,8192,16384,32768,65536,131072</code></p>

<p>Il parametro <code class="language-plaintext highlighter-rouge">-d</code> in <code class="language-plaintext highlighter-rouge">llama-bench</code> simula la profondità del contesto, cioè il numero di token già presenti nella KV cache prima della misurazione. In altre parole, misura come si comporta il modello quando deve lavorare con 8k, 16k, 32k, 64k o 128k token già in memoria.</p>

<p>Questo è un punto fondamentale. I benchmark a contesto quasi nullo sono poco rappresentativi per un coding agent reale. Strumenti come Claude Code aggiungono molto contesto: file interi, diff, output dei tool, cronologia della conversazione. Ci vuole poco a superare i 50k-100k token.</p>

<p>Guardiamo ad esempio il comportamento con backend Vulkan.</p>

<h3 id="prompt-processing-vulkan">Prompt processing (Vulkan)</h3>

<p><a href="/assets/images/benchmark-modelli-agenti/confronto-pp-vulkan-radv.png" target="_blank">
  <img src="/assets/images/benchmark-modelli-agenti/confronto-pp-vulkan-radv.png" style="margin:6px;" />
</a></p>

<h3 id="token-generation-vulkan">Token generation (Vulkan)</h3>

<p><a href="/assets/images/benchmark-modelli-agenti/confronto-tg-vulkan-radv.png" target="_blank">
  <img src="/assets/images/benchmark-modelli-agenti/confronto-tg-vulkan-radv.png" style="margin:6px;" />
</a></p>

<p>E lo stesso con ROCm:</p>

<h3 id="prompt-processing-rocm">Prompt processing (ROCm)</h3>

<p><a href="/assets/images/benchmark-modelli-agenti/confronto-pp-rocm72.png" target="_blank">
  <img src="/assets/images/benchmark-modelli-agenti/confronto-pp-rocm72.png" style="margin:6px;" />
</a></p>

<h3 id="token-generation-rocm">Token generation (ROCm)</h3>

<p><a href="/assets/images/benchmark-modelli-agenti/confronto-tg-rocm72.png" target="_blank">
  <img src="/assets/images/benchmark-modelli-agenti/confronto-tg-rocm72.png" style="margin:6px;" />
</a></p>

<p>Si osserva chiaramente che sia pp512 sia tg128 degradano all’aumentare del contesto. La cosa interessante non è solo il valore assoluto, ma la pendenza della curva. Alcuni modelli partono veloci ma degradano rapidamente; altri mantengono un comportamento più stabile.</p>

<hr />

<h2 id="2-testare-con-la-stessa-configurazione-reale">2) Testare con la stessa configurazione reale</h2>

<p>Un errore frequente è eseguire benchmark con una configurazione e poi usare un’altra in produzione.</p>

<p>Se per l’inferenza userai <code class="language-plaintext highlighter-rouge">llama-server</code> con:</p>

<ul>
  <li>un certo numero di layer in VRAM (<code class="language-plaintext highlighter-rouge">-ngl</code>)</li>
  <li>una specifica configurazione di flash-attention</li>
  <li>una determinata quantizzazione</li>
  <li>un backend preciso (ROCm o Vulkan)</li>
</ul>

<p>allora <code class="language-plaintext highlighter-rouge">llama-bench</code> va eseguito nelle stesse condizioni. Altrimenti si stanno misurando numeri che non riflettono l’uso reale.</p>

<hr />

<h2 id="3-le-quantizzazioni-non-si-comportano-tutte-allo-stesso-modo">3) Le quantizzazioni non si comportano tutte allo stesso modo</h2>

<p>Non basta guardare il numero di bit. Una quantizzazione può essere teoricamente più compatta o più veloce, ma non sfruttare in modo ottimale la precisione supportata dalla GPU o la gerarchia di memoria.</p>

<p>In pratica, alcune quantizzazioni risultano più memory-bound su certe architetture, mentre altre scalano meglio al crescere del contesto. Anche qui, l’unico modo serio per decidere è testare sul proprio hardware.</p>

<hr />

<h2 id="4-rocm-vs-vulkan-differenze-concrete">4) ROCm vs Vulkan: differenze concrete</h2>

<p>Un confronto diretto tra <em>ROCm</em> e <em>Vulkan</em> per <em>gpt-oss</em> mostra differenze non solo nei valori assoluti, ma anche nel modo in cui le prestazioni decadono con contesti grandi.</p>

<h3 id="prompt-processing-rocm-vs-vulkan">Prompt processing: ROCm vs Vulkan</h3>

<p><a href="/assets/images/benchmark-modelli-agenti/confronto-pp-gpt-oss-rocm72-vs-vulkan.png" target="_blank">
  <img src="/assets/images/benchmark-modelli-agenti/confronto-pp-gpt-oss-rocm72-vs-vulkan.png" style="margin:6px;" />
</a></p>

<h3 id="token-generation-rocm-vs-vulkan">Token generation: ROCm vs Vulkan</h3>

<p><a href="/assets/images/benchmark-modelli-agenti/confronto-tg-gpt-oss-rocm72-vs-vulkan.png" target="_blank">
  <img src="/assets/images/benchmark-modelli-agenti/confronto-tg-gpt-oss-rocm72-vs-vulkan.png" style="margin:6px;" />
</a></p>

<p>Un backend può essere più veloce a contesto piccolo ma degradare più rapidamente oltre i 32k o 64k token. Questo è particolarmente rilevante per i coding agent, dove il contesto tende a crescere rapidamente.</p>

<hr />

<h2 id="perché-per-un-coding-agent-il-prompt-processing-conta-più-della-generazione">Perché, per un coding agent, il prompt processing conta più della generazione</h2>

<p>Nel caso di un coding agent, il tempo speso nel processare il prompt è spesso predominante. Ogni volta che l’agente rilegge file, integra output di tool o ricostruisce il contesto dopo una tool call, il modello deve rieseguire la fase di prefill su un contesto potenzialmente molto grande.</p>

<p>La generazione, invece, spesso produce poche centinaia di token.</p>

<p>Se un modello degrada poco in token generation ma crolla in prompt processing oltre i 64k token, l’esperienza complessiva sarà comunque lenta. Al contrario, un modello con generazione leggermente più lenta ma con un prompt processing stabile su contesti grandi può risultare più reattivo nell’uso reale.</p>

<hr />

<h2 id="nel-mio-caso-specifico">Nel mio caso specifico</h2>

<p>Limitandoci a:</p>

<ul>
  <li>richieste singole (niente concorrenza tra più client)</li>
  <li>parametri coerenti con la configurazione reale</li>
  <li>contesti fino a 128k token</li>
  <li>backend ROCm e Vulkan</li>
</ul>

<p>tra i modelli testati (gpt-oss 20B, gpt-oss 120B, GLM 4.7-Flash, Qwen3-Coder-Next) il miglior compromesso complessivo, guardando in particolare al comportamento del <em>prompt processing</em> su contesti grandi, risulta essere <strong>Qwen3-Coder-Next</strong>.</p>

<p>Questo non significa che sia “il migliore in assoluto”. Non ho considerato:</p>

<ul>
  <li>carichi concorrenti con più thread o client</li>
  <li>impatto di KV cache condivisa</li>
  <li>misure end-to-end con tool call reali</li>
  <li>qualità delle risposte in modo sistematico</li>
</ul>

<p>Ma come primo filtro tecnico, un’analisi di questo tipo è molto più informativa del semplice confronto sulla dimensione del modello o sui token al secondo a contesto nullo.</p>

<hr />

<h2 id="conclusione">Conclusione</h2>

<p>Quando si sceglie un modello locale per un coding agent, limitarsi a verificare che “entri in memoria” è riduttivo.</p>

<p>Ha più senso:</p>

<ol>
  <li>misurare sia prompt processing sia token generation;</li>
  <li>analizzare il decadimento al crescere del contesto;</li>
  <li>usare la stessa configurazione che si adotterà in inferenza;</li>
  <li>confrontare backend e quantizzazioni sul proprio hardware.</li>
</ol>

<p>Nel caso dei coding agent, la partita si gioca spesso nella fase di <em>prompt processing</em>. È lì che si accumula la latenza maggiore e dove le differenze tra modelli diventano evidenti.</p>

<p>Il resto, come sempre, va validato sul proprio caso d’uso reale.</p>]]></content><author><name>Alessio Soldano</name></author><category term="AI locale" /><category term="Claude Code" /><category term="agents" /><category term="llama" /><category term="benchmark" /><category term="tps" /><category term="pps" /><category term="qwen3" /><category term="gpt" /><category term="rocm" /><category term="vulkan" /><summary type="html"><![CDATA[Capiamo come individuare i modelli adatti all'utilizzo di coding agent in locale dal punto di vista delle prestazioni (tempi di risposta).]]></summary></entry><entry><title type="html">Modelli Vision-Language e Z-Image, meta-prompting e diritti su immagini generate</title><link href="https://aladinodigitale.it/2026/01/07/modelli-vl-meta-prompting-diritti-immagini.html" rel="alternate" type="text/html" title="Modelli Vision-Language e Z-Image, meta-prompting e diritti su immagini generate" /><published>2026-01-07T00:00:00+00:00</published><updated>2026-01-07T00:00:00+00:00</updated><id>https://aladinodigitale.it/2026/01/07/modelli-vl-meta-prompting-diritti-immagini</id><content type="html" xml:base="https://aladinodigitale.it/2026/01/07/modelli-vl-meta-prompting-diritti-immagini.html"><![CDATA[<style>
.page-scroll-box {
  max-height: 30em;   /* ~20 righe */
  overflow-y: auto;
  overflow-x: hidden;      /* niente scroll orizzontale */
  white-space: pre-wrap;  /* mantiene i newline MA va a capo */
  word-break: break-word;
  padding: 8px 10px;
  border: 1px solid #ccc;
  background: #f8f8f8;
  font-family: ui-monospace, SFMono-Regular, Menlo, Consolas, monospace;
  font-size: 0.9em;
}
</style>

<h2 id="introduzione">Introduzione</h2>

<p>Nel mondo dell’AI generativa siamo ormai abituati a pensare in termini di <strong>prompt testuali</strong> e <strong>immagini generate</strong>, ma sempre più spesso il confine tra testo e immagine diventa bidirezionale.<br />
Da un lato chiediamo a un modello di <em>creare</em> immagini a partire da parole (T2I, <em>text-to-image</em>), dall’altro iniziamo a usare modelli capaci di <em>capire</em> immagini e tradurle in testo (I2T, <em>image-to-text</em>).</p>

<p>È proprio in questo spazio ibrido che entrano in gioco i <strong>modelli Vision-Language (VL)</strong>, e che nasce l’esperimento di cui parlerò in questo post: un workflow reale, eseguito in locale, che combina <strong>comprensione visiva</strong>, <strong>meta-prompting</strong> e <strong>generazione fotorealistica</strong>, senza dimenticare una riflessione necessaria sui <strong>diritti delle immagini generate</strong>.</p>

<hr />

<h2 id="cosa-sono-i-modelli-vision-language-vl-e-perché-sono-importanti">Cosa sono i modelli Vision-Language (VL) e perché sono importanti</h2>

<p>I modelli Vision-Language sono modelli multimodali in grado di elaborare <strong>immagini e testo nello stesso spazio semantico</strong>.<br />
Non si limitano a “vedere” un’immagine, ma sono in grado di:</p>

<ul>
  <li>descriverla in linguaggio naturale</li>
  <li>rispondere a domande sul suo contenuto</li>
  <li>estrarne dettagli strutturati</li>
  <li>usarla come contesto per ragionamenti più complessi</li>
</ul>

<p>Questa capacità li rende fondamentali non solo per applicazioni “creative”, ma anche per analisi, automazione, accessibilità e controllo qualità.</p>

<h3 id="qwen3-vl">Qwen3-VL</h3>

<p>Tra i modelli VL più interessanti emersi di recente c’è <strong><a href="https://qwen.ai/blog?id=qwen3-vl">Qwen3-VL</a></strong>, sviluppato dal team Qwen di Alibaba.<br />
Il motivo principale per cui è rilevante <em>per questo blog</em> non è solo la qualità delle descrizioni, ma un aspetto molto concreto:</p>

<p><strong>Qwen3-VL è open-weight.</strong></p>

<p>Questo significa che:</p>

<ul>
  <li>può essere eseguito <strong>in locale</strong></li>
  <li>può essere integrato in workflow personalizzati (ad esempio in ComfyUI)</li>
  <li>consente sperimentazione reale, senza dipendere da API proprietarie</li>
</ul>

<p>Rispetto a modelli come Gemini 3 o GPT-4o, Qwen3-VL eseguito in locale mostra limiti evidenti sul piano della conoscenza generale e del ragionamento avanzato, ma <strong>sul piano pratico della descrizione visiva è piuttosto solido</strong>, soprattutto se guidato con prompt ben progettati.</p>

<hr />

<h2 id="z-image-e-z-image-turbo-velocità-fotorealismo-e-open-source">Z-Image e Z-Image Turbo: velocità, fotorealismo e open source</h2>

<p>Se Qwen3-VL copre il lato <strong>I2T</strong>, serve poi un modello capace di trasformare testo in immagini con qualità elevata.<br />
Qui entra in gioco <strong><a href="https://arxiv.org/abs/2511.22699">Z-Image</a></strong>, in particolare la sua variante <strong>Turbo</strong>.</p>

<p>Z-Image Turbo ha due caratteristiche che lo rendono estremamente interessante:</p>

<ol>
  <li><strong>È open source / open weight</strong>, disponibile su <a href="https://github.com/Tongyi-MAI/Z-Image">GitHub</a> e <a href="https://huggingface.co/Tongyi-MAI/Z-Image-Turbo">Hugging Face</a></li>
  <li><strong>È estremamente efficiente</strong>, nonostante una dimensione di circa <strong>6 miliardi di parametri</strong></li>
</ol>

<p>Nei test pratici Z-Image Turbo si distingue per:</p>

<ul>
  <li>velocità di generazione molto elevata</li>
  <li>uso contenuto di VRAM</li>
  <li><strong>fotorealismo notevole</strong>, soprattutto su soggetti umani e scene realistiche</li>
</ul>

<p>È importante chiarire che <strong>non tutti i modelli Z-Image sono open source</strong>: in particolare le varianti <em>base</em> (<em>non-distilled</em>) e <em>edit</em> (<em>image-to-image</em> avanzato) <strong>non sono ancora rilasciate</strong> in forma open.<br />
Questo è uno dei motivi per cui l’esperimento descritto in questo post passa volutamente <strong>dal testo</strong>, invece che da un vero flusso I2I.</p>

<hr />

<h2 id="un-workflow-comfyui-da-immagine-a-prompt-da-prompt-a-nuova-immagine">Un workflow ComfyUI: da immagine a prompt, da prompt a nuova immagine</h2>

<p>A questo punto abbiamo i due mattoni fondamentali:</p>

<ul>
  <li><strong>Qwen3-VL</strong> per analizzare un’immagine e produrre un prompt testuale</li>
  <li><strong>Z-Image Turbo</strong> per generare una nuova immagine a partire da quel testo</li>
</ul>

<p>Per realizzare il workflow, sono partito da alcuni esempi realizzati da <a href="https://pixaroma.com/">Pixaroma</a> e condivisi sul relativo canale <a href="https://discord.com/invite/gggpkVgBf3">Discord</a>. Su Youtube sono disponibili interessanti tutorial (in particolare <a href="https://www.youtube.com/watch?v=pbRiR9pqlos&amp;list=PL-pohOSaL8P9kLZP8tQ1K1QWdZEgwiBM0&amp;index=72&amp;pp=iAQB">Ep 71</a> e <a href="https://www.youtube.com/watch?v=DYzHAX15QL4&amp;list=PL-pohOSaL8P9kLZP8tQ1K1QWdZEgwiBM0&amp;index=73&amp;pp=iAQB">Ep 72</a> sono rilevanti in questo caso) che comprendono anche tutti i link alle varie risorse.
In ogni caso, il workflow eseguito segue sostanzialmente questa logica:</p>

<ol>
  <li>immagine di input</li>
  <li>nodo Qwen3-VL → descrizione testuale</li>
  <li>eventuale modifica / miglioramento del prompt</li>
  <li>flusso T2I basato su Qwen3 + Z-Image Turbo</li>
</ol>

<p>L’idea è quella di <strong>prendere ispirazione</strong> da un’immagine esistente per generarne una nuova, simile ma non identica.</p>

<p>Questo si collega direttamente al filo conduttore di <em>Aladino Digitale</em>:
la lampada è l’AI, il desiderio è il prompt — e se il desiderio è formulato male, il risultato può essere <em>molto</em> diverso da quello sperato.</p>

<p>Usare un modello VL per ottenere un primo prompt “ben fatto” consente di:</p>

<ul>
  <li>superare difficoltà linguistiche</li>
  <li>partire da una descrizione semanticamente ricca</li>
  <li>concentrarsi sugli elementi davvero salienti</li>
</ul>

<p>Inoltre, il risultato finale <strong>non è una copia</strong>, ma una nuova immagine:<br />
potenzialmente più libera da vincoli, e facilmente adattabile a:</p>

<ul>
  <li>formati diversi (verticale, orizzontale, social-first)</li>
  <li>cambi di stile</li>
  <li>reinterpretazioni fotorealistiche di immagini stilizzate o cartoon</li>
</ul>

<p>Questo approccio è una sorta di <strong>surrogato dei modelli edit</strong>, in attesa che Z-Image Edit venga rilasciato in forma open.</p>

<hr />

<h2 id="focus-il-nodo-custom-qwenvl-in-comfyui">Focus: il nodo custom QwenVL in ComfyUI</h2>

<p>Uno degli elementi chiave del workflow è il nodo custom <a href="https://github.com/1038lab/ComfyUI-QwenVL">ComfyUI-QwenVL</a>.</p>

<p>Questo nodo permette di interrogare Qwen3-VL con diversi <strong>preset_prompt</strong>, ovvero prompt predefiniti pensati per ottenere descrizioni con livelli di dettaglio differenti.</p>

<p>Per avere un’idea di come il modello Qwen3-VL venga interrogato dal nodo di ComfyUI, tra i file di configurazione si possono leggere i prompt completi per i vari Preset (in particolare <code class="language-plaintext highlighter-rouge">Simple Description</code>, <code class="language-plaintext highlighter-rouge">Detailed Description</code>, <code class="language-plaintext highlighter-rouge">Ultra Detailed Description</code>, <code class="language-plaintext highlighter-rouge">Cinematic Description</code> e <code class="language-plaintext highlighter-rouge">Detailed Analysis</code> che useremo più avanti):</p>

<p><a href="/assets/images/modelli-vl-meta-prompting/qwen-vl-presets.png" target="_blank">
  <img src="/assets/images/modelli-vl-meta-prompting/qwen-vl-presets.png" style="margin:6px;" />
</a></p>

<p>La differenza tra i risultati ottenibili con questi preset non è solo quantitativa (più o meno parole), ma qualitativa: cambia il tipo di attenzione che il modello dedica a composizione, luce, soggetti, atmosfera.</p>

<p>Un aspetto particolarmente potente è la possibilità di <strong>definire nuovi preset</strong>, semplicemente aggiungendo prompt personalizzati in un file di configurazione.<br />
Questo apre la porta a un controllo artistico molto fine: ad esempio, enfatizzare outfit, materiali, espressioni o elementi narrativi specifici.</p>

<p>Un miglioramento interessante — che non escludo di implementare con una PR — sarebbe consentire l’output <strong>in formato JSON</strong>, così da meglio separare semanticamente elementi come soggetto, ambiente, stile e illuminazione.</p>

<hr />

<h2 id="setup-sperimentale-e-immagine-di-test">Setup sperimentale e immagine di test</h2>

<p>E’ dunque giunto il momento di provare il workflow presentato. Ho selezionato l’immagine di riferimento da usare per i test attingendo dal <a href="https://www.photomilagro.com/portfolio/">portfolio di Milagro</a>:
<a href="/assets/images/modelli-vl-meta-prompting/IMG_7400.jpg" target="_blank">
  <img src="/assets/images/modelli-vl-meta-prompting/IMG_7400.jpg" style="margin:6px;" />
</a></p>

<p>Le prove sono state eseguite <strong>interamente in locale</strong>, sulla mia macchina basata su <strong>AMD Strix Halo</strong>, senza ricorrere ad API cloud o servizi esterni. Al solito, questo è un aspetto importante: al netto del non determinismo AI, l’esperimento è riproducibile e non dipende da infrastrutture proprietarie.</p>

<p>Ho configurato Z-Image Turbo (versione con precisione <code class="language-plaintext highlighter-rouge">bf16</code>) perché generasse immagini da 2.25 MP (1536 x 1536) in 5 step con sampler <code class="language-plaintext highlighter-rouge">dmpp_sde</code> e scheduler <code class="language-plaintext highlighter-rouge">beta</code>; per tutti gli altri elementi della configurazione (inlcuso <em>Qwen3 4B</em> come text encoder per processare i prompt) ho mantenuto i valori di default del workflow.</p>

<blockquote>
  <p>💡 <em>Suggerimento:</em><br />
ComfyUI salva di default il workflow completo utilizzato per la generazione delle immagini dentro i metadata dell’immagine stessa. Puoi dunque importare alcune delle immagini che trovi qui sotto (la versione <code class="language-plaintext highlighter-rouge">.png</code> in alta risoluzione) dentro la tua installazione di ComfyUI e rieseguire facilmente i test.</p>
</blockquote>

<p>In termini di tempi di esecuzione sulla mia macchina, il flusso completo ha richiesto circa un minuto e mezzo, diviso grossomodo in 30 secondi per la parte I2T (Qwen3-VL che genera il testo a partire dall’immagine in input) e un minuto per la parte T2I (quasi completamente spesi in fase di sampling, circa 11~12 secondi a step). I tempi di generazione dell’immagine dipendono fortemente dalla dimensioni dell’immagine richiesta e dunque dalla memoria allocata nello spazio latente; sul mio hardware, scendendo a 1MP di risoluzione (1024 x 1024) i tempi di generazione si riducono ad un terzo, circa 20 secondi.</p>

<hr />

<h2 id="prove-con-i-diversi-preset">Prove con i diversi preset</h2>
<p>Per cominciare, ho eseguito varie prove configurando il nodo QwenVL affinché utilizzasse il modello <code class="language-plaintext highlighter-rouge">Qwen3-VL-Instruct</code> da 4 miliardi di parametri con numero massimo di token pari a 2048 (così da evitare troncamenti) e differenti preset.</p>

<p><a href="/assets/images/modelli-vl-meta-prompting/I2T-QwenVL-config.jpg" target="_blank">
  <img src="/assets/images/modelli-vl-meta-prompting/I2T-QwenVL-config.jpg" style="margin:6px;" />
</a></p>

<h3 id="qwen3-vl-4b-instruct-con-simple-description">Qwen3-VL-4B-Instruct con Simple Description</h3>
<p>La descrizione testuale generata con il preset <code class="language-plaintext highlighter-rouge">Simple Description</code> rispecchia le attese (una singola frase concisa), fa riferimento a due auto Porsche di colore corretto e fornisce alcune indicazioni di massima riguardo la scena, il paesaggio e il meteo.</p>
<pre class="page-scroll-box">
Two classic Porsche sports cars—a black 911 Turbo and a white 911—parked on an asphalt lot against a backdrop of rugged mountains under a dramatic, cloudy sky at dusk.
</pre>
<p>L’immagine generata a partire dal testo, utilizzato come prompt, ne segue le indicazioni correttamente: abbiamo due classiche Porsche 911, il riferimento al parcheggio porta ad avere strisce bianche a terra, le montagne e il cielo sono realistici ma necessariamente differenti da quanto osservabile nell’immagine di riferimento.</p>

<p><a href="/assets/images/modelli-vl-meta-prompting/4B-Simple.png" target="_blank">
  <img src="/assets/images/modelli-vl-meta-prompting/4B-Simple.jpg" style="margin:6px;" />
</a></p>

<h3 id="qwen3-vl-4b-instruct-con-detailed-description">Qwen3-VL-4B-Instruct con Detailed Description</h3>
<p>La modalità <code class="language-plaintext highlighter-rouge">Detailed Description</code> dovrebbe produrre un paragrafo dettagliato di 2-3 frasi che combini aspetti quali soggetto, azione, ambientazione, composizione / illuminazione e <code class="language-plaintext highlighter-rouge">mood</code> dell’immagine. Nel nostro caso otteniamo:</p>
<pre class="page-scroll-box">
Under a vast, moody sky streaked with twilight hues of orange and gray, two iconic Porsche sports cars—a sleek black modern model and a classic white vintage coupe—rest side by side on an asphalt overlook, their polished surfaces reflecting the fading light as distant mountains loom behind them; the scene exudes quiet power and timeless elegance, capturing a moment where engineering heritage meets contemporary performance against nature’s dramatic backdrop.
</pre>
<p>Il linguaggio è sicuramente più ricco rispetto al preset <code class="language-plaintext highlighter-rouge">Simple</code>, l’abbondante uso di aggettivi contribuisce a definire meglio l’atmosfera e l’<code class="language-plaintext highlighter-rouge">emozione</code> che l’immagine dovrebbe trasmettere; inoltre viene recepito il fatto che le auto sono due modelli differenti, per Qwen la nera più moderna e la bianca classica / vintage.
L’immagine generata a partire dal testo è effettivamente un po’ più espressiva, ad esempio per i colori del cielo. Abbiamo sempre le strisce bianche sull’asfalto.</p>

<p><a href="/assets/images/modelli-vl-meta-prompting/4B-Detailed.png" target="_blank">
  <img src="/assets/images/modelli-vl-meta-prompting/4B-Detailed.jpg" style="margin:6px;" />
</a></p>

<h3 id="qwen3-vl-4b-instruct-con-ultra-detailed-description">Qwen3-VL-4B-Instruct con Ultra Detailed Description</h3>
<p>Il passaggio al preset <code class="language-plaintext highlighter-rouge">Ultra Detailed Description</code>, il cui prompt richiede una descrizione estremamente ricca che punti ad una rappresentazione immersiva, porta ad un testo generato di una decina di periodi. Se da un lato il modello coglie dettagli estetici dei veicoli, le luci accese di uno dei due, etc., dall’altro sembra quasi lanciarsi in interpretazioni al limite del filosofico sul significato dell’immagine. Da un punto di vista linguistico, il testo prodotto è comunque ben oltre quanto un umano (nativo nella lingua prescelta) avrebbe realisticamente scritto per descrivere un’immagine.</p>
<pre class="page-scroll-box">
The scene unfolds like a cinematic still from a high-end automotive drama—two Porsche legends poised against nature’s grandeur under a sky that whispers of twilight’s final sigh.

Dominating the left foreground is a matte-black 1990s-generation Porsche 911 (likely a Turbo or Carrera RS variant), its glossy surface absorbing ambient light yet reflecting it with deep, velvety intensity. The car's bodywork gleams subtly as if kissed by moonlight—or perhaps dawn’s last blush—that bleeds across the horizon. Its aerodynamic curves are sculpted into aggression: sharp lines along the fenders taper to muscular wheel arches housing multi-spoke alloy wheels polished to mirror-like perfection; each spoke catches the fading glow, casting faint geometric reflections onto the asphalt below. A prominent rear spoiler flares upward, hinting at hidden power beneath this sleek shell. Headlights illuminate softly—their circular halos glowing amber-yellow—as though ready to pierce darkness before they’ve fully surrendered their duty to dusk. Below them, the front bumper integrates subtle air intakes while maintaining clean elegance. Even the side skirts appear custom-fitted, suggesting performance tuning beyond factory specs—a whispered promise of raw mechanical prowess.

To its right, slightly receding but equally commanding, sits another icon—an immaculate white 1970s-era Porsche 911 coupe. This classic beauty exudes timeless charm through minimalist design language. Its paint job shimmers almost ethereal under soft illumination, catching every contour without glare—even where shadow falls upon it—it retains luminosity thanks to careful lighting management inherent within the composition itself. Along the lower edge runs a thin black stripe bearing “PORSCHE” embossed delicately above the rocker panel line—an elegant signature acknowledging heritage rather than rebellion. Silver-rimmed wheels echo those seen earlier but carry different weight—they feel older, more nostalgic—and paired perfectly with chrome trim accents around windowsills and door handles which glint warmly despite surrounding gloominess. Tail lights blink gently off-key, signaling readiness even now when motion has ceased entirely.

Behind these machines looms a rugged mountain range stretching far into distance. Their slopes rise steeply toward jagged peaks draped lightly in misty haze, covered partially in sparse vegetation clinging tenaciously to rocky outcrops. Bare trees dot sparsely scattered patches near ridgelines, standing sentinel amidst silence. Farther back, layers of hills fade progressively until only silhouettes remain visible against the vastness behind them.

Above all lies the most arresting element —the heavens themselves. Thick clouds swirl lazily overhead, swirling patterns resembling smoke caught mid-motion, darkened grey-blue tones broken intermittently by streaks of pale gold-orange radiance seeping between creases. These wisps form delicate veils over distant horizons where sun dips low enough to cast long fingers of warm color directly downward—not quite sunset per se—but something closer to pre-dusk calmness. Light filters diffusely here, creating gentle gradients instead of harsh contrasts. Shadows stretch dramatically outward from both vehicles’ undersides and edges, elongated due to camera angle combined with time-of-day positioning. They don’t overpower features; instead, they frame forms precisely, enhancing dimensionality and grounding presence firmly among earthbound reality.

As one gazes deeper, attention shifts naturally towards how everything interacts harmonically—with no single object dominating space except perhaps the two Porsches who stand shoulder-to-shoulder atop concrete terrain speckled unevenly with gravel bits and small stones. That pavement feels worn down but sturdy, textured irregularities contrasting sharply with smooth surfaces of cars' bodies. It serves not merely as stage floor but also anchor point anchoring entire universe together visually.

This photograph captures more than mere objects—it encapsulates emotion: awe mixed with reverence. There's quietude amid dynamic energy implied silently by parked state juxtaposed against looming mountains awaiting wind-driven action. One senses anticipation lurking just outside frame boundaries waiting patiently… Perhaps tomorrow morning will bring racing tires gripping tarmac again? Or maybe simply appreciation of craftsmanship etched deeply into metal skin?

In essence, we witness not just automobiles but living sculptures born from engineering genius placed deliberately beside natural splendor—all bathed simultaneously in atmospheric grace whose warmth lingers longer than any engine note ever could. Every curve, hue, texture speaks volumes about artistry fused seamlessly with function. And so does the moment suspended forever—in perfect balance-between human ingenuity and elemental majesty.
</pre>

<p>In termini di resa fotografica, l’immagine prodotta da Z-Image interpretando (attraverso Qwen3) il prompt qui sopra migliora sicuramente il risultato rispetto ai casi precedenti sia come qualità dei dettagli che come somiglianza all’originale, pur rimanendo comunque distante. Alcuni dei dettagli presenti nel prompt (la scritta PORSCHE sull’auto bianca, ad esempio) risultano mancanti.</p>

<p><a href="/assets/images/modelli-vl-meta-prompting/4B-UltraDetailed.png" target="_blank">
  <img src="/assets/images/modelli-vl-meta-prompting/4B-UltraDetailed.jpg" style="margin:6px;" />
</a></p>

<h3 id="qwen3-vl-4b-instruct-con-cinematic-description">Qwen3-VL-4B-Instruct con Cinematic Description</h3>

<p>Il prompt associato al preset <code class="language-plaintext highlighter-rouge">Cinematic Description</code> richiede la generazione di un paragrafo vivido ed effettivamente nulla da dire in fatto di intensità e coinvolgimento della descrizione qui sotto:</p>
<pre class="page-scroll-box">
In this cinematic widescreen composition, two legendary Porsche sports cars — a sleek, matte-black 911 Turbo RSR on the left and a pristine white classic 911 Carrera with racing stripes on the right — stand poised like silent warriors against an apocalyptic twilight sky streaked with bruised purples, deep grays, and molten orange near the horizon. The black machine dominates foreground space, its aggressive stance accentuated by custom alloy wheels and lowered suspension; headlights glow warmly, casting sharp reflections across the cracked asphalt that hints at rugged terrain or abandoned airstrip. Behind them, jagged mountain ridges loom under a vast, moody canvas of clouds swirling above, their silhouettes softened yet imposing. As dusk settles, ambient light bathes both vehicles in dramatic chiaroscuro: highlights glint off chrome trim and glossy paintwork while shadows deepen into mystery beneath the chassis. This is not merely photography—it’s theater: tense, reverent, evocative—where mechanical elegance meets raw natural drama. Shot with hyperreal precision but rendered through subtle film grain and selective color grading to mimic high-end cinematography, every curve and crease pulses with narrative weight. A contemplative stillness pervades, inviting viewers to imagine engine revs echoing unseen—or perhaps just silence between legends. It feels less like a photograph and more like a frame from a grand automotive epic set for eternity atop the edge of the world.
</pre>
<p>I colori, le ombre, etc dell’immagine generata rispecchiano, almeno in parte, la poesia del testo. Chiaramente il preset in questo caso influenza esplicitamente la resa finale, tuttavia complice la tipologia dell’immagine di riferimento, in qualche modo “cinematografica” già di per sè, abbiamo in generale una bella foto.</p>

<p><a href="/assets/images/modelli-vl-meta-prompting/4B-Cinematic.png" target="_blank">
  <img src="/assets/images/modelli-vl-meta-prompting/4B-Cinematic.jpg" style="margin:6px;" />
</a></p>

<h3 id="qwen3-vl-4b-instruct-con-detailed-analysis">Qwen3-VL-4B-Instruct con Detailed Analysis</h3>

<p>In modalità <code class="language-plaintext highlighter-rouge">Detailed Analysis</code> ci si aspetta che il modello <code class="language-plaintext highlighter-rouge">VL</code> produca una descrizione dettagliata e strutturata, divisa in sezioni separate per i vari aspetti. Effettivamente il lungo e ricco testo ottenuto isola e approfondisce soggetto, accessori e “estetica”, sfondo e composizione dell’immagine. Otteniamo tanti dettagli sui due veicoli le cui differenze sembrano venire recepite da Qwen3-VL. Inoltre, finalmente abbiamo un’approfondita parte del prompt dedicata alla composizione dell’immagine, comprendente posizionamento dei soggetti, palette di colori e tecniche di illuminazione, ottica (tipo di obbiettivo) utilizzata, etc.</p>
<pre class="page-scroll-box">
Certainly! Here is a detailed breakdown of the provided image:

—

**Subject:**

The primary subjects are two Porsche sports cars parked on an open asphalt surface.

- **Left Car (Foreground):**
  - A modern black Porsche 911 Turbo or similar high-performance model.
  - Features include:
    - Aggressive aerodynamic bodywork with prominent front air intakes and side skirts.
    - Large, multi-spoke silver alloy wheels — likely custom aftermarket rims given their design and finish.
    - Brightly lit headlights; turn signals also illuminated.
    - Low-slung stance suggesting performance tuning or lowered suspension.
    - Rear spoiler visible above the trunk lid for enhanced airflow control.

- **Right Car (Background / Right Side):**
  - An older-generation white Porsche 911, appearing to be from the late '70s/early '80s era (possibly a 911 Carrera RS).
  - Distinctive features:
    - Classic rounded fenders and iconic curved hoodline.
    - Black racing stripes running along the lower sides, bearing “PORSCHE” lettering.
    - Simple five-spoke steel wheels typical of its time period.
    - Clean lines without aggressive modifications compared to the left car’s sporty aesthetic.

Both vehicles showcase timeless German engineering while contrasting generations through styling cues and mechanical evolution.

---

**Attire &amp; Accessories:**

There is no human presence in either vehicle or around them—no driver, passenger, crew members, nor any individuals wearing clothing or carrying gear. The focus remains entirely on the automobiles themselves as objects of admiration and technical excellence.

Accessories associated directly with each car:
- Left car has LED daytime-running lights integrated into headlight assemblies and possibly additional fog lamps under the bumper area.
- Both feature factory OEM badges (“Porsche”) prominently displayed near rear wheel arches and center of hoods respectively.
- No personal items like helmets, gloves, tools, etc., appear present within view.

No wearable apparel exists since there's nobody depicted visually interacting with these machines.

---

**Background Elements:**

Behind the two Porsches stretches dramatic natural scenery:

- Rolling mountain ranges stretch horizontally across mid-ground behind the scene.
- Mountains vary slightly in elevation but maintain consistent rocky textures covered sparsely by vegetation such as scrub brush or small trees clinging to slopes.
- Horizon line marks where sky meets land at dusk/dawn transition zone—a soft gradient between warm orange-pink tones near ground level fading upward toward cooler grays/blues overhead.
- Sky dominates upper half of frame filled densely with dynamic cloud formations that suggest motion blur effect captured via long exposure technique during twilight hours.
  
Overall atmosphere evokes solitude, grandeur, power—and perhaps nostalgia juxtaposed against innovation represented by both models’ designs.

---

**Composition Analysis:**

This photograph employs strong compositional techniques designed to highlight contrast and visual interest among elements presented.

- **Leading Lines:** Asymmetrical placement positions viewer eye naturally drawn first towards dominant foreground object—the sleek black turbo sedan—with secondary attention shifting rightward onto classic white coupe due to spatial depth cue created by perspective convergence point extending off-screen horizon.
  
- **Framing Techniques Used:**
   - Wide-angle lens utilized which captures expansive vista including entire mountainscape beneath massive canopy of clouds stretching beyond edges of canvas.
   - Use of negative space effectively isolates focal points allowing individual characteristics of each automobile stand out clearly despite being placed apart geographically relative to one another.
   
- **Color Palette Strategy:**
   - Dominant dark gray/black hues dominate automotive surfaces creating sense of sophistication yet grounded realism.
   - White Porsche provides stark tonal opposition enhancing visibility and emphasizing elegance inherent in vintage appeal.
   - Warm sunset glow subtly illuminating distant peaks adds emotional warmth counterbalancing otherwise somber mood established by overcast skies.

- **Light Directionality:**
   - Ambient light originates low angle close to horizon indicating golden hour lighting conditions ideal for accentuating contours and metallic finishes.
   - Reflections caught upon glossy paint jobs confirm reflective quality characteristic of premium manufacturing materials used in original construction.

In summary, careful manipulation of color scheme, directional illumination, framing balance—all contribute significantly to elevating narrative impact surrounding relationship between past legacy and future aspirations embodied by these legendary European supercars set against majestic backdrop of nature’s scale.

--- 

Let me know if you’d like further analysis related specifically to camera settings, editing choices, symbolism, or historical context regarding the specific models shown here!

[Note: Since neither vehicle appears explicitly labeled "Carrera" or other exact model names based solely on appearance alone unless confirmed later.]
</pre>
<p>Da notare che la versione del custom node QwenVL utilizzata non sembra effettuare opportuna pulizia del testo generato dal modello prima di ritornarlo all’utente: troviamo infatti due frasi tipiche di contenuti generati da AI all’inizio (un generale ringraziamento e accettazione della richiesta) e alla fine (offerta di approfondire l’argomento).
In ogni caso, complice anche il formato quadrato esplicitamente richiesto in fase di generazione, l’immagine generata sembra non rispettare appieno le indicazioni riguardo l’inquadratura: la ripresa avrebbe potuto essere più grandangolare e l’uso della tecnica dello spazio negativo è sostanzialmente assente, tanto che la scritta PORSCHE sull’auto bianca è quasi completamente coperta dall’auto nera.</p>

<p><a href="/assets/images/modelli-vl-meta-prompting/4B-DetAnalysis.png" target="_blank">
  <img src="/assets/images/modelli-vl-meta-prompting/4B-DetAnalysis.jpg" style="margin:6px;" />
</a></p>

<h3 id="qwen3-vl-8b-instruct-con-detailed-analysis">Qwen3-VL-8B-Instruct con Detailed Analysis</h3>

<p>Decido a questo punto di provare ad utilizzare un modello Qwen3-VL più grande (8B) per verificare se si ottengano risultati migliori.</p>
<pre class="page-scroll-box">
Of course. Here is a detailed breakdown of the image, organized by your requested categories.

---

**Subject:**

The primary subjects are two iconic Porsche 911 sports cars positioned on an open asphalt surface against a dramatic mountain backdrop at dusk or dawn.
- **Car on the Left (Foreground):** A black Porsche 993 Turbo S (or similar high-performance variant), characterized by its aggressive styling. Key features include:
    - Large rear spoiler integrated with the roofline.
    - Wide fenders and muscular bodywork typical of the "Turbo" models from that era.
    - Distinctive front air intakes below the headlights.
    - Silver multi-spoke alloy wheels.
    - The car’s headlamps are illuminated, casting a warm glow.
- **Car on the Right (Background/Distance):** A white classic Porsche 911 Carrera RS-style model, likely from the late 1970s to early 1980s. Features include:
    - Classic round headlights.
    - Black racing stripes running along the sides, bearing the word “PORSCHE” in capital letters.
    - Smaller, more minimalist side mirrors compared to modern Porsches.
    - Standard steelies or smaller-diameter alloys.
    - Its lights appear off, emphasizing its silhouette as it recedes into the scene.

Both vehicles exude performance heritage and timeless design, creating a visual dialogue between generations of automotive engineering.

---

**Attire / Accessories:**

There are no people visible in the photograph, so there is no human attire to describe.

However, both cars serve as their own form of accessory within the frame:

- **Accessories for Car #1 (Black Turbo):**
    - Custom widebody kit enhancing aerodynamics and aggression.
    - Performance-oriented suspension evident through low stance.
    - Factory or aftermarket wheel choice complementing its sporty character.
    - Functional lighting system including fog lamps or auxiliary driving lights under the bumper.

- **Accessories for Car #2 (White Classic):**
    - Racing stripe decals — not just cosmetic but historically significant for track use.
    - Original factory bumpers and trim pieces consistent with period-correct restoration.
    - Simple, functional door handles matching the vintage aesthetic.

Together, these elements function as narrative devices—showcasing evolution while honoring tradition.

---

**Background:**

The setting provides immense atmosphere and context:

- **Sky:** Dominated by heavy clouds streaked horizontally across the upper portion, suggesting either fast-moving weather systems or long-exposure photography capturing motion blur over time. Near the horizon, soft gradients transition from deep gray-blue above to pale orange-yellow where sunlight breaks through, indicating sunset or sunrise.
  
- **Mountains/Ridges:** Jagged, rocky ridgelines stretch behind the cars, adding depth and scale to the landscape. Their muted earth tones contrast beautifully with the vibrant sky colors. Sparse vegetation clings precariously to some slopes.

- **Ground Surface:** An expansive flat paved area—a possible airstrip, test track, or remote parking lot—which allows full appreciation of both vehicles without obstruction. Cracks and texture suggest age or exposure to environmental conditions.

This natural environment serves as a powerful foil to the man-made machines; it evokes solitude, raw power, and endurance—all qualities associated with legendary racecars like those depicted here.

---

**Composition:**

The photographer has crafted a carefully balanced and visually compelling arrangement using several compositional techniques:

- **Rule of Thirds &amp; Diagonal Balance:** Both cars occupy distinct thirds—one near left foreground, one right mid-ground—with space allocated around them to create breathing room and avoid clutter. This creates dynamic tension yet harmony between the pair.

- **Leading Lines &amp; Depth Perception:** The road's edge curves gently toward the mountains, subtly guiding viewer attention inward and upward towards the light source. Additionally, the diagonal alignment formed by the cars’ orientation adds energy and movement even though they’re stationary.

- **Contrast Through Color &amp; Lighting:** High contrast exists between the dark storm-laden skies versus the glowing horizons. Similarly, the matte finish of the black car contrasts sharply with the bright reflective surfaces of the white vehicle. Warm ambient light highlights parts of each car differently—the driver-side mirror glows warmly on the black car, whereas shadows dominate much of the white car—but both catch enough reflected hues to remain cohesive.

- **Framing &amp; Negative Space:** The vast empty spaces surrounding the main subjects emphasize isolation and grandeur. Mountains act naturally as framing borders, while negative space ensures focus remains squarely on the automobiles themselves rather than distracting details elsewhere.

In summary, this image successfully marries technical precision with artistic vision—to present not merely photographs of luxury supercars, but cinematic moments frozen forever amidst nature’s majestic drama. It tells stories about legacy, innovation, beauty, speed—and ultimately, passion—for what lies beneath every polished curve and gleaming panel.
</pre>

<p>La descrizione risulta più dettagliata della corrispondente prodotta dal modello 4B, ma il risultato finale al termine della fase di generazione della nuova immagine è solo leggermente migliore. In ogni case, forse la migliore immagine fino a questo punto.</p>

<p><a href="/assets/images/modelli-vl-meta-prompting/8B-DetAnalysis.png" target="_blank">
  <img src="/assets/images/modelli-vl-meta-prompting/8B-DetAnalysis.jpg" style="margin:6px;" />
</a></p>

<h3 id="qwen3-vl-8b-instruct-con-cinematic-description">Qwen3-VL-8B-Instruct con Cinematic Description</h3>

<p>Per completare il quadro, vediamo cosa produce il workflow sempre col modello Qwen3-VL 8B e preset <code class="language-plaintext highlighter-rouge">Cinematic Description</code>:</p>

<pre class="page-scroll-box">
Under a vast, brooding sky streaked with twilight’s bruised purples and molten golds, two legendary Porsche 911s stand poised like silent sentinels on an open asphalt plateau flanked by rugged, shadow-draped mountains—a cinematic tableau of power and elegance frozen at dusk. The foreground is dominated by a sleek, matte-black 993 Turbo S, its aggressive stance emphasized by low-slung lines, wide fenders, and gleaming multi-spoke wheels; headlights glow warmly against its dark form, casting sharp reflections that hint at motion even when still. To its right, slightly receding into atmospheric depth, rests a pristine white 964 Carrera RS, its classic curves softened yet defined by racing stripes and minimalist design—its own quiet intensity radiating from beneath the fading light. The dramatic chiaroscuro effect sculpts their forms: cool shadows pool under chassis while highlights dance across polished surfaces, creating tactile contrast between metallic sheen and weathered pavement. A sense of timeless rivalry or harmonious dialogue hangs heavy in the air—the black car roaring forward, the white gliding backward—as though they’re not merely vehicles but characters caught mid-narrative within this epic landscape. Shot in photorealistic precision with painterly composition, every detail—from tire texture to cloud wisps—is rendered with hyper-real clarity, evoking both documentary truth and romanticized mythos, where engineering meets artistry under skies painted for drama alone.

**Visual Impact:** Stark contrasts, dynamic silhouettes, rich color gradients, deep textures, and emotional resonance through juxtaposition create a visually arresting moment suspended between speed and serenity — perfect for posterity.
</pre>

<p>La descrizione enfatizza l’impatto visivo atteso per l’immagine, tuttavia in generale il testo prodotto non si discosta in maniera significativa da quello prodotto dal modello più piccolo. Anche l’immagine generata appare molto simile (i fari dell’auto nera però sono accesi questa volta).</p>

<p><a href="/assets/images/modelli-vl-meta-prompting/8B-Cinematic.png" target="_blank">
  <img src="/assets/images/modelli-vl-meta-prompting/8B-Cinematic.jpg" style="margin:6px;" />
</a></p>

<hr />

<h2 id="meta-prompting-generare-prompt-a-partire-da-prompt">Meta-prompting: generare prompt a partire da prompt</h2>

<p>Un’ulteriore evoluzione del workflow consiste nel <strong>non passare più un’immagine</strong> a QwenVL, ma una <strong>coppia di stringhe testuali</strong>:</p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">prompt</code>: una descrizione semplice (ad esempio ottenuta precedentemente con <em>Simple Description</em>)</li>
  <li><code class="language-plaintext highlighter-rouge">formula</code>: un <strong>meta-prompt</strong> che chiede esplicitamente di generare un prompt con determinate caratteristiche.</li>
</ul>

<p>Nel nostro caso, ho optato per richiedere un prompt ottimizzato per il fotorealismo derivante dalla sensazione che l’immagine sia una fotografia analogica 35mm. Ho chiesto a ChatGPT di aiutarmi a <em>scrivere un prompt che generi un prompt che…</em> e alla fine ho ottenuto questo:</p>
<pre class="page-scroll-box">
Per favore analizza l'immagine allegata e scrivimi un prompt di miglioria specifico per trasformarla in una fotografia in stile analogico 35mm, con questi obiettivi: realismo estremo, forte drammaticità, atmosfera da pellicola vissuta, difetti coerenti con il film (grain, halation, flare, colori meno perfetti). Includi nel prompt specifico: tipi di grana realistica (fine/medium), halation attorno a luci e contrasti, leggero fading dei colori o tonalità vintage, vignettatura organica e bordi leggermente morbidi, micro-imperfezioni: polvere, graffi, disallineamenti, errori di esposizione o bilanciamento del bianco plausibili, elementi narrativi coerenti con la scena che aumentano la sensazione di “scatto su pellicola".
</pre>

<p>Opportunamente tradotto (da Gemini) e leggermente adattato per il campo <code class="language-plaintext highlighter-rouge">Formula</code>, ecco il nuovo prompt inserito nel workflow:</p>

<p><a href="/assets/images/modelli-vl-meta-prompting/formula.jpg" target="_blank">
  <img src="/assets/images/modelli-vl-meta-prompting/formula.jpg" style="margin:6px;" />
</a></p>

<p>Un paio di esempi di immagini generate con preset <code class="language-plaintext highlighter-rouge">Detailed Description</code> a partire dal prompt semplice:</p>

<p><a href="/assets/images/modelli-vl-meta-prompting/meta-prompt1.png" target="_blank">
  <img src="/assets/images/modelli-vl-meta-prompting/meta-prompt1.jpg" style="margin:6px;" />
</a>
<a href="/assets/images/modelli-vl-meta-prompting/meta-prompt2.png" target="_blank">
  <img src="/assets/images/modelli-vl-meta-prompting/meta-prompt2.jpg" style="margin:6px;" />
</a></p>

<hr />

<h2 id="diritti-e-copyright-delle-immagini-generate-riduzione-del-rischio-non-immunità-legale">Diritti e copyright delle immagini generate: riduzione del rischio, non immunità legale</h2>

<p>Dopo aver visto nel dettaglio come funziona un workflow <strong>image-to-text seguito da text-to-image</strong>, è naturale chiedersi se questo approccio rappresenti anche una sorta di “via d’uscita” dal punto di vista dei diritti nel copiare immagini.
L’idea è seducente: invece di partire direttamente dall’immagine, la trasformo in testo; invece di modificare l’originale, genero qualcosa di nuovo. Ma quanto questa distanza tecnica corrisponde davvero a una distanza giuridica?</p>

<p>La risposta onesta è che <strong>I2T → T2I è uno strumento di mitigazione del rischio, non una garanzia legale</strong>.<br />
Funziona bene quando viene usato per <em>astrarre</em>, <em>interpretare</em>, <em>trasformare</em>. Funziona molto meno — o per nulla — quando viene usato per <em>ricostruire</em>.</p>

<p>Per capire perché, bisogna chiarire un punto fondamentale: <strong>i diritti non proteggono il percorso tecnico, ma il risultato finale</strong>.</p>

<hr />

<h3 id="il-passaggio-dal-testo-non-resetta-i-diritti">Il passaggio dal testo non “resetta” i diritti</h3>

<p>Uno degli equivoci più comuni è pensare che il diritto protegga il mezzo — il file, i pixel, il formato.
In realtà, sia nel diritto d’autore sia nel diritto all’immagine <strong>conta l’opera risultante</strong>, non il fatto che sia stata generata “a mano”, con Photoshop o con un modello AI.</p>

<p>Se un’immagine generata è:</p>

<ul>
  <li>sostanzialmente simile a un’opera esistente</li>
  <li>riconducibile a una persona reale</li>
  <li>funzionalmente sostitutiva di un’immagine protetta</li>
</ul>

<p>allora il fatto che sia passata da una descrizione testuale <strong>non costituisce una difesa automatica</strong>.</p>

<p>È vero però che <strong>I2T introduce una distanza semantica</strong> che, se gestita con criterio, rende più difficile arrivare a risultati “troppo vicini” all’originale. Ma questa distanza va <strong>costruita intenzionalmente</strong>, non data per scontata.</p>

<hr />

<h3 id="diritto-dautore-quando-la-somiglianza-conta-più-della-tecnica">Diritto d’autore: quando la somiglianza conta più della tecnica</h3>

<p>Nel caso delle immagini (e in particolare delle fotografie), il diritto d’autore tutela l’impronta creativa: composizione, luce, scelta del momento, inquadratura.
Non serve una copia perfetta perché si parli di opera derivata: è sufficiente che un osservatore medio riconosca nell’opera nuova l’essenza di quella precedente.</p>

<p>Nel workflow I2T → T2I il rischio aumenta quando:</p>

<ul>
  <li>la descrizione estratta dall’immagine è eccessivamente specifica</li>
  <li>il prompt ricostruisce la stessa posa, la stessa luce, lo stesso mood</li>
  <li>il risultato “sembra chiaramente quella foto, rifatta”</li>
</ul>

<p>In questi casi, il passaggio intermedio dal testo <strong>non cambia la sostanza del problema</strong>.</p>

<hr />

<h3 id="uso-commerciale-e-sostituzione-funzionale">Uso commerciale e sostituzione funzionale</h3>

<p>C’è poi un aspetto spesso sottovalutato: <strong>la funzione dell’immagine</strong>, non solo la sua estetica.</p>

<p>Se un’immagine generata:</p>

<ul>
  <li>sostituisce una fotografia esistente in un contesto commerciale</li>
  <li>replica uno standard visivo (stock, advertising, cataloghi, hero image)</li>
</ul>

<p>si entra in un’area in cui il problema non è più solo creativo, ma <strong>economico</strong>.
Anche senza una somiglianza perfetta, l’uso può essere contestato se l’immagine AI prende il posto di un contenuto protetto sul mercato.</p>

<p>Il workflow I2T → T2I <strong>non elimina questo rischio</strong>, soprattutto se viene usato con l’obiettivo implicito di “rifare la stessa cosa senza pagare i diritti”.</p>

<hr />

<h3 id="persone-reali-e-il-nodo-della-model-release">Persone reali e il nodo della <em>model release</em></h3>

<p>Qui vale la pena fermarsi un attimo, perché è uno dei punti più fraintesi.</p>

<p>Nel linguaggio della fotografia professionale, una <em>model release</em> è il consenso con cui una persona autorizza l’uso della propria immagine, soprattutto in ambito commerciale.
Non riguarda il copyright della foto, ma il <strong>diritto all’immagine del soggetto ritratto</strong>.</p>

<p>Se una persona è riconoscibile, questo diritto <strong>non scompare</strong> perché:</p>

<ul>
  <li>l’immagine è stata rielaborata</li>
  <li>l’immagine è stata generata da un modello AI</li>
  <li>si è passati da testo invece che da pixel</li>
</ul>

<p>Questo vale anche nel workflow I2T → T2I.</p>

<p>Se l’immagine finale:</p>

<ul>
  <li>riproduce una persona reale riconoscibile</li>
  <li>o una “controfigura evidente” (stessi tratti, stessa identità percepita)</li>
</ul>

<p>il problema della model release <strong>rimane identico</strong>.</p>

<p>Per questo motivo, in ambito professionale, molte aziende preferiscono:</p>

<ul>
  <li>usare persone completamente sintetiche</li>
  <li>evitare riferimenti a individui reali</li>
  <li>lavorare su volti deliberatamente non riconducibili a nessuno</li>
</ul>

<p>Il flusso I2T → T2I può aiutare in questa direzione <strong>solo se l’obiettivo è creare persone nuove</strong>, non rifare persone reali “con un altro volto”.</p>

<hr />

<h2 id="conclusioni-in-ordine-sparso">Conclusioni (in ordine sparso)</h2>

<ul>
  <li>I modelli Vision-Language hanno un potenziale enorme, ben oltre la semplice descrizione di immagini</li>
  <li>La “lampada dell’AI” può essere usata anche per <strong>imparare a esprimere meglio i desideri</strong> : possiamo usare modelli Vision-Language per generare prompt iniziali a partire da immagini esistenti</li>
  <li>Il meta-prompting è uno strumento potente per migliorare i prompt senza diventare esperti linguisti: possiamo usare un LLM per creare un meta-prompt di ottimizzazione di un prompt/test esistente, e poi “applicarlo” a quanto ottenuto dal modello Vision-Language</li>
  <li>Z-Image Turbo riesce a produrre immagini estremamente realistiche con <strong>poche risorse e tempi ridotti</strong></li>
  <li>Prompt più lunghi non garantiscono necessariamente risultati migliori: conta cogliere gli elementi salienti. I preset del nodo QwenVL per ComfyUI usati per le prove offrono alcuni punti di partenza per generare i prompt. A seconda dell’immagine input, è possibile personalizzare i preset o sostituirli completamente con prompt che focalizzino l’attenzione su aspetti specifici, ad esempio inquadratura, o dettagli dell’immagine (Qwen3-VL non ha mai notato che sull’auto nera ci sono due persone, per dire, e che hanno un finestrino aperto). Opportuna pulizia dei prompt generati dal modello Vision-Language prima di passarlo alla generazione dell’immagine consentirebbe ulteriori migliorie della resa finale.</li>
  <li>Qwen3-VL mostra alcuni limiti di conoscenza specifica, in questo caso auto Porsche; a memoria di chi ha scattato la foto, i due modelli sono <em>993 RUF Turbo R</em> degli anni ‘90 (la nera) e <em>911 Singer</em> (la bianca). Per la cronaca, Gemini 3 Pro che pure ha avanzate capacità Vision-Language, sicuramente oltre quelle di Qwen3-VL 8B, ha comunque correttamente identificato solo la <em>Singer</em>.</li>
  <li>Il flusso I2T + T2I <strong>non è un passpartout legale</strong></li>
</ul>

<p>Ma proprio questi limiti rendono l’esperimento interessante: è un esempio concreto di cosa si può fare <strong>oggi</strong>, in locale, con strumenti aperti — e di quanto spazio ci sia ancora per migliorare.</p>

<p><em>Come sempre, il genio della lampada ascolta… ma bisogna imparare a parlare la sua lingua.</em></p>]]></content><author><name>Alessio Soldano</name></author><category term="AI locale" /><category term="LoRA" /><category term="Z-Image" /><category term="ComfyUI" /><category term="Qwen3-VL" /><category term="AMD Strix Halo" /><category term="copyright" /><category term="ComfyUI" /><summary type="html"><![CDATA[Proviamo alcuni workflow ComfyUI basati su Z-Image + Qwen3-VL e ragioniamo su “diritti e utilizzabilità” delle immagini ottenute.]]></summary></entry><entry><title type="html">Coding agent: modelli locali vs API</title><link href="https://aladinodigitale.it/2025/12/03/coding-agent-modelli-locali-vs-api.html" rel="alternate" type="text/html" title="Coding agent: modelli locali vs API" /><published>2025-12-03T00:00:00+00:00</published><updated>2025-12-03T00:00:00+00:00</updated><id>https://aladinodigitale.it/2025/12/03/coding-agent-modelli-locali-vs-api</id><content type="html" xml:base="https://aladinodigitale.it/2025/12/03/coding-agent-modelli-locali-vs-api.html"><![CDATA[<p>A inizio Novembre mi sono cimentato in alcuni test di sviluppo software attraverso Claude Code integrato (via Claude Code Router) con modelli openweight GPT OSS eseguiti in locale.</p>

<p>Nelle ultime settimane, invece, ho voluto sperimentare due coding agent specificamente concepiti per servirsi di svariati modelli (openweight e commerciali) in locale o in remoto. Ho dunque scelto di provare <a href="https://kilo.ai/">Kilo Code</a> e <a href="https://cline.bot/">Cline</a>; entrambi sono disponibili come estensioni di molti dei principali IDE, tra i quali ho scelto <a href="https://code.visualstudio.com/">VS Code</a>.</p>

<h2 id="lo-scenario-di-test">Lo scenario di test</h2>
<p>Come scenario di test, di nuovo ho scelto di “proseguire lo sviluppo” del piccolo progetto opensource (<a href="https://github.com/asoldano/onnx-model-generator-docker">onnx-model-generator-docker</a>) che già avevo usato in precedenza: in sintesi, ricordo che si tratta di un servizio REST Dockerizzato che converte modelli HuggingFace in formato Open Neural Network Exchange (ONNX) utilizzando la libreria <em>onnxruntime-genai</em>: riceve una richiesta HTTP e restituisce un modello ottimizzato pronto da scaricare.</p>

<p>In precedenza avevo chiesto a Claude di elencare le possibili migliorie, in particolare in ambito di sicurezza, e di salvarne la lista insieme alla documentazione di progetto; ho dunque utilizzato il seguente semplice prompt per dare il via alle operazioni di Cline e Kilo Code in tutte le prove qui descritte:</p>

<p><code class="language-plaintext highlighter-rouge">
Hi, please have a look at the project, including the .md files and figure out what the next improvement task to work on would be, then prepare for completing it (including  testing and updating the existing .md documents)
</code></p>

<p>Il primo task su cui lavorare, dato lo <a href="https://github.com/asoldano/onnx-model-generator-docker/tree/05996137294a7802914caacd0130444242080bc8">stato corrente</a> del progetto, era quello di aggiungere il <em>rate limiting</em>, ossia permettere di controllare il numero massimo di richieste al minuto verso il servizio Docker da un dato indirizzo IP.</p>

<h2 id="i-modelli-utilizzati">I modelli utilizzati</h2>
<p>Per quanto concerne gli LLM utilizzati con i due coding agents, ho deciso di testare principalmente i <a href="https://z.ai/model-api">modelli GLM di Z.ai</a>. Tra questi, <a href="https://docs.z.ai/guides/llm/glm-4.6#introducting-glm-4-6"><strong>GLM 4.6</strong></a> si posiziona al livello di alcuni degli attuali modelli SOTA ed è disponibile per utilizzo remoto via API a prezzi decisamente ridotti rispetto alla concorrenza (il che presumo ne faccia o farà una scelta popolare). Inoltre, il modello è openweight, <a href="https://huggingface.co/zai-org/GLM-4.6">disponibile su huggingface.co</a> e dunque utilizzabile anche in locale… almeno in linea teorica.</p>

<p>Nella pratica, trattandosi di un modello da <strong>357 miliardi di parametri</strong>, l’inferenza su qualunque hardware consumer attuale è sostanzialmente preclusa a meno di ricorrere a quantizzazioni estremamente aggressive.</p>

<p>Per le prove in locale sul mio AMD Ryzen AI Max+ 395 (Strix Halo) con 128 GB di RAM condivisa ho dunque scelto di provare <strong>GLM 4.5-Air</strong>, ossia la versione snellita (<strong>106 miliardi di parametri</strong> in totale, 12 attivi - <em>Mixture of Experts</em>) di GLM 4.5, il modello precedente a GLM 4.6. GLM 4.5 è pubblicizzato come qualitativamente ancora comparabile con Claude 4 Sonnet, mentre 4.5-Air è dato come solo leggermente inferiore a 4.5 in termini di qualità della generazione. Per ridurre al minimo l’impatto della quantizzazione, ho scelto di utilizzare la <a href="https://huggingface.co/unsloth/GLM-4.5-Air-GGUF?show_file_info=Q5_K_M%2FGLM-4.5-Air-Q5_K_M-00001-of-00002.gguf">versione GGUF Q5_K_M diffusa su huggingface.co da Unsloth AI</a>. Ho effettuato il deploy del modello su <a href="https://lmstudio.ai/">LMStudio</a>, eseguendo tutti i layer in GPU e abilitando la Flash Attention.</p>

<p>Infine, ho anche rieseguito qualche prova con Cline abbinato allo stesso <a href="https://huggingface.co/openai/gpt-oss-120b">GPT-OSS-120B</a> usato in precedenza, per avere un riferimento.</p>

<h2 id="kilo-code">Kilo Code</h2>

<h3 id="configurazione">Configurazione</h3>
<p>Dopo aver completato l’installazione in VS Code, Kilo Code si configura per connettersi a differenti tipi di modelli LLM utilizzando la scheda <em>Providers</em> all’interno della sezione <em>Settings</em>.</p>

<p><a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-conf.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-conf.jpg" alt="Configurazione Kilo Code" style="margin-bottom:20px;" />
</a></p>

<p>Nel caso dei modelli remoti, ho selezionato <em>Z AI</em> come API provider (<em>International</em> entrypoint) e copiato la mia API key generata su sito di Z.ai dopo aver sottoscritto il piano <em>Lite</em> (9 USD a trimestre); ho abilitato il <em>reasoning</em> e lasciato invariate tutte le altre impostazioni.</p>

<p>Per utilizzare il modello GLM 4.5-Air in locale, invece, prima di tutto ho avviato il server LMStudio ed eseguito il deploy del modello utilizzando una finestra di contesto di <strong>65k</strong> token, così da avere un buon compromesso tra velocità di inferenza / memoria utilizzata e lunghezza della “conversazione” tra agente e modello. Poi nelle impostazioni di Kilo Code ho selezionato <em>LM Studio</em> della lista di API Provider supportati e scelto <em>glm-4.5-air</em> tra le opzioni presentate automaticamente (ottenute da Kilo Code interrogando il server LM Studio attraverso Open API). Anche qui non ho apportato ulteriori cambiamenti alle impostazioni avanzate.</p>

<h3 id="modalità-di-funzionamento">Modalità di funzionamento</h3>
<p>Kilo Code può adattare il suo comportamento a seconda della <a href="https://kilo.ai/docs/basic-usage/using-modes">modalità (mode) di funzionamento</a> selezionata. Le modalità disponibili di default (è possibile infatti impostarne di personalizzate) tra cui scegliere sono <code class="language-plaintext highlighter-rouge">Code</code>, <code class="language-plaintext highlighter-rouge">Ask</code>, <code class="language-plaintext highlighter-rouge">Architect</code>, <code class="language-plaintext highlighter-rouge">Debug</code> e <code class="language-plaintext highlighter-rouge">Orchestrator</code>; ognuna di esse si caratterizza per differenti “personalità”, ottimizzazioni e accesso (nonché permesso di esecuzione) a tool: lettura/scrittura file, MCP, browser, comandi shell, … L’idea è che si scelga la modalità di esecuzione più adatta al compito da compiere.</p>

<p>Per semplicità, ho selezionato <code class="language-plaintext highlighter-rouge">Architect</code> per la prima fase di esecuzione (il prompt parla di “comprendere quale sia il prossimo task…” e di “prepararsi a completarlo”), per poi passare in modalità <code class="language-plaintext highlighter-rouge">Code</code> per la successiva fase implementativa.</p>

<h3 id="prove-effettuate">Prove effettuate</h3>

<p>Come anticipato sopra, ho sperimentato tre differenti scenari di utilizzo, con tre differenti modelli / API Provider: GLM 4.6 in remoto, GLM 4.5-Air in remoto, GLM 4.5-Air in locale. Qui sotto riporto una selezione di screenshot catturati durante le prove.</p>

<p><strong>GLM 4.6 in remoto</strong></p>

<p><a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm46-A.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm46-A.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm46-B.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm46-B.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm46-C.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm46-C.jpg" style="height:110px;margin:6px;" />
</a></p>

<p><a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm46-D.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm46-D.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm46-E.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm46-E.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm46-F.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm46-F.jpg" style="height:110px;margin:6px;" />
</a></p>

<p><strong>GLM 4.5-Air in remoto</strong></p>

<p><a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm45air-A.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm45air-A.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm45air-B.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm45air-B.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm45air-C.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm45air-C.jpg" style="height:110px;margin:6px;" />
</a></p>

<p><a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm45air-D.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm45air-D.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm45air-E.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm45air-E.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm45air-F.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm45air-F.jpg" style="height:110px;margin:6px;" />
</a></p>

<p><strong>GLM 4.5-Air in locale</strong></p>

<p><a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-lms-glm45air-A.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-lms-glm45air-A.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-lms-glm45air-B.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-lms-glm45air-B.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-lms-glm45air-C.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-lms-glm45air-C.jpg" style="height:110px;margin:6px;" />
</a></p>

<p><a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-lms-glm45air-D.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-lms-glm45air-D.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-lms-glm45air-E.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-lms-glm45air-E.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-lms-glm45air-F.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-lms-glm45air-F.jpg" style="height:110px;margin:6px;" />
</a></p>

<p>In tutti gli scenari il compito richiesto è stato completato con successo: l’agente ha compreso quale fosse il prossimo task a cui lavorare ed è stato in grado di completarlo (nel caso di GLM 4.5-Air locale, a dire il vero, ha preparato una lista di task a cui lavorare, il primo dei quali quello che ci si attendeva).</p>

<p>In puro stile <em>“vibe coding”</em>, ho lasciato lavorare l’agente in autonomia, rispondendo a domande chiuse (scelta multipla) e confermando manualmente le sole esecuzioni dei tool (per le testsuite) e il passaggio alla fase di coding. Le analisi condotte nella prima fase hanno evidenziato differenti livelli di approfondimento e chiarezza nello spiegare il piano; in accoppiata con GLM 4.6, Kilo ha fatto un ottimo lavoro generando, tra le altre cose, una domanda con 4 possibili risposte pre-confezionate (per verificare le intenzioni dell’utente) e un diagramma di flusso della logica da implementare.</p>

<p><a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm46-domande.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm46-domande.jpg" alt="Domande a scelta multipla" style="margin-bottom:20px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm46-domande.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/kilo-glm46-diagramma-flusso.jpg" alt="Domande a scelta multipla" style="margin-bottom:20px;" />
</a></p>

<p>In tutti i casi il sistema è stato in grado di <strong>generare test</strong> per la nuova funzionalità (risolvendo fallimenti quando si sono presentati) ed <strong>aggiornare la documentazione</strong>.</p>

<p>Per quanto concerne i tempi di esecuzione, non è possibile fare un vero confronto, considerato il non determinismo che porta a percorsi di risoluzione del problema ed esecuzione completamente differenti, tuttavia la versione in locale è risultata in generale leggermente più lenta, ma la differenza è stata meno significativa di quanto mi aspettassi (Kilo spende diverso tempo anche “lato client”). Va comunque considerata anche la <strong>differente dimensione del contesto</strong>, l’utilizzazione del quale è chiaramente visibile negli screenshot.</p>

<h2 id="cline">Cline</h2>

<h3 id="configurazione-1">Configurazione</h3>
<p>Anche nel caso di Cline ho installato l’estensione VS Code. Una volta completata la procedura, di nuovo come per Kilo Code, il tab <em>Settings</em> di Cline consente di specificare l’<em>API Provider</em> (<em>Z.ai</em> e <em>LM Studio</em>, nel mio caso) e di fornire rispettivamente la chiave o l’URL del server e il nome del modello da utilizzare. Non dovendo utilizzare finestre di contesto molto piccole (inferiori a 8k), non ho abilitato l’utilizzo di prompt compatti.</p>
<p><a href="/assets/images/coding-agent-modelli-locali-vs-api/cline-conf.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/cline-conf.jpg" alt="Configurazione Cline" style="margin-bottom:20px;" />
</a></p>

<h3 id="modalità-di-funzionamento-1">Modalità di funzionamento</h3>
<p>Se Kilo Code dispone di diversi <em>modes</em>, Cline invece distingue tra <code class="language-plaintext highlighter-rouge">Plan mode</code> e <code class="language-plaintext highlighter-rouge">Act mode</code>. È possibile configurare Cline affinché utilizzi modelli differenti per le due modalità, selezionando ad esempio un modello <em>reasoning</em> in <code class="language-plaintext highlighter-rouge">Plan</code> e uno non <em>reasoning</em> in <code class="language-plaintext highlighter-rouge">Act</code>.</p>
<p>Considerato il prompt scelto per questi esperimenti, sono sempre partito con la modalità <code class="language-plaintext highlighter-rouge">Plan</code>, per poi autorizzare Cline a passare in modalità <code class="language-plaintext highlighter-rouge">Act</code> una volta preparato il piano d’intervento.</p>

<h3 id="prove-effettuate-1">Prove effettuate</h3>
<p>Con questo agente ho testato nuovamente GLM 4.6 remoto, mentre in locale ho provato ad utilizzare, sempre via LM Studio, <em>GPT-OSS-120B</em> che discrete soddisfazioni aveva dato negli <a href="https://aladinodigitale.it/2025/11/02/coding-agent-locale.html">esperimenti con Claude Code Router</a> (utilizzato però in parallelo ad un modello più piccolo, <em>GPT-OSS-20B</em>).</p>

<p>Ho utilizzato Cline in maniera simile a Kilo Code, sostanzialmente autorizzando sempre le richieste di utilizzo dei tool (nella configurazione di default, Cline lascia maggiore controllo all’utente rispetto a Kilo Code, che applica le modifiche ai file senza chiedere conferma) e lasciando che cercasse autonomamente di superare i problemi incontrati, risolvendo bachi, installando dipendenze, etc.</p>

<p>Qui sotto alcune immagini catturate durante l’esecuzione, come nel caso precedente. Da notare che, nella configurazione con GPT-OSS-120B, due tentativi di eseguire nuovamente il compito richiesto nel prompt sono falliti, con l’agente che non è riuscito a produrre un’implementazione funzionante che passasse i test.</p>

<p><strong>GLM 4.6 in remoto</strong></p>

<p><a href="/assets/images/coding-agent-modelli-locali-vs-api/cline-glm46-A.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/cline-glm46-A.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/cline-glm46-B.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/cline-glm46-B.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/cline-glm46-C.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/cline-glm46-C.jpg" style="height:110px;margin:6px;" />
</a></p>

<p><a href="/assets/images/coding-agent-modelli-locali-vs-api/cline-glm46-D.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/cline-glm46-D.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/cline-glm46-E.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/cline-glm46-E.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/cline-glm46-F.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/cline-glm46-F.jpg" style="height:110px;margin:6px;" />
</a></p>

<p><strong>GPT-OSS-120B in locale</strong></p>

<p><a href="/assets/images/coding-agent-modelli-locali-vs-api/cline-lms-gpt-A.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/cline-lms-gpt-A.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/cline-lms-gpt-B.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/cline-lms-gpt-B.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/cline-lms-gpt-C.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/cline-lms-gpt-C.jpg" style="height:110px;margin:6px;" />
</a></p>

<p><a href="/assets/images/coding-agent-modelli-locali-vs-api/cline-lms-gpt-D.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/cline-lms-gpt-D.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/cline-lms-gpt-E.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/cline-lms-gpt-E.jpg" style="height:110px;margin:6px;" />
</a>
<a href="/assets/images/coding-agent-modelli-locali-vs-api/cline-lms-gpt-F.jpg" target="_blank">
  <img src="/assets/images/coding-agent-modelli-locali-vs-api/cline-lms-gpt-F.jpg" style="height:110px;margin:6px;" />
</a></p>

<h2 id="analisi-risultati">Analisi risultati</h2>

<p>Sebbene sia stato possibile completare il task richiesto in tutti gli scenari, <strong>la qualità delle soluzioni ottenute non è necessariamente la stessa</strong>. Invece di effettuare il merge di una delle implementazioni sul main del progetto, ho creato un branch differente per ognuno degli scenari provati:</p>
<ul>
  <li>Kilo Code + GLM 4.6 remoto: <a href="https://github.com/asoldano/onnx-model-generator-docker/tree/kilo-glm-4.6">https://github.com/asoldano/onnx-model-generator-docker/tree/kilo-glm-4.6</a></li>
  <li>Kilo Code + GLM 4.5-Air remoto: <a href="https://github.com/asoldano/onnx-model-generator-docker/tree/kilo-glm-4.5-air">https://github.com/asoldano/onnx-model-generator-docker/tree/kilo-glm-4.5-air</a></li>
  <li>Kilo Code + GLM 4.5-Air locale: <a href="https://github.com/asoldano/onnx-model-generator-docker/tree/kilo-lms-glm-4.5-air-65k">https://github.com/asoldano/onnx-model-generator-docker/tree/kilo-lms-glm-4.5-air-65k</a></li>
  <li>Cline + GLM 4.6 remoto: <a href="https://github.com/asoldano/onnx-model-generator-docker/tree/cline-glm-4.6-200k">https://github.com/asoldano/onnx-model-generator-docker/tree/cline-glm-4.6-200k</a></li>
  <li>Cline + GPT-OSS 120B locale: <a href="https://github.com/asoldano/onnx-model-generator-docker/tree/cline-lms-gtp-oss-120b-64k">https://github.com/asoldano/onnx-model-generator-docker/tree/cline-lms-gtp-oss-120b-64k</a></li>
</ul>

<p>Per una valutazione imparziale e competente dei risultati, ho poi generato le patch corrispondenti alle modifiche su ognuno dei branch a partire dal branch point e le ho sottomesse a <em>Google Gemini 3</em>.</p>

<p><code class="language-plaintext highlighter-rouge">
Ciao! ho bisogno che tu mi aiuti a valutare la bontà di 5 differenti implementazioni della stessa feature sulla stessa codebase. Il punto di partenza è https://github.com/asoldano/onnx-model-generator-docker , ti allego le 5 patch delle cinque implementazioni alternative, la feature da implementare era rate limiting, ma ti invito a leggere il sorgente del progetto dal main , guardare i file .md e capire cosa è stato scelto di implementare (ho usato tool AI per farlo, il prompt era: "hi , please have a look at the project, incuding the .md files and figure out what the next improvement task to work on would be, then prepare for completing it (including testing and updating the existing .md documents)" . Per favore, analizza le cinque proposte e dimmi come si posizionano come qualità.
</code></p>

<p>Il risultato dell’analisi effettuata per me dall’intelligenza artificiale stessa evidenzia <strong>punti di forza e debolezze</strong> delle patch. Chi fosse curioso può provare ad interrogare Gemini (o magari Claude?) e leggere la risposta; qui invece ritengo sia interessante focalizzarsi sulle <strong>aree di debolezza</strong> individuate (a prescindere da quale configurazione abbia portato ad uno dei comportamenti sub-ottimi), così da <em>capire dove sia il vero valore aggiunto di utilizzare un modello “migliore”</em>:</p>
<ul>
  <li><strong>Hardcoding di parametri</strong> con valori arbitrari</li>
  <li><strong>Stile di testing incoerente</strong> (stampe in standard output, mancanza di assertion / exit code appropriati)</li>
  <li><strong>Caos nella gestione delle dipendenze</strong> (downgrade, aggiunte e rimozioni inappropriate di librerie)</li>
  <li>Scelte di <strong>design non ottimali</strong> (nel nostro caso, un rate limit unico per tutti gli endpoint)</li>
  <li><strong>Race conditions / implementazione non thread-safe</strong></li>
  <li><strong>NIY syndrome</strong> (implementazione custom dove esistono librerie stabili e testate che offrono la stessa funzionalità)</li>
</ul>

<p>Per quanto concerne invece la scelta dell’agente o del <em>modello “migliore”</em>, Gemini ha chiaramente fornito una sua classifica delle 5 soluzioni presentate, ottenuta dando un peso ai vari pro e contro evidenziati; sul podio abbiamo:</p>
<ol>
  <li>Kilo Code + GLM 4.6 remoto</li>
  <li>Cline + GLM 4.6 remoto</li>
  <li>Kilo Code + GLM 4.5-Air remoto</li>
</ol>

<p>In ottica di merge sul main del progetto, probabilmente per mantenere una certa neutralità, Gemini consiglia di derivare una <em>soluzione “perfetta”</em> partendo da quella di Cline + GLM 4.6 remoto e aggiungendo alcune specifiche idee riscontrate unicamente nelle altre soluzioni (incluse le due ottenute con modello locale).</p>

<h2 id="conclusioni">Conclusioni</h2>
<p>Prima di saltare alle conclusioni, alcune considerazioni:</p>
<ul>
  <li>l’esperimento si basa chiaramente su un’osservazione estremamente limitata e va considerata la natura indeterministica / probabilistica dei modelli… quindi non ci sbilanciamo più di tanto ;-)</li>
  <li>ci sono sicuramente margini di miglioramento / tuning a livello della configurazione degli agenti Cline e Kilo Code.</li>
</ul>

<p>Detto questo, dopo le prove qui descritte ecco i punti che ci portiamo a casa:</p>
<ul>
  <li>Il ranking delle soluzioni riportato dal Gemini 3 (probabilmente la più avanzata AI disponibile al momento) rispecchia quello che ci saremmo aspettati considerando le specifiche e i benchmark dei modelli: <strong>GLM 4.6 meglio di GLM 4.5-Air</strong>, <strong>GLM 4.5-Air in remoto via API meglio della versione quantizzata in locale</strong>.</li>
  <li>È possibile portare a termine egregiamente un task di sviluppo come quello qui presentato in tutte le modalità presentate; abbiamo però un’idea della <strong>direzione in cui guardare per apprezzare le differenze di qualità tra soluzioni prodotte con modelli più o meno performanti</strong>; questo ci <em>aiuta anche in generale nell’ottimizzare la review umana di codice generato dall’AI</em>.</li>
</ul>]]></content><author><name>Alessio Soldano</name></author><category term="AI locale" /><category term="LLM" /><category term="Cline" /><category term="Kilo Code" /><category term="aiopenweight" /><category term="Strix Halo" /><category term="generativeai" /><summary type="html"><![CDATA[Proviamo Cline e Kilo Code con modelli locali e remoti (via API) e analizziamo i risultati per comprendere cosa cambia davvero.]]></summary></entry><entry><title type="html">“Consistent character” in locale e con un solo scatto: LoRA, Flux e ComfyUI</title><link href="https://aladinodigitale.it/2025/11/15/consistent-character-lora.html" rel="alternate" type="text/html" title="“Consistent character” in locale e con un solo scatto: LoRA, Flux e ComfyUI" /><published>2025-11-15T00:00:00+00:00</published><updated>2025-11-15T00:00:00+00:00</updated><id>https://aladinodigitale.it/2025/11/15/consistent-character-lora</id><content type="html" xml:base="https://aladinodigitale.it/2025/11/15/consistent-character-lora.html"><![CDATA[<p>Un tema ricorrente in ambito di intelligenza artificiale generativa applicata alle immagini (e video) è quello della creazione di personaggi consistenti, <em>consistent characters</em>, cioè la capacità di un modello AI di rappresentare <strong>lo stesso soggetto</strong> (volto, corporatura, stile, dettagli) in <strong>scatti completamente diversi</strong>, prodotti in momenti, contesti e pose differenti.
È un tema che sta esplodendo: dai video su YouTube, agli influencer virtuali su Instagram, passando per tool online che permettono di farsi il proprio “avatar AI”… e includendo ricerche e progetti molto più seri attorno al tema della verifica identità, deepfake, contenuti generati per social o advertising.</p>

<p>Su Aladino Digitale già si era toccato l’argomento nel post su <strong><a href="https://aladinodigitale.it/ai/immagine/tutorial/2025/07/28/giulia-ai.html">Giulia che esce dalla lampada</a></strong>.
In quel caso l’idea era sostanzialmente un gioco: avevamo generato un’immagine con ChatGPT + Gemini Nano Banana + OpenArt, e poi l’avevamo usata per ottenere qualche close-up e un mini-video. Ma lì si trattava semplicemente di sfruttare le funzionalità di modelli <em>img2img</em> come Flux Context (funzionalità che oggi possiede anche Gemini Nano Banana) esposte da tool quali OpenArt: non c’era un vero “personaggio consistente”. Era una serie di derivazioni della stessa immagine.</p>

<p>Quello che volevo esplorare ora è un passo diverso:
<strong>partire da una singola foto e costruire un modello in grado di generare ogni possibile nuova immagine di quel soggetto</strong>, in qualunque contesto, come se fosse una vera persona fotografata infinite volte.</p>

<p>E per farlo ho scelto di restare in locale, usando la mia macchina con <strong>AMD Strix Halo</strong>, modelli di architettura <strong>Flux</strong>, <a href="https://github.com/comfyanonymous/ComfyUI">ComfyUI</a> e un LoRA addestrato da zero.</p>

<p>Di seguito racconto l’esperimento, eseguito “per davvero”, con tutti i limiti del caso.</p>

<hr />

<h1 id="1-perché-un-personaggio-consistente-è-diventato-così-importante-e-perché-interessa-anche-a-noi">1. Perché un “personaggio consistente” è diventato così importante (e perché interessa anche a noi)</h1>

<p>Il concetto è semplice: se voglio creare un personaggio fittizio (per storytelling, social, mockup di campagne, giochi, fumetti, concept art) un singolo scatto non basta. Voglio <strong>la stessa persona</strong> che:</p>

<ul>
  <li>sorride, è seria, guarda di lato;</li>
  <li>sta in piedi, seduta, di profilo;</li>
  <li>è in cucina, in un bar, in un parco;</li>
  <li>indossa abiti diversi;</li>
  <li>è ripresa con stili e qualità fotografiche differenti.</li>
</ul>

<p>Oggi le AI sfornano volti realistici a migliaia… ma <strong>mantenere coerenza e consistenza</strong> tra generazioni differenti è un’altra storia.
Ecco perché sono nati svariati siti online (incluso lo stesso <a href="https://openart.ai/home">OpenArt</a>) che promettono di generare in modo semplice un consistent character: da poche immagini costruiscono un profilo consistente, sfruttando in qualche forma un fine-tuning leggero del modello (quasi sempre LoRA).</p>

<p>Nel mio caso, volevo capire:</p>

<ul>
  <li>cosa succede <strong>facendolo tutto in locale</strong>, senza mandare foto a servizi terzi;</li>
  <li>cosa cambia rispetto alle soluzioni “one click” online;</li>
  <li>se è possibile partire davvero da <em>una sola immagine</em> e arrivare a un modello funzionante.</li>
</ul>

<p><em>Giulia è diventata la “cavia” perfetta.</em></p>

<hr />

<h1 id="2-lora-flux-e-il-contesto-ai-in-locale-cosa-serve-davvero">2. LoRA, Flux e il contesto “AI in locale”: cosa serve davvero</h1>

<p>Avevo menzionato i LoRA già in passato nel post sulla <a href="https://aladinodigitale.it/2025/10/08/scelta-modelli.html">scelta dei modelli da usare in locale</a>; qui aggiungiamo qualche info aggiuntiva riguardo LoRA e sulle altre scelte fatte:</p>

<h3 id="che-cosè-un-lora">Che cos’è un LoRA?</h3>

<ul>
  <li>È un <em>fine-tuning leggero</em>, cioè una piccola rete aggiuntiva che modifica selettivamente il comportamento del modello base.</li>
  <li>Non si riaddestra tutto da zero (operazione impossibile in locale), ma solo pochissimi parametri aggiuntivi.</li>
  <li>Il risultato è un file (tipicamente in formato <code class="language-plaintext highlighter-rouge">safetensors</code>) molto leggero, in genere pochi megabyte.</li>
</ul>

<p>In pratica un LoRA è come un filtro che dice al modello:</p>

<blockquote>
  <p>“Quando vedi la parola chiave X, usa questo pattern di volto, proporzioni, dettagli”.</p>
</blockquote>

<h3 id="perché-flux">Perché Flux?</h3>

<p>Perché al momento:</p>

<ul>
  <li>è estremamente forte sul realismo (specie nella versione Krea);</li>
  <li>regge molto bene l’identità del soggetto;</li>
  <li>ha modifiche ottimizzate per generazione rapida, queuing, caching, ecc.;</li>
  <li>è molto apprezzato dalla community e supportato da tanti tool</li>
  <li>gira relativamente bene sulla <a href="https://aladinodigitale.it/2025/10/22/local-ai.html#la-mia-esperienza-con-amd-ryzen-ai-max-395-128-gb">soluzione AMD a mia disposizione</a>.</li>
</ul>

<h3 id="perché-in-locale">Perché in locale?</h3>

<p>In linea di principio, l’approccio in locale offre il vantaggio di avere un flusso completamente privato e consente di sperimentare senza troppe preoccupazioni riguardo il costo dei token.
Da un punto di vista più personale, invece, volevo capire i <em>limiti pratici</em> provando un caso d’uso concreto sul mio hardware.</p>

<p>Il resto del post è quindi la cronaca di questo processo: creazione di un opportuno dataset → training del LoRA → test del LoRA e valutazioni finali.</p>

<hr />

<h1 id="3-costruzione-del-dataset-il-vero-collo-di-bottiglia">3. Costruzione del dataset: il vero collo di bottiglia</h1>

<p>È quasi paradossale, ma <strong>produrre un buon dataset</strong> di immagini è complesso (e importante!) quanto <em>addestrare il LoRA</em>.</p>

<p>Io ho deciso di usare e riportare qui due strade:</p>

<h2 id="31--generazione-con-gemini-nano-banana-via-openartai-approccio-online">3.1 – Generazione con Gemini Nano Banana via OpenArt.ai (approccio “online”)</h2>

<p>Partendo dall’immagine di Giulia usata nel vecchio post, ho aperto OpenArt in modalità <em>Chat Edit</em> e ho iniziato a chiedere di:</p>

<ul>
  <li>togliere oggetti;</li>
  <li>cambiare ambienti;</li>
  <li>effettuare zoom su dettagli;</li>
  <li>cambiare posa;</li>
  <li>aggiungere abiti;</li>
  <li>ecc.</li>
</ul>

<p><a href="/assets/images/cc-dataset-lora/cc-dataset-openart1.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-dataset-openart1.jpg" alt="Rimozione oggetti e cambio di ambiente" style="margin-bottom:20px;" />
</a>
<a href="/assets/images/cc-dataset-lora/cc-dataset-openart2.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-dataset-openart2.jpg" alt="Zoom su dettaglio tatuaggi" style="margin-bottom:20px;" />
</a>
<a href="/assets/images/cc-dataset-lora/cc-dataset-openart3.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-dataset-openart3.jpg" alt="Cambio ambiente, posa e abbigliamento - cooking" style="margin-bottom:20px;" />
</a>
<a href="/assets/images/cc-dataset-lora/cc-dataset-openart4.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-dataset-openart4.jpg" alt="Cambio ambiente, posa e abbigliamento - make up" style="margin-bottom:20px;" />
</a>
<a href="/assets/images/cc-dataset-lora/cc-dataset-openart5.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-dataset-openart5.jpg" alt="Cambio ambiente, posa e abbigliamento - car" style="margin-bottom:20px;" />
</a></p>

<p>Il vantaggio di questo approccio è la rapidità di generazione delle immagini, che sono di norma coerenti e senza particolari allucinazioni (grazie alla bontà di Gemini Nano Banana). Il limite vero, a prescindere da ragionamenti su costi, è chiaramente quello di privacy, policy ed eventuale moderazione.</p>

<p>Ho comunque incluso alcune di queste immagini nel dataset finale perché erano molto utili come pose alternative.</p>

<hr />

<h2 id="32--generazione-con-comfyui-approccio-locale-più-complesso-ma-più-controllabile">3.2 – Generazione con ComfyUI (approccio “locale”, più complesso ma più controllabile)</h2>

<p>Qui entra in scena un workflow abbastanza articolato; dopo una breve ricerca in rete, ho deciso di provare quello rilasciato e descritto pubblicamente da <a href="https://mickmumpitz.ai/guides/consistent-character-creator">Mickmumpitz</a> il mese scorso. Il flusso è diviso in due parti; nella prima ComfyUI:</p>

<ul>
  <li>genera viste front / side / back del personaggio (<strong>turnaround sheet</strong>);</li>
  <li>produce close-up coerenti del volto;</li>
  <li>cambia espressioni attraverso controlli fini dei movimenti di bocca, naso, occhi, sopracciglia, etc;</li>
  <li>genera pose diverse attraverso controlli specifici e/o immagini di riferimento;</li>
  <li>cambia l’abbigliamento del soggetto usando capi da immagini di riferimento;</li>
</ul>

<p><a href="/assets/images/cc-dataset-lora/cc-dataset-gen-comfy1.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-dataset-gen-comfy1.jpg" alt="Generazione differenti viste del personaggio a figura intera" style="margin-bottom:20px;" />
</a>
<a href="/assets/images/cc-dataset-lora/cc-dataset-gen-comfy2.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-dataset-gen-comfy2.jpg" alt="Generazione close-up e profilo del viso" style="margin-bottom:20px;" />
</a>
<a href="/assets/images/cc-dataset-lora/cc-dataset-gen-comfy3.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-dataset-gen-comfy3.jpg" alt="Cambio abbigliamento e controllo posa" style="margin-bottom:20px;" />
</a>
<a href="/assets/images/cc-dataset-lora/cc-dataset-gen-comfy4.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-dataset-gen-comfy4.jpg" alt="Generazione espressioni" style="margin-bottom:20px;" />
</a></p>

<p>Nella seconda parte invece si applica upscaling e piccoli miglioramenti assortiti alle immagini precedentemente generate. Vengono inoltre generate le caption con la descrizione delle immagini create.</p>

<p><a href="/assets/images/cc-dataset-lora/cc-dataset-gen-comfy5.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-dataset-gen-comfy5.jpg" alt="Upscaling e creazione del dataset" />
</a></p>

<p>Il risultato è un dataset relativamente strutturato, con viste complementari che aiutano il LoRA a generalizzare.</p>

<h3 id="vantaggi">Vantaggi</h3>

<ul>
  <li>Tutto locale, massima privacy.</li>
  <li>Controllo diretto su qualità e varietà delle immagini (pose, espressioni, luci).</li>
</ul>

<h3 id="limiti">Limiti</h3>

<ul>
  <li>Workflow non banale da capire.</li>
  <li>Richiede tempo e risorse (VRAM); per non impiegare giorni e dovendo fare i conti con alcune instabilità del mio stack (sto sempre aspettando l’uscita del kernel 6.18 di Linux…), nel fare upscaling mi sono limitato ad immagini 1024x1024 pixel di dimensione.</li>
</ul>

<hr />

<p>A dataset completo, avevo circa <strong>25 immagini</strong> ben varie.
Sufficienti per un LoRA di qualità? Forse, da valutare in seguito, di sicuro abbastanza per un primo esperimento attendibile… e soprattutto: <strong>tutto costruito da una sola immagine originale</strong>.</p>

<hr />
<h1 id="4-addestrare-il-lora-con-fluxgym-semplice-ma-con-mille-parametri">4. Addestrare il LoRA con FluxGym: semplice, ma con mille parametri</h1>

<p>Per l’addestramento ho usato <strong><a href="https://github.com/cocktailpeanut/fluxgym">FluxGym</a></strong>, un’interfaccia che permette di:</p>

<ul>
  <li>definire il nome del LoRA;</li>
  <li>scegliere il modello base (Flux dev nel mio caso) e la parola chiave/trigger per attivare il LoRA;</li>
  <li>caricare immagini + caption automatiche;</li>
  <li>impostare epoche, batch size, repeats, LR;</li>
  <li>visualizzare lo script generato per effettuare il training ed eventualmente eseguirlo.</li>
</ul>

<p><a href="/assets/images/cc-dataset-lora/cc-lora-fluxgym1.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-lora-fluxgym1.jpg" alt="FluxGym" />
</a></p>

<h3 id="caricamento-immagini">Caricamento immagini</h3>

<p>Ho selezionato le 25 immagini del dataset descritte in precedenza; i file <code class="language-plaintext highlighter-rouge">.txt</code> generati dal workflow ComfyUI e contenenti le caption vengono caricati automaticamente (purtroppo la qualità e coerenza del testo che descrive le scene è quello che è):</p>

<p><a href="/assets/images/cc-dataset-lora/cc-lora-fluxgym2.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-lora-fluxgym2.jpg" alt="FluxGym: immagini e caption" />
</a></p>

<h3 id="configurazione-usata">Configurazione usata</h3>

<p>FluxGym dispone di diverse decine di parametri di configurazione.
<a href="/assets/images/cc-dataset-lora/cc-lora-fluxgym3.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-lora-fluxgym3.jpg" alt="Parametri configurazione FluxGym" />
</a></p>

<p>Per semplicità, ho scelto di non focalizzarmi sugli aspetti di “ottimizzazione scientifica”: ho modificato soltanto <code class="language-plaintext highlighter-rouge">--optimizer-type</code> per evitare un errore iniziale e la durata del training, poi ho lasciato quasi tutto a default.</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>accelerate launch   <span class="nt">--mixed_precision</span> bf16 <span class="nt">--num_cpu_threads_per_process</span> 1
  sd-scripts/flux_train_network.py
  <span class="nt">--pretrained_model_name_or_path</span> <span class="s2">"/home/alessio/dati/fluxgym/models/unet/flux1-dev.sft"</span>
  <span class="nt">--clip_l</span> <span class="s2">"/home/alessio/dati/fluxgym/models/clip/clip_l.safetensors"</span>
  <span class="nt">--t5xxl</span> <span class="s2">"/home/alessio/dati/fluxgym/models/clip/t5xxl_fp16.safetensors"</span>
  <span class="nt">--ae</span> <span class="s2">"/home/alessio/dati/fluxgym/models/vae/ae.sft"</span>
  <span class="nt">--cache_latents_to_disk</span>
  <span class="nt">--save_model_as</span> safetensors
  <span class="nt">--sdpa</span>
  <span class="nt">--persistent_data_loader_workers</span>
  <span class="nt">--max_data_loader_n_workers</span> 2
  <span class="nt">--seed</span> 42
  <span class="nt">--gradient_checkpointing</span>
  <span class="nt">--mixed_precision</span> bf16
  <span class="nt">--save_precision</span> bf16
  <span class="nt">--network_module</span> networks.lora_flux
  <span class="nt">--network_dim</span> 4
  <span class="nt">--optimizer_type</span> adamw
  <span class="nt">--sample_prompts</span><span class="o">=</span><span class="s2">"/home/alessio/dati/fluxgym/outputs/giulia1/sample_prompts.txt"</span>
  <span class="nt">--sample_every_n_steps</span><span class="o">=</span><span class="s2">"100"</span>
  <span class="nt">--learning_rate</span> 3e-4
  <span class="nt">--cache_text_encoder_outputs</span>
  <span class="nt">--cache_text_encoder_outputs_to_disk</span>
  <span class="nt">--fp8_base</span>
  <span class="nt">--highvram</span>
  <span class="nt">--max_train_epochs</span> 16
  <span class="nt">--save_every_n_epochs</span> 4
  <span class="nt">--dataset_config</span> <span class="s2">"/home/alessio/dati/fluxgym/outputs/giulia1/dataset.toml"</span>
  <span class="nt">--output_dir</span> <span class="s2">"/home/alessio/dati/fluxgym/outputs/giulia1"</span>
  <span class="nt">--output_name</span> giulia1
  <span class="nt">--timestep_sampling</span> <span class="nb">shift</span>
  <span class="nt">--discrete_flow_shift</span> 3.1582
  <span class="nt">--model_prediction_type</span> raw
  <span class="nt">--guidance_scale</span> 1
  <span class="nt">--loss_type</span> l2
  <span class="nt">--mem_eff_attn</span>
</code></pre></div></div>

<p>E’ possibile fornire uno o più <strong>sample prompt</strong> da utilizzare a varie epoche per generare immagini con il LoRA corrente, così da valutare i progressi dell’addestramento (ed eventualmente fermarsi ante tempo, previa configurazione di FluxGym per salvare snapshot del LoRA agli stessi step in cui si valutano i sample prompt). In generale, qui il consiglio è di fornire prompt sufficientemente generici da lasciare spazio al modello di “esprimersi” e vedere se e quanto il LoRA sta facendo effetto. Inoltre è bene formulare prompt che descrivano scene che normalmente portino a rappresentare gli elementi che si presume essere distintivi del soggetto per i quale si crea il LoRA (ad esempio ripresa frontale del soggetto , utile per valutare il viso).</p>

<p>Dopo diverse ore di computazione, utilizzando oltre 20 GB di memoria video (ma esiste configurazione per eseguire con soli 12GB di VRAM), FluxGym mi produce:</p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">giulia1.safetensors</code> → il LoRA finale</li>
  <li>vari snapshot intermedi</li>
  <li>immagini sample</li>
  <li>caption associate</li>
</ul>

<p><a href="/assets/images/cc-dataset-lora/cc-lora-fluxgym4.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-lora-fluxgym4.jpg" alt="FluxGym: inizio addestramento" style="margin-bottom:20px;" />
</a>
<a href="/assets/images/cc-dataset-lora/cc-lora-fluxgym5.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-lora-fluxgym5.jpg" alt="FluxGym: fine addestramento" style="margin-bottom:20px;" />
</a></p>

<p>Non immediato di sicuro, ma perfettamente gestibile sul mio hardware.</p>

<hr />

<h1 id="5-risultati-il-lora-funziona-davvero-sì-ma-con-alcune-sorprese">5. Risultati: il LoRA funziona davvero? Sì (ma con alcune sorprese)</h1>

<p>Il LoRA ottenuto è utilizzabile con qualunque modello della serie Flux. Torno dunque in ComfyUI, carico un workflow Flux standard, ma decido di utilizzare <em>Flux1 Krea Dev</em> per un maggiore fotorealismo delle immagini generate; per caricare il LoRA, uso un apposito <code class="language-plaintext highlighter-rouge">LoraLoaderModelOnly</code> e seleziono il file <code class="language-plaintext highlighter-rouge">.safetensor</code> finale generato da FluxGym.</p>

<p><a href="/assets/images/cc-dataset-lora/cc-lora-comfy1.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-lora-comfy1.jpg" alt="ComfyUI: setup LoRA" />
</a></p>

<p>Per attivare il LoRA in fase di generazione, aggiungo nel prompt la parola chiave <code class="language-plaintext highlighter-rouge">Giulia1</code> e gioco con i contesti.
Per cominciare un semplice prompt del tipo <code class="language-plaintext highlighter-rouge">A 4k photorealistic full body shot of Giulia1, sitting on a bench in a city park</code>, in 20 step e con il resto delle impostazioni visibili nell’immagine qui sotto, produce un’immagine a tutti gli effetti coerente con quella di partenza: Giulia è rappresentata nell’immagine unicamente grazie al riferimento del nome nel prompt, senza bisogno di specificarne le caratteristiche fisiche / estetiche.</p>

<p><a href="/assets/images/cc-dataset-lora/cc-lora-comfy2.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-lora-comfy2.jpg" alt="ComfyUI: prima immagine di Giulia al parco" />
</a></p>

<p>Decido dunque di arricchire un pochino la descrizione nel prompt, specificando l’abbigliamento richiesto per il soggetto (si noti come non si tratti di un outfit presente nel dataset di training) e un’azione in corso (lavoro al computer portatile): il risultato è ancora più che buono in termini di coerenza, proporzioni, credibilità dell’espressione e aderenza al prompt.</p>

<p><a href="/assets/images/cc-dataset-lora/cc-lora-comfy3.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-lora-comfy3.jpg" alt="ComfyUI: Giulia lavora al computer" />
</a></p>

<p>Noto tuttavia che i tatuaggi alle gambe sembrano scomparsi (avevo esplicitamente fornito un’immagine ravvicinata nel dataset di training, per valutare le capacità di imparare dettagli complessi). Provo dunque a “dare una mano” al modello, esplicitando nel prompt la presenza dei tatuaggi alle gambe.</p>

<blockquote>
  <p>💡 <em>Suggerimento prompt:</em> talvolta parte del prompt non viene recepito correttamente. Nell’esempio qui sopra, Giulia lavora effettivamente al portatile, etc. ma a voler essere pignoli l’immagine generata non è veramente <code class="language-plaintext highlighter-rouge">a full body shot</code>. Un modo elegante per forzare il modello a rispettare la richiesta è quello di aggiungere del dettaglio informativo nel prompt - e dunque nel contesto - riguardo la parte dell’immagine che sta venendo ignorata, in questo caso i piedi del soggetto. Aggiungo quindi informazioni sul tipo di scarpe da generare.</p>
</blockquote>

<p><a href="/assets/images/cc-dataset-lora/cc-lora-comfy4.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-lora-comfy4.jpg" alt="ComfyUI: Giulia e i suoi tatuaggi" />
</a></p>

<p>Con il prompt rivisto otteniamo i tatuaggi richiesti. Il LoRA sembra avere effettivamente imparato qualcosa riguardo i tatuaggi di Giulia, le posizioni sulle gambe sono corrette, il colore è giusto, lo stile / pattern tuttavia è simile ma non identico (indice della necessità di migliori e più numerose immagini necessarie nel dataset e probabilmente di una fase di training più estesa e meglio configurata). Inoltre, l’immagine generata presenta tatuaggi non richiesti anche sulle braccia.</p>

<p>Per concludere provo ad utilizzare un prompt molto verboso reperito su una galleria online di immagini AI; la scena descritta è relativamente complessa e ricca di dettagli, ciononostante il risultato è sempre più che buono.</p>

<p><a href="/assets/images/cc-dataset-lora/cc-lora-comfy5.jpg" target="_blank">
  <img src="/assets/images/cc-dataset-lora/cc-lora-comfy5.jpg" alt="ComfyUI: Giulia e a un caffè francese" />
</a></p>

<blockquote>
  <p>💡 <em>Suggerimento adattamento prompt con LoRA:</em> quando si riutilizza un prompt creato in precedenza, aggiungendo un LoRA e attivandolo con opportuna parola chiave, è opportuno verificare che il prompt non contenga informazioni palesemente in contrasto con gli elementi salienti / distintivi del “soggetto codificato” nel LoRA. Se il soggetto ha capelli corti, per dire, un prompt che descrive i capelli che cadono lungo la schiena del soggetto, porta facilmente ad una generazione che non rappresenta correttamente il soggetto del LoRA o che non rispetta le richieste del prompt.</p>
</blockquote>

<hr />

<h1 id="conclusioni-cosa-ho-imparato-e-perché-questo-esperimento-conta">Conclusioni: cosa ho imparato (e perché questo esperimento conta)</h1>

<p>Questo esperimento non è un tutorial “perfetto”.
Non ho:</p>

<ul>
  <li>selezionato un dataset ottimale;</li>
  <li>sistemato le caption (spesso inaccurate);</li>
  <li>fatto upscaling serio di tutte le immagini;</li>
  <li>bilanciato LR, repeats, rank del LoRA;</li>
  <li>iterato su 3–4 training per confrontare risultati.</li>
</ul>

<p>Eppure, con:</p>

<ul>
  <li>una sola immagine iniziale,</li>
  <li>~25 immagini derivate,</li>
  <li>un training leggero in locale,</li>
  <li>un modello Flux in locale,</li>
</ul>

<p>sono riuscito a <strong>creare un personaggio consistente</strong>, da zero, completamente offline, e senza censure.</p>

<p>È una cosa incredibile sia in positivo (creatività, prototipazione, storytelling, produzione veloce di contenuti), sia in negativo:</p>

<blockquote>
  <p>il sistema funziona anche con foto vere di persone reali.</p>
</blockquote>

<p>E questo costringe ognuno di noi a rivalutare l’autenticità di praticamente qualunque contenuto visuale trovato online.</p>

<p>Non escludo un domani di approfondire la configurazione dell’addestramento LoRA, per ora tuttavia mi fermo qui: un flusso, realmente provato, che partendo da un singolo scatto permette di generare qualunque scena con un personaggio inventato — ma coerente.</p>]]></content><author><name>Alessio Soldano</name></author><category term="AI locale" /><category term="LoRA" /><category term="Flux" /><category term="ComfyUI" /><category term="training" /><category term="Strix Halo" /><category term="consistent character" /><summary type="html"><![CDATA[Un esperimento pratico di creazione di un dataset di immagini e addestramento di un LoRA, in locale su AMD Strix Halo.]]></summary></entry><entry><title type="html">Coding agent in locale: esperimenti con Claude Code Router e LM Studio</title><link href="https://aladinodigitale.it/2025/11/02/coding-agent-locale.html" rel="alternate" type="text/html" title="Coding agent in locale: esperimenti con Claude Code Router e LM Studio" /><published>2025-11-02T00:00:00+00:00</published><updated>2025-11-02T00:00:00+00:00</updated><id>https://aladinodigitale.it/2025/11/02/coding-agent-locale</id><content type="html" xml:base="https://aladinodigitale.it/2025/11/02/coding-agent-locale.html"><![CDATA[<p>Durante la settimana appena conclusa ho cercato di capire fin dove si possa spingere l’idea di un <em>coding agent</em> — ma non nel cloud, bensì <strong>in locale</strong>, usando modelli openweight e il mio hardware.
Nel mio caso, si tratta di un <strong>AMD Ryzen AI Max+ 395 (Strix Halo)</strong> con <strong>128 GB di RAM condivisa</strong>: un sistema che sulla carta può gestire modelli anche piuttosto grandi, ma che nella pratica obbliga a ragionare su dettagli che, in cloud, di solito restano invisibili.</p>

<p>L’obiettivo era provare a replicare — almeno in parte — l’esperienza di <strong><a href="https://www.claude.com/product/claude-code">Claude Code</a></strong>, l’ambiente di <em>Anthropic</em> per lo sviluppo assistito da AI, ma eseguendo <strong>tutto localmente</strong>.</p>

<p>Per farlo mi sono servito di due componenti principali:</p>

<ul>
  <li><strong><a href="https://github.com/musistudio/claude-code-router">Claude Code Router</a></strong></li>
  <li><strong><a href="https://lmstudio.ai">LM Studio</a></strong></li>
</ul>

<p>Come usecase di test, ho scelto di “proseguire lo sviluppo” del piccolo progetto opensource (<a href="https://github.com/asoldano/onnx-model-generator-docker">onnx-model-generator-docker</a>) che già avevo usato un mese fa proprio per <a href="https://aladinodigitale.it/2025/10/01/claude-code-case-study.html">dimostrare le potenzialità di Claude Code</a>.</p>

<hr />

<h2 id="come-funziona-un-coding-agent">Come funziona un coding agent</h2>

<p>Prima di entrare nei dettagli, vale la pena ricordare cosa fa a grandi linee internamente un “coding agent”.
A differenza di una chat tradizionale, un agente non risponde solo a un prompt, ma <strong>gestisce un ciclo di lavoro</strong>:
pianifica un’azione (“implementa la feature X”, “risolvi in bug Y”), analizza il codice esistente, modifica file, richiama tool, legge risultati dei test e decide cosa fare dopo.</p>

<p>Ogni passo di questo processo genera <strong>una o più richieste verso un modello linguistico</strong>, che deve ragionare a partire da un contesto aggiornato.
Il modello, tuttavia, è <strong>stateless</strong>: non conserva memoria delle conversazioni e delle chiamate che le compongono.
Questo significa che <em>ogni volta</em> bisogna ridargli tutto ciò che serve — parte del codice, descrizioni, risultati intermedi — entro i limiti della <strong>finestra di contesto</strong>.</p>

<p>È proprio per questo che i coding agent necessitano di modelli con <strong>contesti ampi (es. 64 k token o più)</strong>: devono mantenere visibili porzioni significative di codice e output, altrimenti perdono “il filo” tra una richiesta e l’altra.</p>

<hr />

<h2 id="claude-code-router-il-cuore-dellesperimento">Claude Code Router: il cuore dell’esperimento</h2>

<p>Il <em>Claude Code Router</em> è un progetto open source pensato per reindirizzare le chiamate di Claude Code verso differenti modelli.
Non è un editor o un’interfaccia grafica: è un <strong>proxy intelligente</strong> che si interpone tra il client (CLI di Anthropic) e uno o più modelli configurati come backend.</p>

<p>Il router riceve le chiamate del client (ad esempio “pensa al prossimo passo”, “leggi questo file”, “genera test”), le instrada al modello corretto in base al tipo di richiesta (<code class="language-plaintext highlighter-rouge">think</code>, <code class="language-plaintext highlighter-rouge">longContext</code>, <code class="language-plaintext highlighter-rouge">default</code>, <code class="language-plaintext highlighter-rouge">background</code>), e restituisce la risposta nel formato previsto.</p>

<p>Ogni ruolo può usare un <strong>modello diverso</strong>, o la stessa istanza con parametri differenti — ad esempio uno piccolo per richieste rapide e uno grande per reasoning più complesso.
Nel mio caso, l’ho usato inizialmente con una sola istanza locale di <strong>LM Studio</strong>, poi in seguito con due (ma ci arrivo dopo).</p>

<hr />

<h2 id="lm-studio-il-backend-locale">LM Studio: il backend locale</h2>

<p><em>LM Studio</em> è un’applicazione che consente di scaricare ed eseguire modelli LLM openweight su GPU o CPU locali, esponendoli tramite un’API compatibile con OpenAI.
Per il router è del tutto trasparente: crede di parlare con un endpoint remoto (come quello di Anthropic), ma in realtà l’inferenza avviene interamente sul mio sistema.</p>

<p>Ho scelto come modello di partenza <strong><a href="https://huggingface.co/openai/gpt-oss-20b">gpt-oss-20b</a></strong>, che rappresenta un buon compromesso fra capacità e requisiti di memoria.
Le impostazioni iniziali in LM Studio erano:</p>

<ul>
  <li><strong>Contesto massimo:</strong> 64 k token</li>
  <li><strong>Flash Attention:</strong> abilitata</li>
  <li><strong>Layer in GPU:</strong> tutti</li>
</ul>

<hr />

<h2 id="1-prima-configurazione-un-solo-modello-per-tutto">1. Prima configurazione: un solo modello per tutto</h2>

<p>In questa prima prova, tutte le richieste del router (<code class="language-plaintext highlighter-rouge">default</code>, <code class="language-plaintext highlighter-rouge">think</code>, <code class="language-plaintext highlighter-rouge">background</code>, <code class="language-plaintext highlighter-rouge">longContext</code>) puntavano alla stessa istanza LM Studio con <code class="language-plaintext highlighter-rouge">gpt-oss-20b</code>.</p>

<div class="language-json highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">{</span><span class="w">
  </span><span class="err">...</span><span class="w">
  </span><span class="nl">"Providers"</span><span class="p">:</span><span class="w"> </span><span class="p">[</span><span class="w">
    </span><span class="p">{</span><span class="w">
      </span><span class="nl">"name"</span><span class="p">:</span><span class="w"> </span><span class="s2">"strix-halo"</span><span class="p">,</span><span class="w">
      </span><span class="nl">"api_base_url"</span><span class="p">:</span><span class="w"> </span><span class="s2">"http://localhost:1234/v1/chat/completions"</span><span class="p">,</span><span class="w">
      </span><span class="nl">"api_key"</span><span class="p">:</span><span class="w"> </span><span class="s2">"test"</span><span class="p">,</span><span class="w">
      </span><span class="nl">"models"</span><span class="p">:</span><span class="w"> </span><span class="p">[</span><span class="w">
        </span><span class="s2">"openai/gpt-oss-20b"</span><span class="w">
      </span><span class="p">]</span><span class="w">
    </span><span class="p">}</span><span class="w">
  </span><span class="p">],</span><span class="w">

  </span><span class="nl">"Router"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w">
    </span><span class="nl">"default"</span><span class="p">:</span><span class="w"> </span><span class="s2">"strix-halo,openai/gpt-oss-20b"</span><span class="p">,</span><span class="w">
    </span><span class="nl">"background"</span><span class="p">:</span><span class="w"> </span><span class="s2">"strix-halo,openai/gpt-oss-20b"</span><span class="p">,</span><span class="w">
    </span><span class="nl">"think"</span><span class="p">:</span><span class="w"> </span><span class="s2">"strix-halo,openai/gpt-oss-20b"</span><span class="p">,</span><span class="w">
    </span><span class="nl">"longContext"</span><span class="p">:</span><span class="w"> </span><span class="s2">"strix-halo,openai/gpt-oss-20b"</span><span class="p">,</span><span class="w">
    </span><span class="nl">"longContextThreshold"</span><span class="p">:</span><span class="w"> </span><span class="mi">60000</span><span class="p">,</span><span class="w">
    </span><span class="nl">"webSearch"</span><span class="p">:</span><span class="w"> </span><span class="s2">"strix-halo,openai/gpt-oss-20b"</span><span class="p">,</span><span class="w">
    </span><span class="nl">"image"</span><span class="p">:</span><span class="w"> </span><span class="s2">"strix-halo,openai/gpt-oss-20b"</span><span class="w">
  </span><span class="p">}</span><span class="w">
  </span><span class="err">...</span><span class="w">
</span><span class="p">}</span><span class="w">
</span></code></pre></div></div>

<p>Nelle prime prove non avevo impostato limiti particolari per la risposta (<code class="language-plaintext highlighter-rouge">max_tokens</code>), lasciando al router il default.
Solo più avanti, con la configurazione multi-modello, il parametro <code class="language-plaintext highlighter-rouge">max_tokens</code> diventerà importante — ma non tanto per controllare la lunghezza dell’output, quanto per <strong>come interagisce con la KV cache</strong>, e quindi con la memoria effettiva utilizzata (ci torno tra poco).</p>

<h3 id="perché-64-k-token">Perché 64 k token</h3>

<p>Come accennato prima, un coding agent è <em>stateless</em>, quindi a ogni passo deve ricevere di nuovo tutto ciò che serve per ragionare: parte del codice del progetto, i file generati in precedenza, e le istruzioni aggiornate.
Un contesto da <strong>64 k token</strong> permette di contenere già una porzione significativa del codice e di mantenere coerenti le conversazioni multi-step.
Al di sotto dei 32 k, il modello “perde pezzi” del ragionamento, perché il contesto non basta a mantenere tutto il necessario.</p>

<p>In termini pratici, 64 k token equivalgono a circa 50 KB di testo grezzo (più metadati) e comportano un <strong>overhead di memoria di circa 3 GB</strong> solo per la gestione della cache associata a quel contesto.</p>

<h3 id="layer-in-gpu-e-flash-attention">Layer in GPU e Flash Attention</h3>

<p>Grazie all’abbondante memoria unificata del Ryzen AI Max+, posso abilitare <em>tutti i layer in GPU</em> ed eseguire l’intera pipeline del modello (i layer del transformer) direttamente sulla GPU, ottimizzando la velocità dell’inferenza e riducendo la latenza. Su un’architettura con scheda video dedicata, questo implicherebbe utilizzo della (spesso poca) memoria video VRAM, che diventa dunque l’elemento vincolante per capire quanti layer possono andare in GPU.</p>

<p>La <strong>Flash Attention</strong>, invece, è un’ottimizzazione della computazione delle matrici di attenzione: riduce la duplicazione di dati in memoria e accelera le moltiplicazioni tra <code class="language-plaintext highlighter-rouge">Q</code>, <code class="language-plaintext highlighter-rouge">K</code> e <code class="language-plaintext highlighter-rouge">V</code>.</p>

<figure class=""><img src="/assets/images/coding-agent-locale/coding-agent-locale-gpt-oss-20b-setup.png" alt="gpt-oss-20b setup" /><figcaption>
      Configurazione di LM Studio per avviare un server che esegua inferenza usando gpt-oss 20B.

    </figcaption></figure>

<hr />

<h3 id="prime-osservazioni">Prime osservazioni</h3>

<p>Con questa configurazione base, l’agente funzionava ma in modo piuttosto lento.
Il tempo complessivo per ogni richiesta era dominato non tanto dalla velocità di generazione (token / s), quanto dal tempo di elaborazione del prompt iniziale.
Osservando i log di LM Studio, notavo che per diverse richieste inviate dal router il modello doveva ricostruire da zero tutto il contesto — e questo è esattamente il punto in cui mi sono dovuto fermare a documentarmi / studiare il funzionamento della <strong>KV cache</strong>.</p>

<hr />

<h2 id="2-la-questione-della-kv-cache">2. La questione della KV cache</h2>

<p>Come detto la lentezza osservata non dipendeva tanto dal throughput di generazione, quanto da un fattore più nascosto: la <strong>KV cache</strong>.</p>

<p>In un modello transformer, ogni layer elabora una sequenza di token tramite il meccanismo di <strong>self-attention</strong>, che si basa su tre matrici di valori numerici:</p>

<ul>
  <li><strong>Q</strong> (<em>Query</em>),</li>
  <li><strong>K</strong> (<em>Key</em>),</li>
  <li><strong>V</strong> (<em>Value</em>).</li>
</ul>

<p>Quando il modello genera un token, confronta il vettore <code class="language-plaintext highlighter-rouge">Q</code> di quel token con tutti i vettori <code class="language-plaintext highlighter-rouge">K</code> e <code class="language-plaintext highlighter-rouge">V</code> dei token precedenti per capire su quali “prestare attenzione”.
In altre parole, le matrici <strong>Key</strong> e <strong>Value</strong> rappresentano la memoria a breve termine del modello:
ogni token passato aggiunge una coppia (<code class="language-plaintext highlighter-rouge">K</code>, <code class="language-plaintext highlighter-rouge">V</code>) per ciascun layer.</p>

<p>Ricalcolare tutte queste coppie a ogni passo è computazionalmente molto pesante e per evitarlo, i motori di inferenza mantengono in memoria una <strong>cache KV</strong>, cioè una struttura che conserva i vettori <code class="language-plaintext highlighter-rouge">K</code> e <code class="language-plaintext highlighter-rouge">V</code> dei token già elaborati.
Quando arriva un nuovo token, il modello valuta se può riusare direttamente questi dati senza ricomputarli da zero.</p>

<p>Chiaramente mantenere la cache richiede molta memoria, ma il risparmio di tempo ogni qual volta è possibile riusare dati dalla cache è immenso.</p>

<p>Per massimizzare l’utilizzo della cache, si utilizzano <em>KV cache manager</em> che utilizzano varie tecniche per identificare prompt con una parte di contesto identica o fortemente sovrapposta a quello di richieste precedenti, così da poter riutilizzare le informazioni contenute nella cache.</p>

<p>LM Studio si basa internalmente sulla libreria llama.cpp che mi risulta disporre di un meccanismo di KV cache, anche se non particolarmente avanzato. Sequenze di prompt profondamente differenti o semplicemente di lunghezza molto differente, invalidano facilmente la cache, portando a ricalcoli per ricostruire la rappresentazione interna del contesto, rieseguendo l’attenzione per tutti i token dei prompt.
Su 64 k token di input, parliamo di diverse decine di secondi di lavoro aggiuntivo sul mio hardware.</p>

<p>Nel mio caso di test si verificava esattamente questo fenomeno, presumibilmente in relazione alla sequenza con cui i vari tipi differenti di prompt vengono generati ed inviati dal coding agent.
Non ho fatto vera e propria analisi del traffico HTTP tra agente e modello, ma è abbastanza evidente che il router inoltra richieste tutt’altro che omogenee: ci sono chiamate che coinvolgono interi file, ragionamenti multi-step, sintesi di piani d’azione — e altre molto più brevi, che servono solo per gestire il flusso, interrogare lo stato, o verificare la disponibilità di tool.
Sono proprio queste micro-richieste, alternate alle operazioni lunghe, che più frequentemente portano all’invalidazione della cache.</p>

<p>Questo spiega perché il tempo percepito “prima del primo token” è così alto.</p>

<hr />

<h2 id="3-seconda-configurazione-due-istanze-del-modello">3. Seconda configurazione: due istanze del modello</h2>

<p>Dopo aver capito che la lentezza non dipendeva solo dal throughput, ma anche dal modo in cui la cache KV veniva continuamente invalidata, la direzione successiva era quasi obbligata: <strong>separare le richieste “piccole” da quelle “grandi”</strong>.</p>

<p>Decido quindi di ispirarmi all’architettura di Claude Code originale così come recepita nella configurazione del router: usare <strong>più modelli (o istanze dello stesso modello)</strong>, ciascuno dedicato a un tipo di richiesta diverso.</p>

<hr />

<h3 id="configurazione-a-due-istanze">Configurazione a due istanze</h3>

<p>Nel mio caso, ho mantenuto <code class="language-plaintext highlighter-rouge">gpt-oss-20b</code> ma l’ho avviato due volte in LM Studio, con due profili distinti e due dimensioni massime di contesto differenti, rispettivamente 16 k e 64 k.
Nel router la configurazione diventava:</p>

<div class="language-json highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">{</span><span class="w">
   </span><span class="err">...</span><span class="w">
  </span><span class="nl">"Providers"</span><span class="p">:</span><span class="w"> </span><span class="p">[</span><span class="w">
    </span><span class="p">{</span><span class="w">
      </span><span class="nl">"name"</span><span class="p">:</span><span class="w"> </span><span class="s2">"lmstudio-small"</span><span class="p">,</span><span class="w">
      </span><span class="nl">"models"</span><span class="p">:</span><span class="w"> </span><span class="p">[</span><span class="s2">"openai/gpt-oss-20b:2"</span><span class="p">],</span><span class="w">
      </span><span class="nl">"default_params"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w"> </span><span class="nl">"max_tokens"</span><span class="p">:</span><span class="w"> </span><span class="mi">1024</span><span class="w"> </span><span class="p">}</span><span class="w">
    </span><span class="p">},</span><span class="w">
    </span><span class="p">{</span><span class="w">
      </span><span class="nl">"name"</span><span class="p">:</span><span class="w"> </span><span class="s2">"lmstudio-long"</span><span class="p">,</span><span class="w">
      </span><span class="nl">"models"</span><span class="p">:</span><span class="w"> </span><span class="p">[</span><span class="s2">"openai/gpt-oss-20b"</span><span class="p">],</span><span class="w">
      </span><span class="nl">"default_params"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w"> </span><span class="nl">"max_tokens"</span><span class="p">:</span><span class="w"> </span><span class="mi">32000</span><span class="w"> </span><span class="p">}</span><span class="w">
    </span><span class="p">}</span><span class="w">
  </span><span class="p">]</span><span class="w">
  
  </span><span class="nl">"Router"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w">
    </span><span class="nl">"default"</span><span class="p">:</span><span class="w"> </span><span class="s2">"lmstudio-small,openai/gpt-oss-20b:2"</span><span class="p">,</span><span class="w">
    </span><span class="nl">"background"</span><span class="p">:</span><span class="w"> </span><span class="s2">"lmstudio-small,openai/gpt-oss-20b:2"</span><span class="p">,</span><span class="w">
    </span><span class="nl">"think"</span><span class="p">:</span><span class="w"> </span><span class="s2">"lmstudio-long,openai/gpt-oss-20b"</span><span class="p">,</span><span class="w">
    </span><span class="nl">"longContext"</span><span class="p">:</span><span class="w"> </span><span class="s2">"lmstudio-long,openai/gpt-oss-20b"</span><span class="p">,</span><span class="w">
    </span><span class="nl">"longContextThreshold"</span><span class="p">:</span><span class="w"> </span><span class="mi">3000</span><span class="p">,</span><span class="w">
    </span><span class="nl">"webSearch"</span><span class="p">:</span><span class="w"> </span><span class="s2">"lmstudio-small,openai/gpt-oss-20b:2"</span><span class="p">,</span><span class="w">
    </span><span class="nl">"image"</span><span class="p">:</span><span class="w"> </span><span class="s2">"lmstudio-small,openai/gpt-oss-20b:2"</span><span class="w">
  </span><span class="p">}</span><span class="w">
  </span><span class="err">...</span><span class="w">
</span><span class="p">}</span><span class="w">
</span></code></pre></div></div>

<p>Il router ora aveva due percorsi distinti:</p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">lmstudio-small</code> gestiva le richieste veloci e di servizio (quelle che prima invalidavano più spesso la cache).</li>
  <li><code class="language-plaintext highlighter-rouge">lmstudio-long</code> era riservato alle operazioni di reasoning esteso e alle generazioni di codice complesse.</li>
</ul>

<hr />

<h3 id="perché-max_tokens-diversi">Perché <code class="language-plaintext highlighter-rouge">max_tokens</code> diversi</h3>

<p>Il parametro <code class="language-plaintext highlighter-rouge">max_tokens</code> definisce quanti token <strong>la risposta del modello</strong> può generare in un’unica inferenza.
Ma questo valore incide direttamente anche su <strong>quanto spazio di cache viene riservato</strong> durante l’elaborazione:
il motore deve infatti allocare la memoria necessaria non solo per il contesto in ingresso, ma anche per i token in uscita <em>potenziali</em>.</p>

<p>Un limite alto (come 32 k token) amplia la finestra di generazione ma aumenta la memoria preallocata per la KV cache; un limite basso (come 1024) riduce l’impatto sulla memoria e accelera la latenza di avvio, soprattutto se le richieste sono brevi.</p>

<p>In altre parole:</p>

<ul>
  <li><strong>lmstudio-small</strong> poteva permettersi di rispondere in modo rapido perché manteneva una cache ridotta, perfetta per prompt leggeri e brevi risposte.</li>
  <li><strong>lmstudio-long</strong>, invece, era configurato per reasoning lunghi e poteva lavorare su contesti estesi, ma a costo di tempi di inizializzazione più alti e maggiore uso di memoria.</li>
</ul>

<hr />

<h3 id="risultati-empirici">Risultati empirici</h3>

<p>Con questa configurazione la differenza si è vista subito.
Le operazioni leggere — ad esempio richieste di stato o piccole elaborazioni — diventavano quasi istantanee (2-3 secondi), mentre le sessioni reasoning lunghe restavano lente ma più prevedibili, e soprattutto nella maggior parte dei casi <strong>non influenzavano più le richieste successive</strong> (nel senso che non portavano ad invalidazione della cache).</p>

<p>L’agente, però, non riusciva ancora a completare correttamente il primo task del progetto — l’implementazione del <em>rate limiting</em> nel servizio — ma almeno ora il comportamento era più coerente e ripetibile, segno che la struttura di base era solida.</p>

<figure class=""><img src="/assets/images/coding-agent-locale/coding-agent-locale-model-lying.png" alt="Model fails to update documentation" /><figcaption>
      Il modello fatica a completare il task correttamente, sostenendo di aver aggiornato la documentazione quando in realtà non ci è riuscito.

    </figcaption></figure>

<hr />

<h2 id="4-esperimenti-con-qwen-3">4. Esperimenti con Qwen 3</h2>

<p>Ho provato a sostituire il modello con <strong>Qwen 3</strong>.
Il primo tentativo con <code class="language-plaintext highlighter-rouge">Qwen3-Coder-30B-AB3-Instruct</code> non ha funzionato come speravo: ottimo sul codice, ma senza capacità reasoning sufficiente per la fase <em>think</em>.
Sono quindi passato a <a href="https://huggingface.co/Qwen/Qwen3-30B-A3B-Instruct-2507"><code class="language-plaintext highlighter-rouge">Qwen3-30B-A3B-Instruct-2507</code></a>, che migliora il precedente in particolare aggiungengo le capacità di reasoning.</p>

<p>La configurazione era la stessa: due istanze LM Studio, stesso schema di router.
Le risposte migliorano, ma il ciclo completo (feature → test → doc) ancora non si chiudeva correttamente.</p>

<figure class=""><img src="/assets/images/coding-agent-locale/coding-agent-locale-qwen-circle.png" alt="Model loop" /><figcaption>
      Il modello va in loop cercando invano di modificare i sorgenti

    </figcaption></figure>

<figure class=""><img src="/assets/images/coding-agent-locale/coding-agent-locale-qwen-config-ctx-full.png" alt="Model ctx full" /><figcaption>
      … di conseguenza, il contesto si riempie, causando ulteriori problemi.

    </figcaption></figure>

<hr />

<h2 id="5-la-soluzione-finale-gpt-oss-120b">5. La soluzione finale: GPT-OSS-120B</h2>

<p>A quel punto ho deciso di passare al livello successivo: <strong><a href="https://huggingface.co/openai/gpt-oss-120b">GPT-OSS-120B</a></strong>, caricato in LM Studio sempre con Flash Attention attiva, tutti i layer in GPU e contesto massimo fissato a 64k.
L’ho assegnato ai ruoli <code class="language-plaintext highlighter-rouge">think</code> e <code class="language-plaintext highlighter-rouge">longContext</code> nella configurazione del router, mantenendo <code class="language-plaintext highlighter-rouge">gpt-oss-20b</code> per le richieste leggere e di background.</p>

<div class="language-json highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">{</span><span class="w">
  </span><span class="err">...</span><span class="w">
  </span><span class="nl">"Providers"</span><span class="p">:</span><span class="w"> </span><span class="p">[</span><span class="w">
    </span><span class="p">{</span><span class="w">
      </span><span class="nl">"name"</span><span class="p">:</span><span class="w"> </span><span class="s2">"lmstudio-small"</span><span class="p">,</span><span class="w">
      </span><span class="nl">"models"</span><span class="p">:</span><span class="w"> </span><span class="p">[</span><span class="s2">"openai/gpt-oss-20b"</span><span class="p">],</span><span class="w">
      </span><span class="nl">"default_params"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w"> </span><span class="nl">"max_tokens"</span><span class="p">:</span><span class="w"> </span><span class="mi">1024</span><span class="w"> </span><span class="p">}</span><span class="w">
    </span><span class="p">},</span><span class="w">
    </span><span class="p">{</span><span class="w">
      </span><span class="nl">"name"</span><span class="p">:</span><span class="w"> </span><span class="s2">"lmstudio-long"</span><span class="p">,</span><span class="w">
      </span><span class="nl">"models"</span><span class="p">:</span><span class="w"> </span><span class="p">[</span><span class="s2">"openai/gpt-oss-120b"</span><span class="p">],</span><span class="w">
      </span><span class="nl">"default_params"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w"> </span><span class="nl">"max_tokens"</span><span class="p">:</span><span class="w"> </span><span class="mi">32000</span><span class="w"> </span><span class="p">}</span><span class="w">
    </span><span class="p">}</span><span class="w">
  </span><span class="p">]</span><span class="w">
  
  </span><span class="nl">"Router"</span><span class="p">:</span><span class="w"> </span><span class="p">{</span><span class="w">
    </span><span class="nl">"default"</span><span class="p">:</span><span class="w"> </span><span class="s2">"lmstudio-small,openai/gpt-oss-20b"</span><span class="p">,</span><span class="w">
    </span><span class="nl">"background"</span><span class="p">:</span><span class="w"> </span><span class="s2">"lmstudio-small,openai/gpt-oss-20b"</span><span class="p">,</span><span class="w">
    </span><span class="nl">"think"</span><span class="p">:</span><span class="w"> </span><span class="s2">"lmstudio-long,openai/gpt-oss-120b"</span><span class="p">,</span><span class="w">
    </span><span class="nl">"longContext"</span><span class="p">:</span><span class="w"> </span><span class="s2">"lmstudio-long,openai/gpt-oss-120b"</span><span class="p">,</span><span class="w">
    </span><span class="nl">"longContextThreshold"</span><span class="p">:</span><span class="w"> </span><span class="mi">3000</span><span class="p">,</span><span class="w">
    </span><span class="nl">"webSearch"</span><span class="p">:</span><span class="w"> </span><span class="s2">"lmstudio-small,openai/gpt-oss-20b"</span><span class="p">,</span><span class="w">
    </span><span class="nl">"image"</span><span class="p">:</span><span class="w"> </span><span class="s2">"lmstudio-small,openai/gpt-oss-20b"</span><span class="w">
  </span><span class="p">}</span><span class="w">
  </span><span class="err">...</span><span class="w">
</span><span class="p">}</span><span class="w">
</span></code></pre></div></div>

<p>Con questa configurazione i tempi di reasoning erano più stabili, il contesto mantenuto correttamente e, finalmente, il ciclo di sviluppo completato in modo coerente.</p>

<figure class=""><img src="/assets/images/coding-agent-locale/coding-agent-locale-gpt-oss-120b-1-analysis.png" alt="gpt-oss 120B - analysis" /><figcaption>
      Analizziamo il progetto con il modello da 120B

    </figcaption></figure>

<figure class=""><img src="/assets/images/coding-agent-locale/coding-agent-locale-gpt-oss-120b-2-fix.png" alt="gpt-oss 120B - 2" /><figcaption>
      Inizio implementazione rate limiting feature…

    </figcaption></figure>

<figure class=""><img src="/assets/images/coding-agent-locale/coding-agent-locale-gpt-oss-120b-3-fix.png" alt="gpt-oss 120B - 3" /><figcaption>
      … completiamo l’implementazione.

    </figcaption></figure>

<figure class=""><img src="/assets/images/coding-agent-locale/coding-agent-locale-gpt-oss-120b-4-test.png" alt="gpt-oss 120B - 4" /><figcaption>
      Preparazione test della nuova feature

    </figcaption></figure>

<figure class=""><img src="/assets/images/coding-agent-locale/coding-agent-locale-gpt-oss-120b-5-test.png" alt="gpt-oss 120B - 5" /><figcaption>
      Test eseguiti correttamente.

    </figcaption></figure>

<p>Il tempo medio per richiesta utente si è assestato intorno ai <strong>30 secondi</strong>, con variazioni in base al tipo di operazione e al numero di file coinvolti.
Un risultato tutt’altro che “snello”, ma perfettamente accettabile considerando che tutto girava su una singola macchina.</p>

<figure class=""><img src="/assets/images/coding-agent-locale/coding-agent-locale-gpt-oss-120b-config-memory.png" alt="gpt-oss 20B + 120B - config" /><figcaption>
      Configurazione definitiva e memoria utilizzata.

    </figcaption></figure>

<figure class=""><img src="/assets/images/coding-agent-locale/coding-agent-locale-gpt-oss-120b-running-cache-reuse.png" alt="gpt-oss 20B + 120B - running" /><figcaption>
      Modelli da 120B e 20B in esecuzione in contemporanea e cache correttamente utilizzata.

    </figcaption></figure>

<hr />

<h2 id="6-considerazioni">6. Considerazioni</h2>

<p>Dopo vari giorni di prove, questi sono alcuni dei punti che mi porto a casa:</p>

<ul>
  <li>
    <p><strong>Agentic coding è un carico completamente diverso dalla chat.</strong>
Un agente deve pianificare, leggere e aggiornare continuamente il contesto, quindi non basta che il modello “si carichi e giri”.</p>
  </li>
  <li>
    <p><strong>La memoria è spesso il collo di bottiglia.</strong>
Ogni incremento nel contesto massimo si traduce in gigabyte di memoria aggiuntiva.
La configurazione a due modelli descritta qui sopra portava la mia macchina ad utilizzare complessivamente attorno a 90 GB di memoria.</p>
  </li>
  <li>
    <p><strong>Separare i modelli serve.</strong>
Quantomeno per come pare essere il funzionamento di Claude Code, e in assenza di un KV cache manager evoluto, un setup multi-modello (piccolo + grande) aiuta a non invalidare continuamente la cache e migliora la reattività percepita.</p>
  </li>
  <li>
    <p><strong>La velocità di generazione conta meno della latenza iniziale.</strong>
In locale, l’attesa per il primo token è spesso il fattore dominante.</p>
  </li>
</ul>

<hr />

<h2 id="7-conclusione">7. Conclusione</h2>

<p>Mi sento di dire che portare un <em>coding agent</em> in locale (per singolo utente) oggi è sostanzialmente possibile, ma richiede hardware generoso, pazienza e un po’ di curiosità tecnica.
Il risultato finale non sostituisce l’esperienza fluida di Claude Code utilizzato attraverso le API, ma permette di capire meglio <strong>cosa succede sotto il cofano</strong>:
quali risorse servono, come incide il contesto, cosa fa la cache, etc.
In termini di qualità nel coding, quanto proposto dal <code class="language-plaintext highlighter-rouge">gpt-oss-120b</code> è a prima vista buono, ma mi aspetto che al crescere della complessità del progetto, il divario con i risultati ottenibili utilizzando le API a modelli remoti si percepisca in modo evidente.</p>

<p>Infine, chiaramente la scelta di usare Claude Code Router nasceva dall’idea di provare uno scenario il più simile a quello testato nel post del mese scorso; per quanto l’idea di base del tool sia interessante, non è necessariamente la migliore per il caso d’uso descritto in questo post. Nelle prossime settimana non escludo di provare altri agenti, magari pensati proprio per l’esecuzione con modelli locali.</p>]]></content><author><name>Alessio Soldano</name></author><category term="AI locale" /><category term="LLM" /><category term="aiopenweight" /><category term="Strix Halo" /><category term="generativeai" /><summary type="html"><![CDATA[Un esperimento pratico: far lavorare un coding agent interamente in locale e scoprire, tra cache, memoria e tempi di risposta, quanto sia davvero impegnativo.]]></summary></entry><entry><title type="html">Eseguire modelli AI in locale (o in ambienti controllati): libertà, limiti e prospettive</title><link href="https://aladinodigitale.it/2025/10/22/local-ai.html" rel="alternate" type="text/html" title="Eseguire modelli AI in locale (o in ambienti controllati): libertà, limiti e prospettive" /><published>2025-10-22T00:00:00+00:00</published><updated>2025-10-22T00:00:00+00:00</updated><id>https://aladinodigitale.it/2025/10/22/local-ai</id><content type="html" xml:base="https://aladinodigitale.it/2025/10/22/local-ai.html"><![CDATA[<h2 id="eseguire-modelli-ai-in-locale-o-in-ambienti-controllati-libertà-limiti-e-prospettive">Eseguire modelli AI in locale (o in ambienti controllati): libertà, limiti e prospettive</h2>

<p>Mentre le news di nuovi servizi e funzionalità di Gemini, Claude, ChatGPT, etc. si susseguono, permane un certo interesse nella community a proposito di soluzioni per eseguire modelli di intelligenza artificiale generativa <strong>fuori dai grandi servizi cloud</strong>.
L’obbiettivo in sostanza è far girare <strong>modelli open-weight</strong> – cioè con pesi pubblicamente scaricabili – <strong>sul proprio computer o in ambienti cloud “controllati”</strong>, dove si sceglie quale modello usare, con quali dati e con quali vincoli.</p>

<p>Ma perché dovremmo volerlo fare?</p>

<hr />

<h2 id="perché-scegliere-un-ambiente-controllato">Perché scegliere un ambiente controllato</h2>

<p>L’uso di servizi gestiti (come ChatGPT o Gemini) offre comodità e prestazioni, ma comporta anche <strong>limiti importanti</strong>:</p>

<ul>
  <li><strong>Controllo dei dati</strong> – i prompt, i file caricati e i risultati possono transitare su infrastrutture esterne, con implicazioni per la privacy o la proprietà intellettuale.</li>
  <li><strong>Dipendenza dal provider</strong> – le API possono cambiare, i modelli essere aggiornati o rimossi senza preavviso.</li>
  <li><strong>Costi e scalabilità</strong> – per usi intensivi o sperimentali, le tariffe possono diventare elevate.</li>
  <li><strong>Limitazioni operative</strong> – molti servizi impongono limiti di contesto o non permettono l’esecuzione di modelli personalizzati.</li>
</ul>

<p>Ecco perché si registra l’interesse per soluzioni “<strong>local-first</strong>”: esecuzione <strong>in locale</strong> o in <strong>ambienti controllati</strong>, cioè <strong>cloud indipendenti</strong> o container privati dove si gestisce interamente l’infrastruttura e i modelli.</p>

<hr />

<h2 id="local-vs-ambiente-controllato-cosa-significa-davvero">Local vs. ambiente controllato: cosa significa davvero</h2>

<p>Parlare di “locale” non vuol dire per forza “sul proprio portatile / desktop”.
Esistono oggi due grandi categorie:</p>

<ol>
  <li><strong>Esecuzione locale</strong> – tutto avviene sul proprio hardware, tipicamente con GPU o NPU dedicate.</li>
  <li><strong>Esecuzione in ambienti controllati</strong> – si usano risorse cloud, ma mantenendo pieno controllo su modelli, codice e dati.</li>
</ol>

<p>Alcuni servizi noti per quest’ultimo approccio:</p>

<ul>
  <li><strong><a href="https://www.runpod.io/">RunPod</a></strong> e <strong><a href="https://tensordock.com/">TensorDock</a></strong> – ambienti GPU “pay-per-minute” per LLM e Stable Diffusion, con possibilità di personalizzare container e storage.</li>
  <li><strong><a href="https://www.runcomfy.com/">RunComfy</a></strong> – piattaforma pronta per flussi <em>ComfyUI</em>, utile per generazione di immagini e video.</li>
  <li><strong><a href="https://vast.ai/">Vast.ai</a></strong> e <strong><a href="https://lambda.ai/service/gpu-cloud">Lambda Cloud</a></strong> – soluzioni per affittare GPU a breve termine, con immagini preconfigurate per PyTorch, Diffusers e llama.cpp.</li>
</ul>

<p>Queste opzioni offrono un buon equilibrio tra libertà e semplicità: il modello gira su macchine “tue” (o quasi), ma non devi preoccuparti di raffreddamento, alimentazione o driver.</p>

<hr />

<h2 id="i-limiti-prestazioni-qualità-contesto">I limiti: prestazioni, qualità, contesto</h2>

<p>Naturalmente, eseguire in locale o in ambienti controllati <strong>non è gratis</strong> — in termini di potenza e maturità del software:</p>

<ul>
  <li><strong>Velocità</strong>: un LLM da 70–120B può raggiungere solo pochi token/s su GPU consumer.</li>
  <li><strong>Qualità</strong>: i modelli open-weight più accessibili (Mistral, LLaMA, Gemma, Qwen, Flux) tipicamente non eguagliano GPT-4 o Gemini 2.5.</li>
  <li><strong>Contesto limitato</strong>: 4k–32k token tipici, contro i 128k–1M dei modelli gestiti.</li>
  <li><strong>Concorrenza</strong>: in un setup locale si può gestire solo un numero ridotto di richieste contemporanee.</li>
</ul>

<p>Per questo, l’uso locale si presta bene a:</p>

<ul>
  <li><strong>prototipazione e ricerca</strong>,</li>
  <li><strong>automazioni personali</strong>,</li>
  <li><strong>sperimentazione su dati sensibili</strong>,</li>
  <li><strong>edge computing o applicazioni offline</strong>.</li>
</ul>

<p>A livello enterprise, invece, gli ambienti controllati permettono di costruire <strong>pipeline AI interne</strong>, con costi prevedibili e modelli verificabili.</p>

<hr />

<h2 id="eseguire-modelli-in-locale-la-questione-hardware">Eseguire modelli in locale: la questione hardware</h2>

<p>E qui arriviamo al nodo centrale: <strong>la memoria video (VRAM)</strong>.
La VRAM determina la dimensione massima del modello che si può caricare e la sua velocità di inferenza.</p>

<ul>
  <li>Le <strong>GPU consumer</strong> (NVIDIA RTX 4090 o AMD 7900 XTX) arrivano a 24–32 GB di VRAM: già sufficienti per modelli da 7–13B, ma non oltre.</li>
  <li>Oltre questa soglia servono <strong>schede professionali</strong> o <strong>soluzioni con memoria condivisa</strong>, che unificano RAM e VRAM.</li>
</ul>

<p>Memoria condivisa: un cambio di paradigma</p>

<p>Negli ultimi anni la distinzione tra RAM di sistema e VRAM della GPU si sta assottigliando.
Nei sistemi tradizionali CPU e GPU hanno memorie fisiche separate: per elaborare un modello, i dati devono essere copiati avanti e indietro tra i due spazi, con un notevole costo in termini di banda e latenza.
Le nuove architetture invece puntano a unificare la memoria, permettendo a CPU e GPU di accedere allo stesso spazio fisico, in modo coerente e ad altissima velocità.
È un cambiamento che semplifica il calcolo e apre scenari nuovi per l’esecuzione di modelli AI di grandi dimensioni, anche su macchine compatte.</p>

<p>Tre approcci oggi particolarmente interessanti:</p>

<p>🧩 Apple Silicon (M3, M4, M4 Pro)</p>

<p>Apple è stata la prima a portare su larga scala il concetto di Unified Memory Architecture (UMA): CPU, GPU e Neural Engine condividono la stessa memoria fisica, a banda elevata (fino a 120 GB/s).
Questo elimina la necessità di copiare i dati tra dispositivi e rende possibile caricare interamente un modello di grandi dimensioni (come un LLM da 13B) in un’unica area di memoria.
L’efficienza energetica è eccellente, ma la memoria è saldato-on-chip e quindi non espandibile; i tagli disponibili (fino a 48–64 GB nelle versioni Pro/Max) restano piuttosto costosi.</p>

<p>⚡ NVIDIA DGX Spark (Grace Blackwell GB10)</p>

<p>Il DGX Spark, presentato al GTC 2025, rappresenta il primo sistema “personale” della linea DGX.
Basato sul superchip NVIDIA GB10 Grace Blackwell, integra una CPU Grace a 20 core (10 Cortex-X925 + 10 Cortex-A725) e una GPU Blackwell di quinta generazione in un singolo package.
Le due unità condividono 128 GB di memoria LPDDR5X coerente tramite NVLink-C2C, che fornisce una banda fino a 5× superiore a PCIe Gen 5.
Il risultato è un modello di memoria CPU+GPU realmente unificato, con accesso coerente e senza copia dei tensor, capace di gestire fino a 200 miliardi di parametri (o 405B collegando due sistemi via ConnectX a 200 Gbps).
Con un assorbimento di circa 240 W e dimensioni da mini-desktop (15 × 15 × 5 cm), il DGX Spark è una sorta di “AI workstation da scrivania”, ponte diretto tra le architetture UMA di Apple e i supercluster Grace Hopper dei data center.</p>

<p>🔥 AMD Ryzen™ AI Max+ 395 (Strix Halo)</p>

<p>Strix Halo segue una logica simile, ma in ambito consumer e con architettura x86.
È una APU monolitica che integra CPU Zen 5 e GPU RDNA 3.5, condividendo fino a 128 GB di memoria LPDDR5X con banda teorica di 250–300 GB/s.
Non ha VRAM dedicata: la GPU può allocare dinamicamente porzioni della RAM di sistema, come avviene nei Mac.
Questo approccio consente di eseguire modelli di grandi dimensioni senza schede video discrete, con un ottimo compromesso tra prestazioni, costi e consumo energetico.</p>

<hr />

<h2 id="la-mia-esperienza-con-amd-ryzen-ai-max-395-128-gb">La mia esperienza con AMD Ryzen™ AI Max+ 395 (128 GB)</h2>

<p>Sto sperimentando proprio questa piattaforma; esistono diverse soluzioni in commercio, io ho scelto <a href="https://frame.work/it/en/desktop">frame.work desktop</a> nella versione con 128GB di memoria. Come sistema operativo, utilizzo unicamente Linux.</p>

<p>Uno dei vantaggi è che, pur potendo configurare nel BIOS la quantità di memoria riservata alla GPU (ad esempio 512 MB), <strong>Linux gestisce dinamicamente la condivisione RAM/VRAM</strong>, come avviene nei sistemi Apple.
Per ottenere buone prestazioni è necessario impostare alcuni parametri del kernel relativi all’allocazione (nello specifico <code class="language-plaintext highlighter-rouge">amdgpu.gttsize</code> e <code class="language-plaintext highlighter-rouge">ttm.pages_limit</code>).</p>

<p>Il supporto software è in piena evoluzione:</p>

<ul>
  <li><strong>Kernel 6.18</strong> introdurrà correzioni importanti per la gestione della memoria su Strix Halo.</li>
  <li><strong>Driver Mesa</strong> e <strong>ROCm</strong> hanno guadagnato fino al <strong>+25 % di performance</strong> negli ultimi mesi.</li>
  <li>Tuttavia, <strong>instabilità e driver sperimentali</strong> rendono l’esperienza ancora poco “plug and play”.</li>
</ul>

<p>Il bilancio complessivo è positivo: <strong>un rapporto costo/prestazioni molto interessante</strong> per chi vuole sperimentare LLM e modelli generativi senza GPU dedicate.</p>

<hr />

<h2 id="toolbox-e-primi-test-pratici">Toolbox e primi test pratici</h2>

<p>Un ottimo punto di partenza sono le <strong><a href="https://github.com/kyuz0">toolbox su GitHub di Donato Capitella</a></strong>, che semplificano l’esecuzione (ottimizzata per questo specifico hardware AMD) di <em>llama.cpp</em>, <em>Qwen Image Studio</em>, <em>Wan Video Studio</em> e <em>ComfyUI</em>.</p>

<p>Ecco ad esempio un benchmark di esecuzione di <strong>GPT-OSS 120B</strong> con <em>llama-bench</em>, con il backend <em>Vulkan</em> abilitato:</p>

<figure class=""><img src="/assets/images/local-ai/toolbox-gpt-oss-120b.jpg" alt="GPT-OSS 120B benchmark" /><figcaption>
      GPT-OSS 120B benchmark

    </figcaption></figure>

<p>Interfaccia di generazione immagini <strong>Qwen Image Studio</strong>:</p>

<figure class=""><img src="/assets/images/local-ai/qwen-image-studio-generate.jpg" alt="Qwen Image Studio - generate" /><figcaption>
      Qwen Image Studio - generazione di immagine

    </figcaption></figure>

<figure class=""><img src="/assets/images/local-ai/qwen-image-studio-result.jpg" alt="Qwen Image Studio - result" /><figcaption>
      Qwen Image Studio - immagine ottenuta (8 steps)

    </figcaption></figure>

<p>E un workflow di generazione ibrido con <strong>Flux Krea Dev</strong> dentro <em>ComfyUI</em>:</p>

<figure class=""><img src="/assets/images/local-ai/comfyui-krea-generate.jpg" alt="ComfyUI running Flux Krea Dev workflow" /><figcaption>
      Esecuzione di un workflow ComfyUI basato su Flux Krea Dev

    </figcaption></figure>

<figure class=""><img src="/assets/images/local-ai/comfyui-krea-result.jpg" alt="Flux Krea Dev workflow complete ini ComfyUI" /><figcaption>
      Workflow Flux Krea Dev completato dentro ComfyUI

    </figcaption></figure>

<hr />

<h2 id="considerazioni-sulle-configurazioni">Considerazioni sulle configurazioni</h2>

<p>Un aspetto curioso su Strix Halo: spesso le <strong>quantizzazioni BF16</strong> risultano <strong>più efficienti di FP8</strong>, nonostante l’apparente “maggiore precisione”.
Questo dipende dall’implementazione dei driver ROCm e dal modo in cui viene gestita la memoria condivisa: le operazioni FP8, pur teoricamente più leggere, introducono overhead nella conversione e nella gestione dei buffer.</p>

<hr />

<h2 id="conclusione-e-prospettive">Conclusione e prospettive</h2>

<p>Eseguire modelli AI in locale o in ambienti controllati significa <strong>riappropriarsi del controllo</strong> su dati, costi e infrastruttura.
Chiaramente non è ancora un percorso lineare: servono competenze tecniche, pazienza e una certa tolleranza ai bug quando si ha a che fare con driver e librerie sperimentali.
Infine, in ambito consumer le soluzioni con memoria unificata e toolkit open-source consentono di ottenere risultati di discreta qualità in tempi ragionevoli.</p>

<p>Nei prossimi post racconterò <strong>alcuni use case concreti su Strix Halo</strong>, con esempi di automazione locale e generazione di contenuti multimodali.</p>]]></content><author><name>Alessio Soldano</name></author><category term="AI locale" /><category term="LLM" /><category term="aiopenweight" /><category term="Strix Halo" /><category term="generativeai" /><summary type="html"><![CDATA[Casi d'uso, soluzioni enterprise e customer... e alcune prove con AMD Strix Halo.]]></summary></entry></feed>