Quando diamo un’immagine a un modello e gli chiediamo di analizzarla, possiamo avere in mente operazioni molto diverse. Trovare gli oggetti presenti. Indicarne uno con un punto. Selezionare quello descritto da una frase. Contare le persone. Leggere un cartello e localizzarlo. Estrarre un soggetto con una trasparenza abbastanza precisa da conservarne i capelli.
Sono tutti scenari in cui immagini e linguaggio possono incontrarsi, ma richiedono capacità e risultati differenti. Una descrizione corretta della scena può bastare per una conversazione; un programma che deve usare quella risposta potrebbe aver bisogno di coordinate, istanze separate o una mappa dei pixel.
Per orientarsi tra modelli vision-language, Gemini, Qwen, SAM e progetti più specializzati come WeVisOne-VL, conviene partire proprio dai compiti. Capire quale problema stiamo risolvendo aiuta anche a riconoscere cosa offre davvero un nuovo modello.
Individuare oggetti: detection e pointing
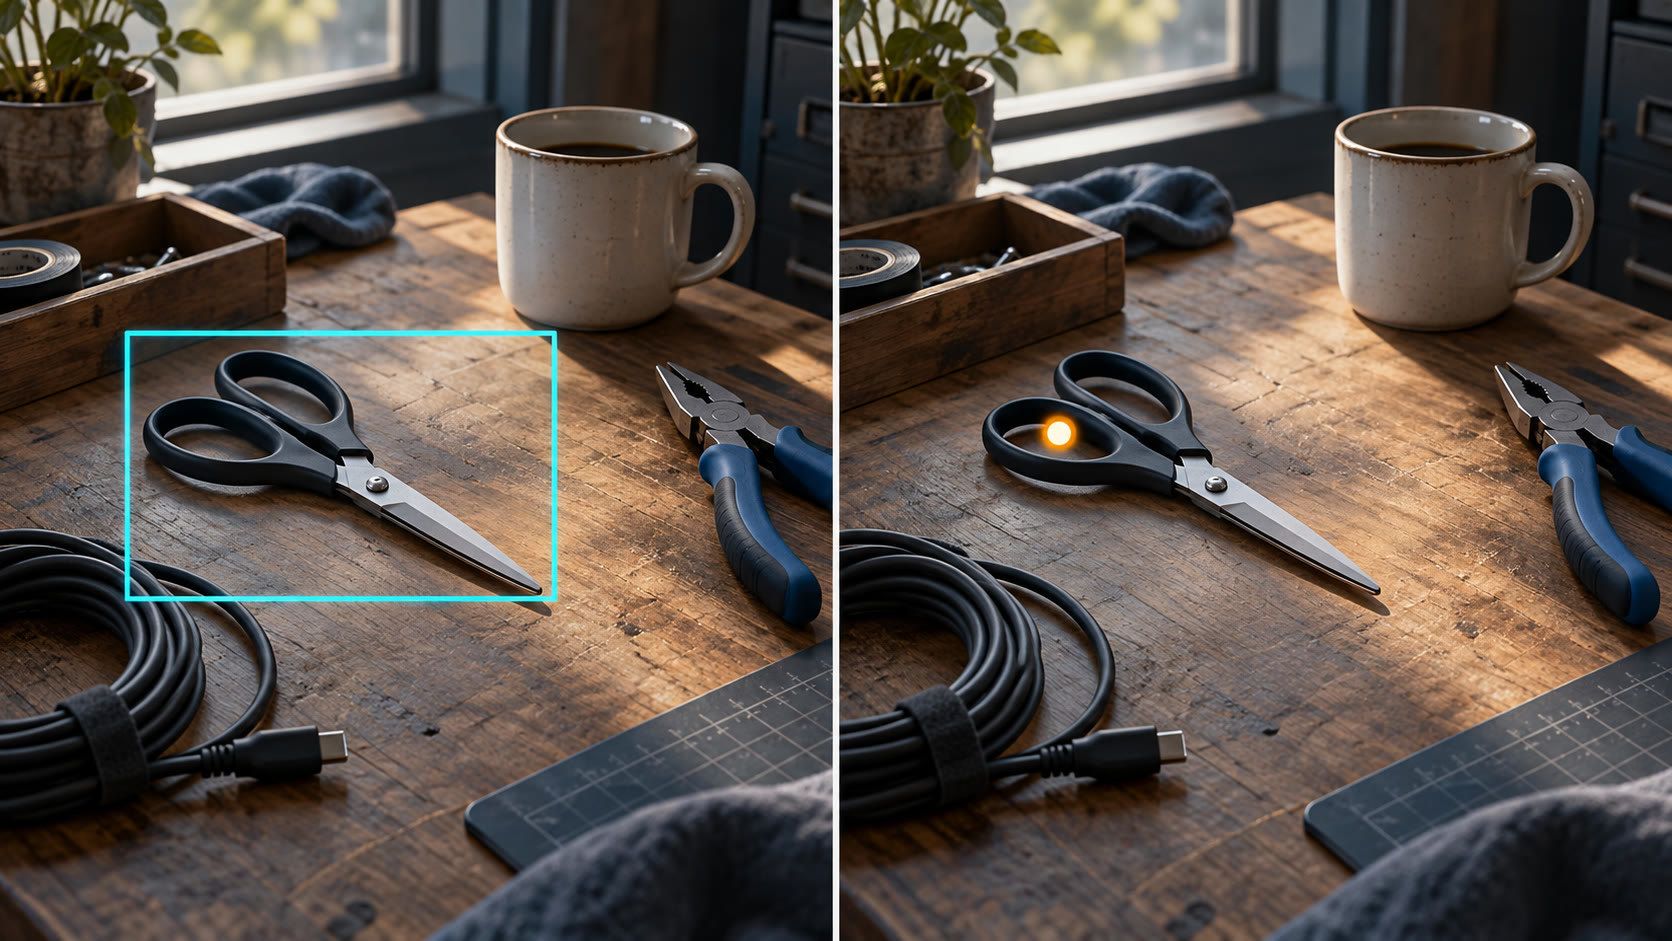
Immaginiamo la fotografia di un tavolo durante un laboratorio: utensili, scatole, qualche cavo, un foglio con istruzioni e una tazza. La prima richiesta potrebbe essere:
Individua tutte le forbici sul tavolo.
L’object detection cerca le istanze degli oggetti richiesti e ne localizza la posizione. Il risultato tipico è una bounding box, un rettangolo rappresentato dalle coordinate dei suoi angoli, spesso accompagnato da un’etichetta e da un punteggio di confidenza.
Se ci sono tre forbici, vorremmo tre rettangoli distinti. Il rettangolo non segue la forma delle lame e può includere altri oggetti o lo sfondo: serve a dire dove cercare, non a scontornare.
Con il pointing chiediamo invece uno o più punti:
Indica il centro di ciascuna forbice.
Un punto può essere sufficiente per mostrare un indicatore nell’interfaccia, suggerire dove cliccare o fornire un primo prompt a un altro modello. Non descrive l’estensione dell’oggetto e non è necessariamente il suo centro geometrico: dipende da come è definito il compito.
Un esempio utile è uno screenshot. Per azionare un pulsante può bastare una coordinata interna alla sua area cliccabile; per evidenziarlo nell’interfaccia può essere preferibile il rettangolo che lo contiene. Già qui, due output entrambi “spaziali” rispondono a esigenze diverse.
Alcuni detector riconoscono un insieme di categorie stabilito nell’addestramento. I sistemi open-vocabulary permettono di specificare gli oggetti attraverso parole o brevi descrizioni. Questo amplia la flessibilità, ma non implica che ogni istruzione articolata venga interpretata correttamente.
Scegliere l’istanza giusta: il referring
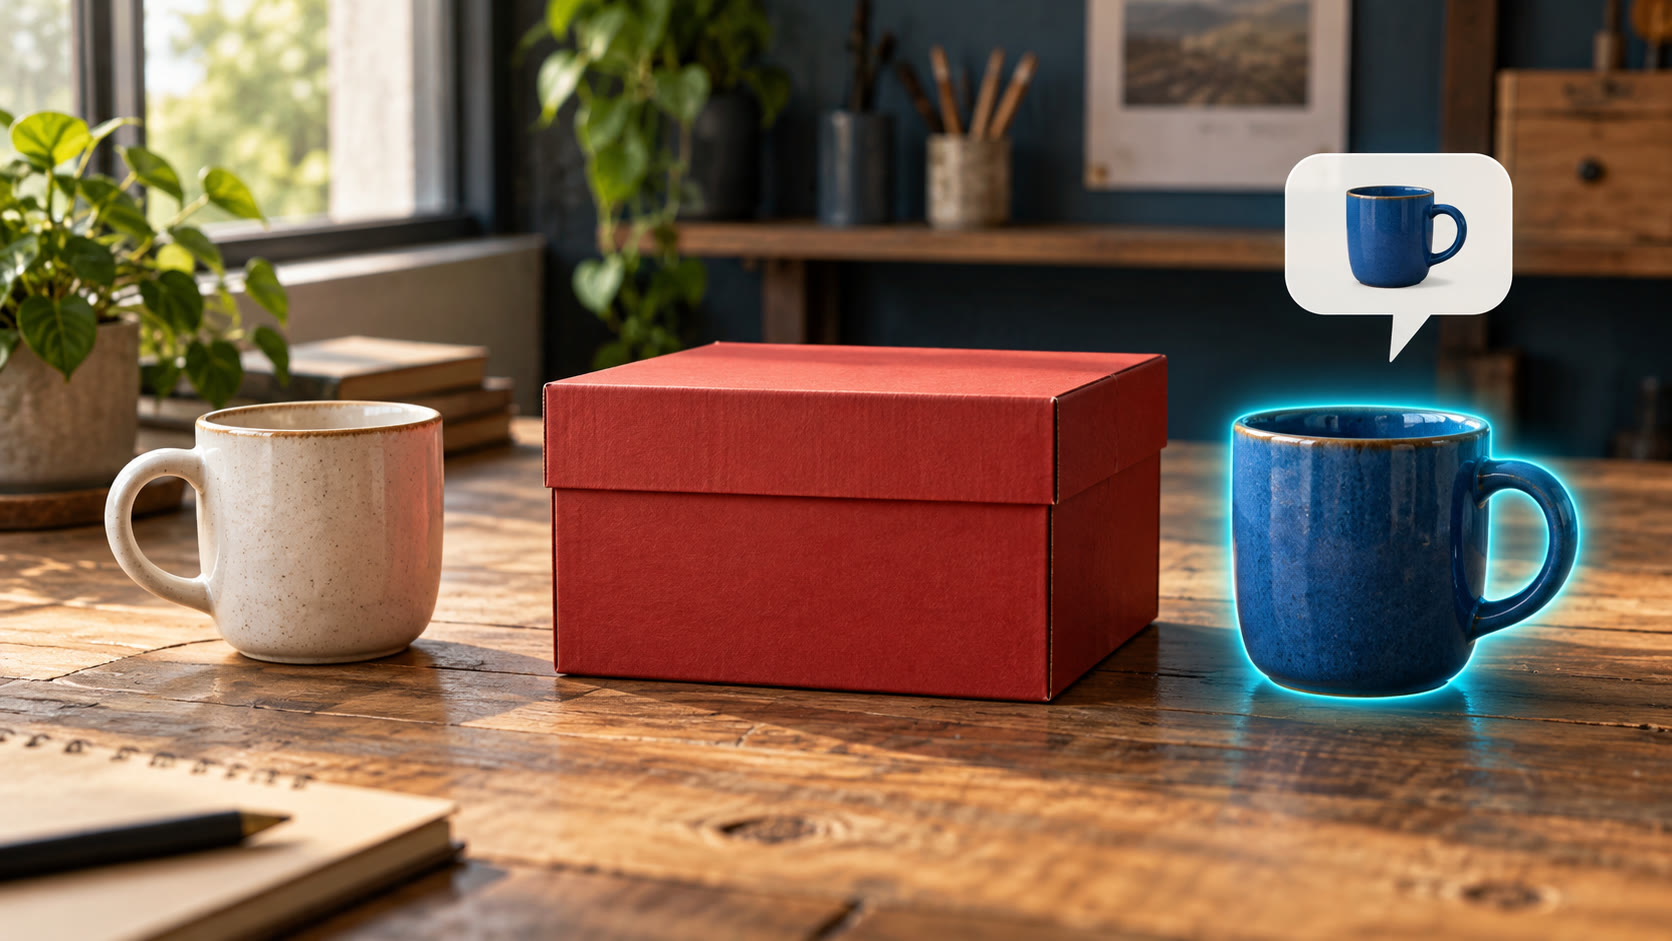
Sul tavolo ci sono due tazze. Dire “tazza” non basta più:
Seleziona la tazza a destra della scatola rossa.
Qui entra in gioco il referring, cioè l’identificazione del soggetto a cui si riferisce una descrizione. Per rispondere bisogna collegare parole, attributi e relazioni alla scena: riconoscere la scatola, distinguere le tazze e interpretare “a destra”.
La richiesta può contenere azioni, confronti o esclusioni: la persona che tiene il microfono, il vaso più piccolo, gli attrezzi sul tavolo ma non quelli nella scatola.
Il referring riguarda quale istanza intendiamo. Il risultato può poi essere espresso come punto, bounding box o maschera. Quando si parla di referring segmentation, si intende proprio la selezione dei pixel dell’oggetto descritto.
È il tema che avevo già affrontato nel post sulla segmentazione conversazionale con Gemini 2.5: individuare gli oggetti sul prato che potevano interferire con il tagliaerba, escludendo quelli sull’erba sintetica. L’interesse stava nella capacità di interpretare il criterio della selezione, oltre al riconoscimento degli oggetti.
Contare: un numero deve corrispondere a delle istanze
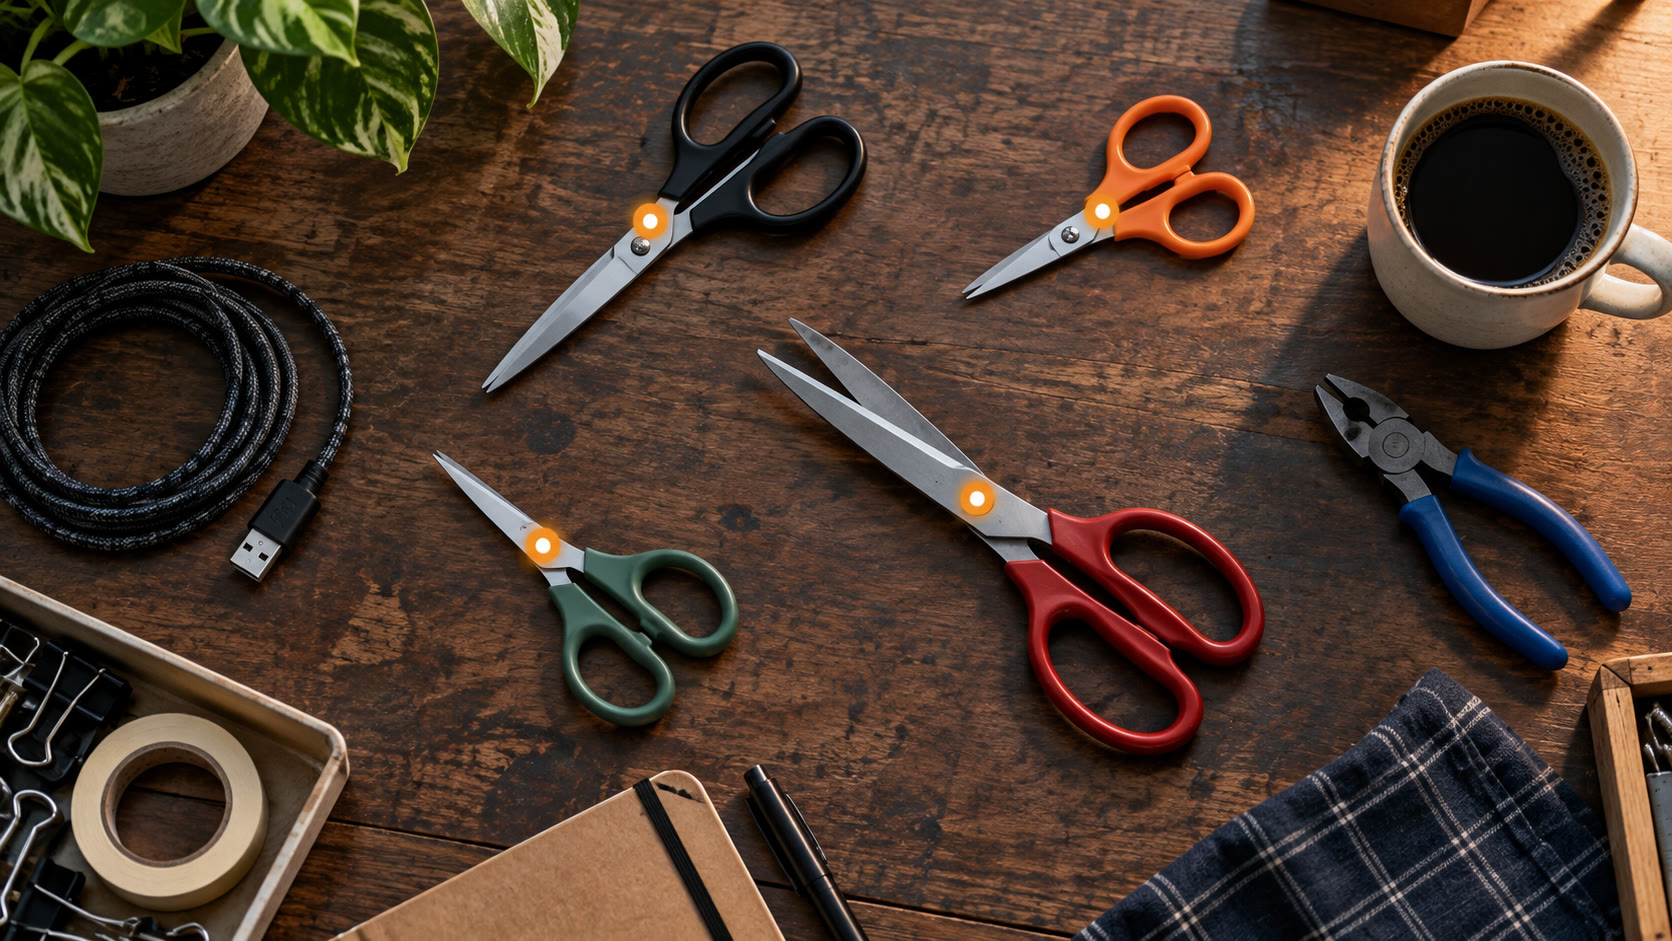
Un’altra domanda apparentemente semplice è:
Quante forbici ci sono sul tavolo?
Il counting richiede di distinguere le singole istanze, comprese quelle piccole, parzialmente nascoste o vicine tra loro. Un modello può riconoscere bene il concetto di forbice e comunque saltarne una o contare due volte lo stesso oggetto.
Il criterio può rendere il compito più impegnativo: “quante persone indossano occhiali?” richiede di associare un attributo a ciascuna persona prima di contarla.
Per un’applicazione può essere utile ottenere, insieme al numero, anche punti o box che mostrino quali istanze sono state considerate. Non rende il risultato infallibile, ma lo rende più verificabile. Vedere sette indicatori su una fotografia aiuta a controllare il conteggio molto più di una risposta isolata come “sette”.
Determinare il numero e localizzare ogni oggetto sono comunque requisiti distinti: non tutti i sistemi di conteggio espongono entrambi.
Leggere e localizzare: OCR e text grounding
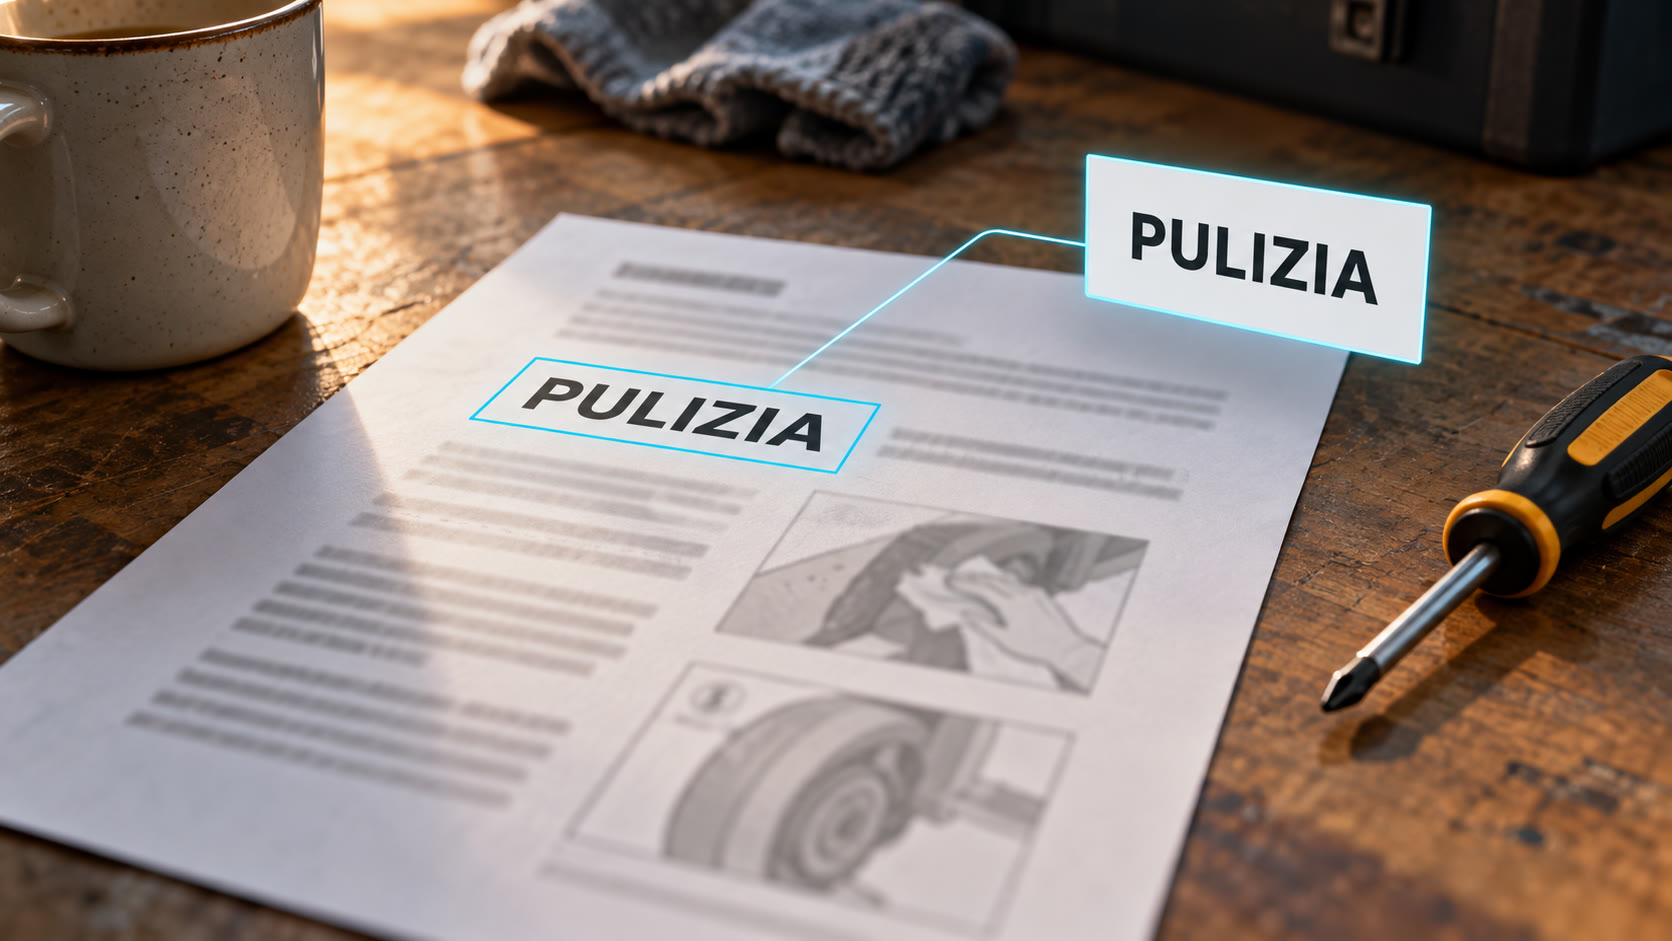
Sul foglio appoggiato al tavolo leggiamo una serie di istruzioni. Potremmo chiedere:
Trascrivi il testo del foglio.
L’OCR, Optical Character Recognition, trasforma i caratteri presenti nei pixel in testo utilizzabile da un programma. Nelle applicazioni reali il lavoro comprende spesso anche individuare le righe, riconoscere l’orientamento e ricostruire l’ordine di lettura.
Se vogliamo evidenziare una particolare istruzione, serve un’informazione aggiuntiva:
Dove si trova la scritta “spegnere prima della pulizia”?
Con text grounding, in questo contesto, intendiamo il collegamento tra il testo e la regione dell’immagine in cui compare. L’output può essere un rettangolo o un poligono, utile per evidenziare la frase o ritagliare la porzione interessata.
Il termine grounding è usato anche in senso più ampio: collegare una descrizione linguistica a un oggetto nella scena. Qui lo usiamo per localizzare scritte. Perciò “trova il cartello di uscita” e “localizza la parola USCITA” sono richieste collegate, ma possono identificare regioni differenti: il cartello intero oppure soltanto i caratteri.
Leggere e comprendere vanno poi distinti. Trascrivere “230 V” è OCR; interpretare cosa significhi nel contesto è un ulteriore compito.
Dai contorni alla trasparenza: segmentazione e matting
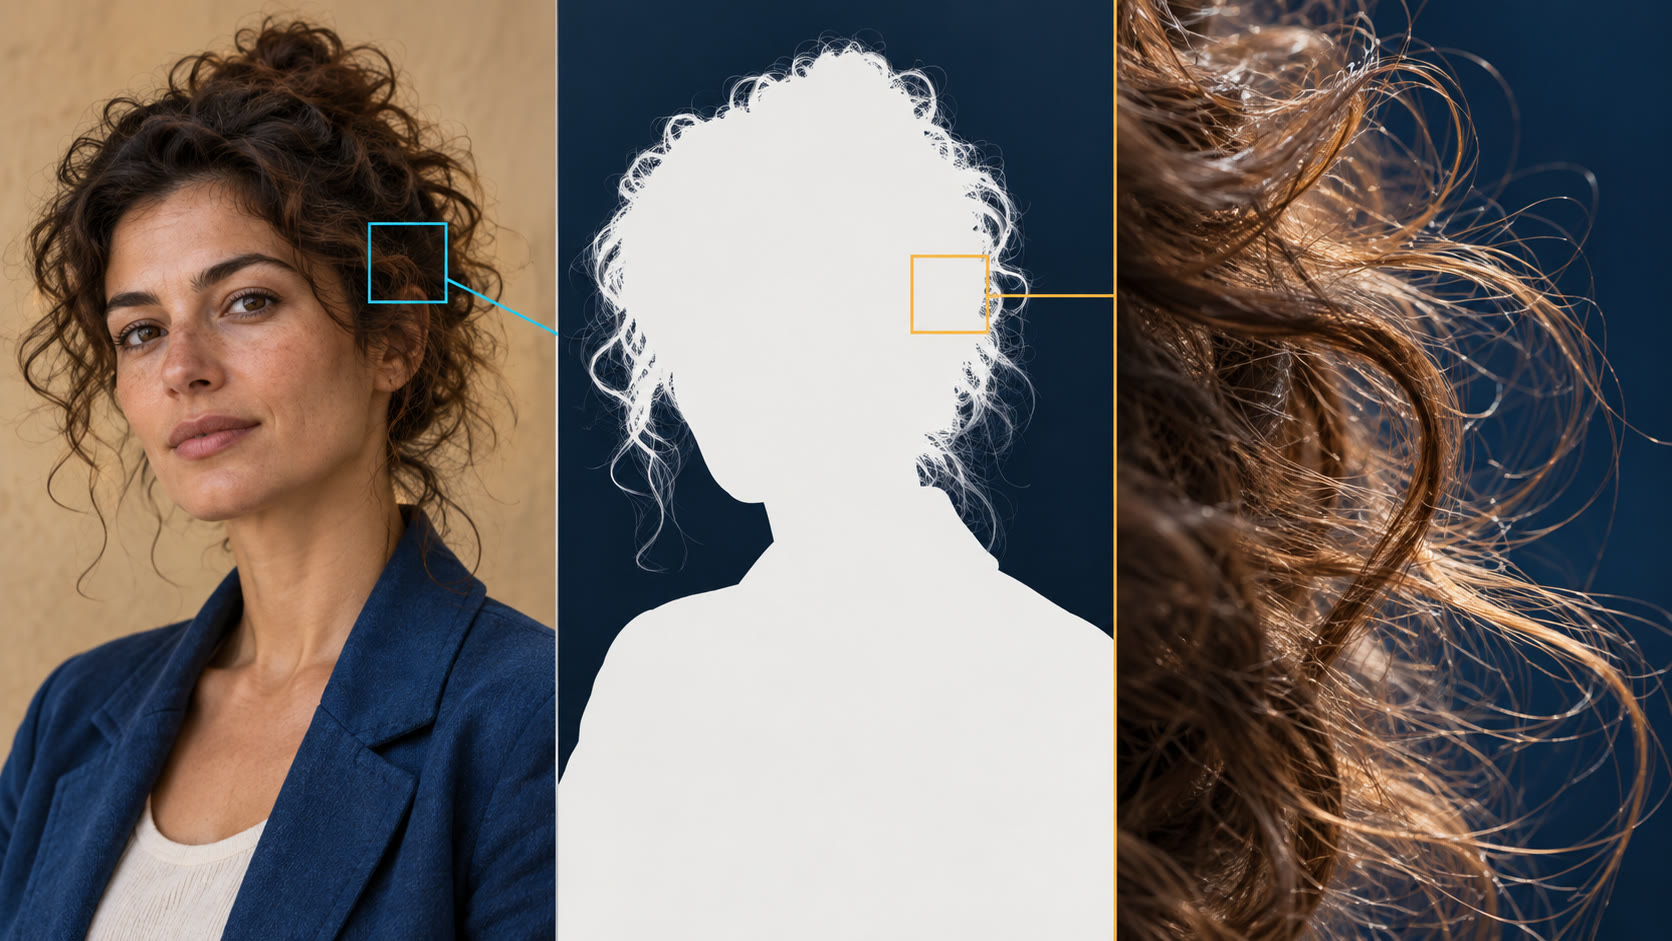
Per rimuovere lo sfondo della tazza, un rettangolo non basta. Serve selezionare i suoi pixel: è il compito della segmentazione.
Nel caso di una maschera binaria, ogni pixel appartiene oppure non appartiene al soggetto. Possiamo immaginarla come una sagoma bianca su fondo nero. Nella segmentazione delle istanze, tazze diverse possono avere maschere separate, anche se appartengono alla stessa categoria.
Ora immaginiamo di estrarre da una fotografia una persona con i capelli spettinati. Sul bordo di una ciocca, un singolo pixel può raccogliere sia il contributo del capello sia quello dello sfondo. Una scelta secca tra dentro e fuori perde questa informazione.
L’image matting stima una mappa continua, detta alpha matte, che descrive quanto il primo piano contribuisce a ogni pixel. Nel modello classico:
I = αF + (1 − α)B
I è il colore osservato, F il colore del primo piano e B quello dello sfondo. Alpha (α) vale 0 dove il primo piano non contribuisce, 1 dove contribuisce pienamente e un valore intermedio dove i contributi si mescolano. Questo può accadere sui capelli sottili, sui bordi sfocati o con materiali parzialmente trasparenti.
Un’immagine RGBA aggiunge ai tre canali di colore RGB un canale alpha, utilizzato per la trasparenza nella composizione. Il matting cerca di stimare l’alpha quando non è già noto: salvare semplicemente un file PNG non risolve il problema.
Ci sono due dettagli che aiutano a evitare equivoci. Il primo è che una maschera probabilistica non equivale a un alpha matte: “sono incerto se questo pixel appartenga al soggetto” e “qui il soggetto contribuisce per metà al colore” descrivono quantità diverse.
Il secondo è che stimare alpha non recupera automaticamente i colori puri del foreground. I pixel ai bordi possono contenere il colore del vecchio sfondo; riutilizzarli con una nuova trasparenza può lasciare aloni. Per una composizione accurata può servire anche una correzione dei colori del primo piano.
Una mappa dei risultati che possiamo chiedere
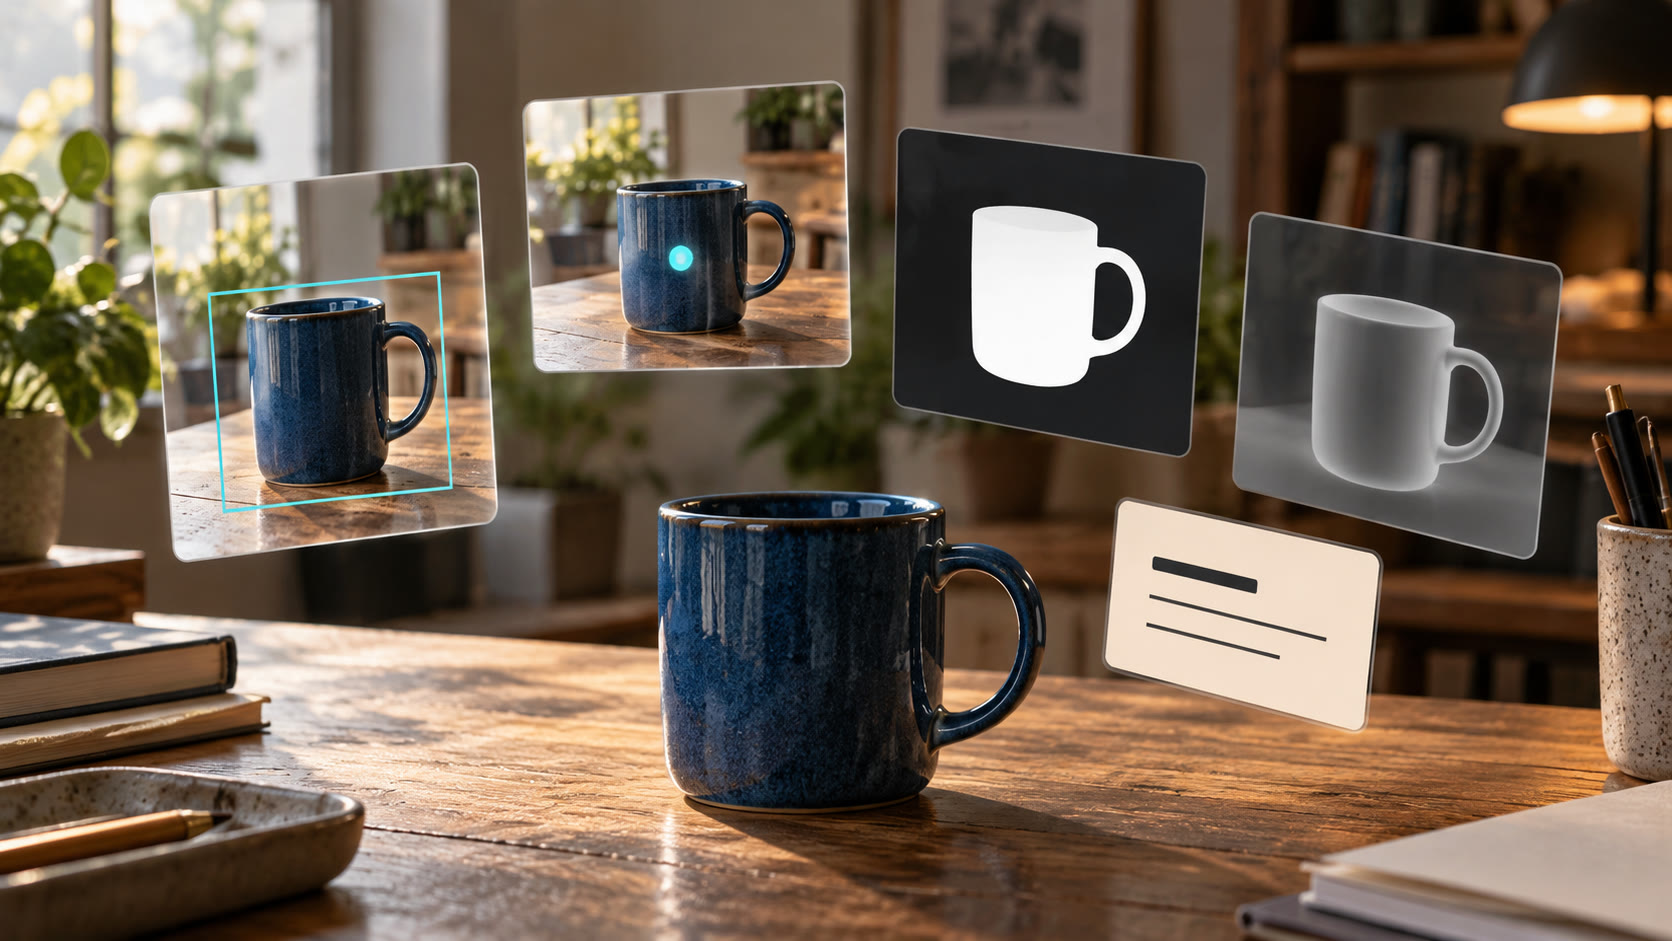
Questi compiti si possono combinare. Il linguaggio specifica il soggetto e il criterio; il formato della risposta stabilisce cosa potrà farne l’applicazione.
| Compito | Esempio di richiesta | Risultato utile |
|---|---|---|
| Object detection | Trova tutte le forbici | Un box per istanza |
| Pointing | Indica ciascuna forbice | Coordinate di punti |
| Referring | Trova la tazza a destra della scatola rossa | Localizzazione dell’istanza descritta |
| Counting | Quante persone hanno gli occhiali? | Numero, eventualmente con istanze verificabili |
| OCR | Trascrivi le istruzioni | Testo riconosciuto |
| Text grounding | Localizza una certa scritta | Regione del testo |
| Segmentazione | Seleziona i pixel della tazza | Maschera del soggetto |
| Matting | Estrai la persona conservando i capelli | Alpha matte continuo |
Gli esempi servono a illustrare i compiti: non sono prove comparative eseguite sui modelli citati di seguito.
Le soluzioni: VLM generalisti e strumenti specializzati
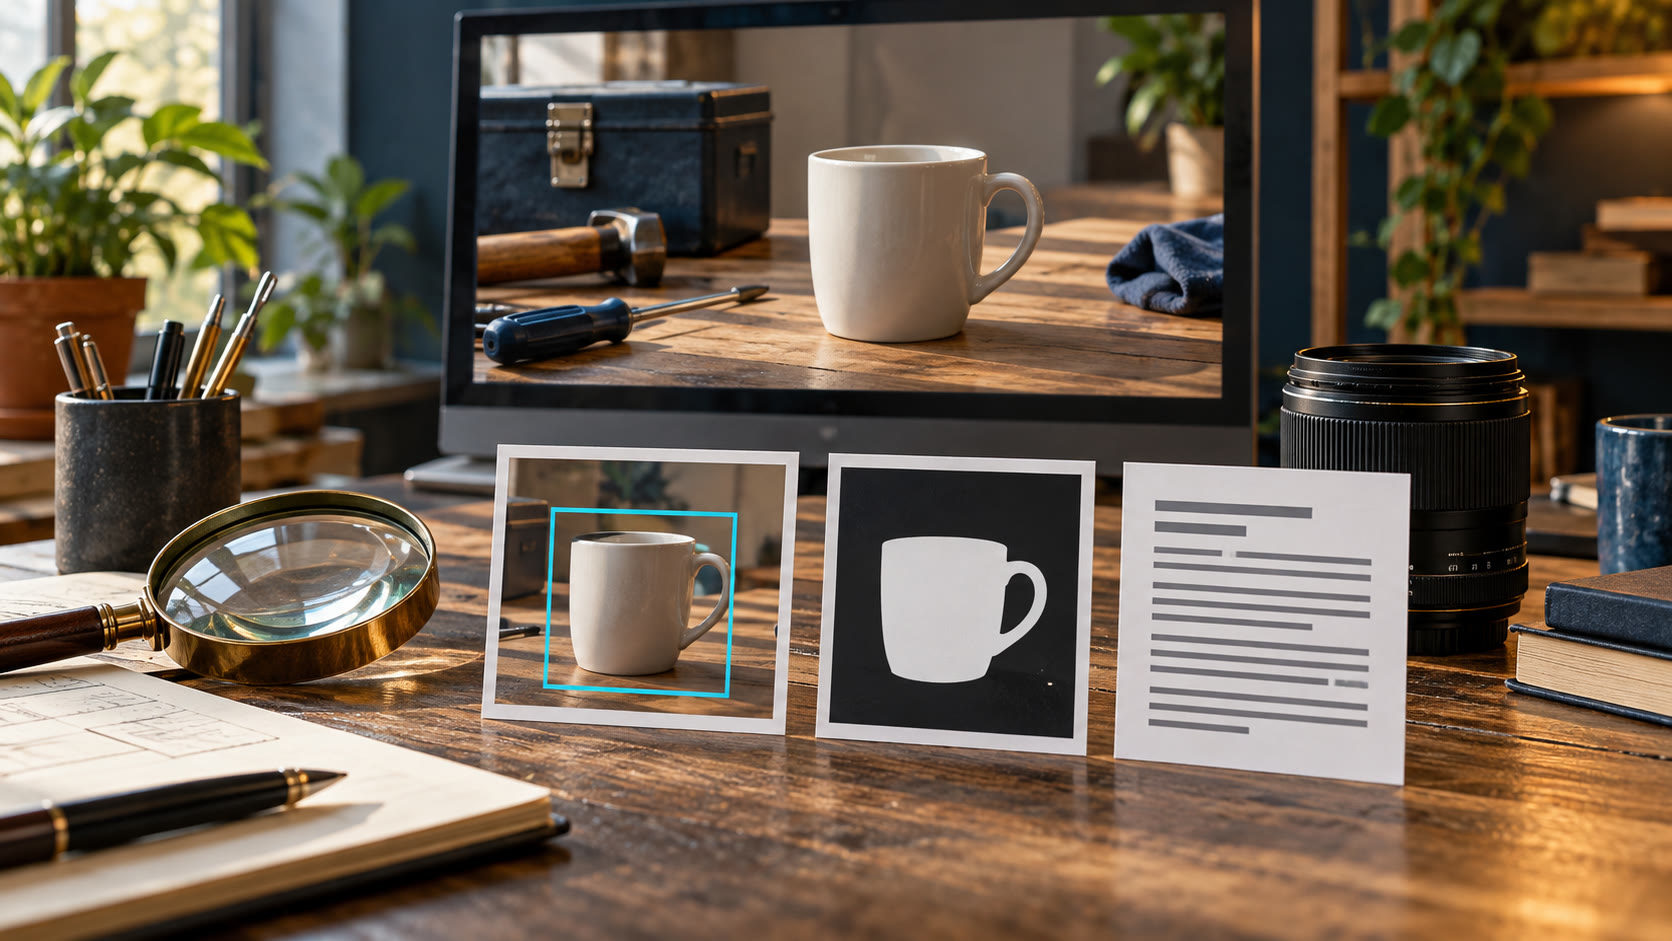
I Vision-Language Model, o VLM, collegano rappresentazioni delle immagini e del linguaggio. Molti di quelli che usiamo oggi sono modelli linguistici multimodali: ricevono immagini e istruzioni, interpretano la richiesta e producono una risposta, spesso testuale o strutturata.
Non tutti espongono gli stessi output. Saper descrivere un oggetto non garantisce di saperne produrre coordinate precise; generare un JSON ben formato non garantisce che quelle coordinate siano corrette. La localizzazione spaziale richiede capacità apprese, oltre a un formato di risposta.
Gemini e Qwen-VL: comprendere la scena e la richiesta
Gemini 2.5 era già un esempio di integrazione tra comprensione linguistica e segmentazione. Google mostrava selezioni basate su relazioni, negazioni e testo nella scena, ottenendo box, etichette e maschere tramite un’unica API. Il precedente del 2025 è quindi importante: la segmentazione guidata da istruzioni articolate non nasce con gli ultimi modelli specializzati.
La famiglia Qwen-VL, per esempio Qwen3-VL, offre modelli open weight con capacità di comprensione visiva, OCR e grounding attraverso box e punti. È una base interessante per costruire applicazioni sul proprio hardware. Non bisogna però dedurre dal nome “VL” la presenza di un decoder per maschere o alpha: sono capacità da verificare per la specifica release.
La differenza operativa è rilevante. Gemini 2.5 veniva utilizzato come servizio remoto, senza pesi scaricabili per eseguirlo localmente; con un VLM open weight compatibile possiamo gestire l’inferenza in proprio. Questo riguarda il modo in cui accediamo al modello, non dimostra da solo un’equivalenza nelle prestazioni.
Detector e OCR: quando il compito è ben definito
Per localizzare oggetti esistono detector dedicati. I sistemi della famiglia YOLO sono esempi di modelli progettati per la detection; Grounding DINO collega descrizioni testuali alla localizzazione degli oggetti.
Se il lavoro consiste nel leggere migliaia di documenti, una pipeline OCR come PaddleOCR è un’altra soluzione da considerare. Offre strumenti per riconoscere e localizzare il testo, con componenti eseguibili in locale.
Un modello generalista può interpretare richieste più ampie; uno strumento specializzato permette di affrontare direttamente una parte del problema. La scelta dipende da precisione richiesta, varietà degli input e costo di elaborazione. Non serve un unico modello per svolgere ogni passaggio.
SAM e le pipeline per ottenere maschere e alpha
La famiglia Segment Anything, SAM, nasce per la segmentazione guidata da prompt. Con SAM e SAM 2, punti e box permettono di indicare il soggetto; SAM 2 estende il lavoro al video. SAM 3 supporta anche concetti espressi mediante brevi descrizioni testuali, oltre a prompt visivi, detection e tracking.
Per esempio, individuare tutte le tazze rosse è un compito adatto a illustrare la segmentazione per concetti. Richieste con ragionamenti più articolati possono richiedere ulteriore interpretazione: il fatto che un sistema accetti testo non rende identiche le sue capacità a quelle di un VLM generalista.
Una soluzione comune è combinare i modelli. Grounded-SAM collega un localizzatore testuale a SAM: il primo produce i box, il secondo li usa per ricavare le maschere. Un VLM può analogamente interpretare una richiesta e passare la localizzazione a un segmentatore.
Anche il collegamento con il matting ha precedenti. Matting Anything aggiunge a SAM un modulo per stimare l’alpha. Sistemi come LISA hanno invece esplorato l’unione tra modelli linguistici multimodali e segmentazione basata sul ragionamento.
Queste soluzioni hanno già permesso di costruire flussi locali. Il loro compromesso è nella composizione: possiamo scegliere i componenti, ma dobbiamo gestire trasformazioni delle coordinate, formati, dipendenze e propagazione degli errori. Una maschera precisa dell’oggetto sbagliato rimane un risultato sbagliato.
I generatori di immagini: quando vogliamo creare o modificare un asset
Un’altra famiglia di soluzioni è quella dei modelli generativi di immagini. Possiamo chiedere di isolare un soggetto, cambiare il fondale o ricomporre la scena. Alcuni supportano anche la generazione di livelli RGBA con trasparenza.
Qwen-Image 2.1 è un esempio open weight che documenta generazione, editing ed estrazione di soggetti in RGBA, con codice per l’esecuzione locale. Va distinto da Qwen-VL: appartiene alla linea di generazione ed editing di immagini.
Il criterio pratico è la natura dell’output. Un generatore produce una nuova immagine, anche quando è condizionata da una fotografia; un modello di percezione può produrre una maschera associata all’originale, che l’applicazione riutilizza senza rigenerare i colori. Quando la fedeltà fotografica è un requisito, il risultato generativo va controllato per possibili variazioni dei dettagli.
L’editing creativo e la misura dei pixel possono arrivare a risultati visivamente simili attraverso processi diversi. Per una grafica può interessarci soprattutto la qualità finale; per annotare un dataset o preservare una fotografia ci interessa anche il rapporto esatto con l’input.
WeVisOne-VL: integrare gli output di percezione
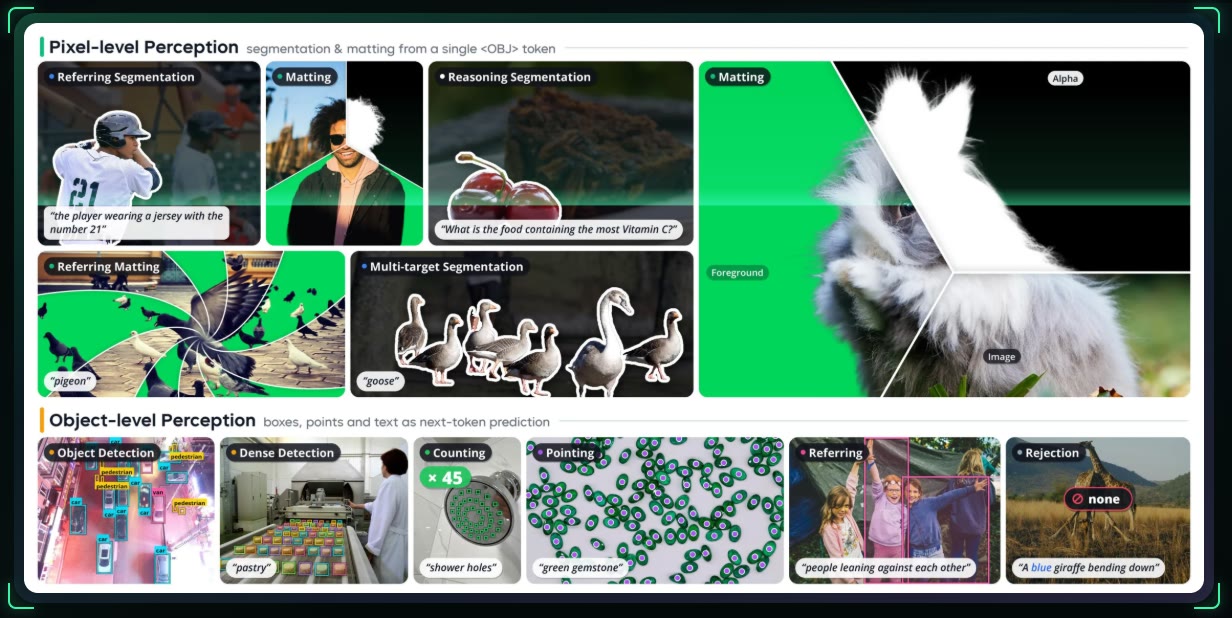
In questo panorama si colloca WeVisOne-VL. È costruito su Qwen3-VL e supporta detection, pointing, referring, counting, OCR, segmentazione e matting nelle versioni 2B e 4B.
Per capire come funziona, riprendiamo una richiesta concreta: «Seleziona la persona che tiene il microfono». Il modello deve capire a chi ci riferiamo e individuare la sua posizione. Se ci basta un punto o un rettangolo, può restituire direttamente quelle coordinate. Se vogliamo i pixel della persona, serve anche trasformare quella selezione in una maschera o in una mappa alpha.
WeVisOne-VL svolge questo secondo passaggio con un piccolo decoder per i pixel, cioè un componente che traduce le informazioni sull’oggetto selezionato in una previsione per ciascun pixel. Il decoder riceve sia le informazioni che il VLM ha già estratto dalla fotografia, sia l’indicazione di quale oggetto deve trattare e dove si trova.
Il collegamento tra le due parti avviene attraverso un segnale speciale, chiamato <OBJ>, che il modello produce insieme al rettangolo dell’oggetto. Possiamo pensarlo come il passaggio di consegne: «È questo il soggetto di cui devi ricavare i pixel». A seconda del compito richiesto, il risultato sarà una maschera di segmentazione oppure un alpha matte.
La particolarità è che le due parti lavorano sulle informazioni visive della stessa analisi dell’immagine. Non occorre passare la fotografia a un secondo modello completo come SAM per segmentarla. Il decoder aggiunto conta circa 9,6 milioni di parametri; il resto del sistema rimane un VLM da 2B o 4B.
È questa integrazione a rendere elegante la soluzione: dalla comprensione di quale soggetto vogliamo fino alla sua selezione a livello di pixel, compresa la trasparenza, all’interno della stessa architettura. La segmentazione linguistica aveva già precedenti; qui interessa il modo in cui è collegata agli altri compiti e al matting, con pesi disponibili per l’esecuzione locale.
Il report degli autori presenta risultati competitivi su numerosi benchmark di percezione. Questo giustifica l’interesse, ma non fornisce un confronto diretto con Gemini 2.5 o con i generatori di immagini. Gli autori segnalano inoltre limiti nel ragionamento complesso e nella predizione a singolo turno. Non va quindi letto come un sostituto universale dei VLM generalisti o dei sistemi video specializzati.
Per un’applicazione che debba trovare un soggetto descritto e ottenerne un alpha matte, riduce la necessità di assemblare modelli separati. L’esportazione del livello, il compositing e l’eventuale correzione dei colori del foreground rimangono operazioni da gestire nell’applicazione.
Come scegliere, anche per lavorare in locale
Il primo criterio è il risultato necessario. Per sapere cosa contiene una fotografia può bastare un VLM. Per contare oggetti dobbiamo controllare le istanze considerate. Per evidenziare una scritta servono anche le sue coordinate. Per preparare un ritaglio con capelli e bordi morbidi, dobbiamo valutare il matting e la resa sul nuovo sfondo.
| Esigenza | Approcci da valutare |
|---|---|
| Interpretare una scena e una richiesta articolata | VLM generalista, eventualmente con strumenti |
| Localizzare categorie o oggetti descritti | Detector dedicato, Grounding DINO, VLM con grounding |
| Ottenere maschere e seguire istanze nel video | Famiglia SAM e pipeline collegate |
| Leggere testo e recuperarne la posizione | Pipeline OCR o VLM adatto al compito |
| Collegare referring e alpha matting | Pipeline VLM + segmentazione + matting, oppure architetture integrate come WeVisOne-VL |
| Creare e modificare asset trasparenti | Generatori con supporto RGBA |
Il secondo criterio è dove vogliamo elaborare i dati. Open weight significa che i pesi sono disponibili: con ambiente e hardware adeguati possiamo eseguire il modello sul nostro sistema, conservare una versione precisa e costruire un flusso che non invii le immagini a un servizio esterno.
Questo vale per WeVisOne-VL e per diversi altri modelli citati, comprese release Qwen-VL e Qwen-Image. Non rende però equivalenti requisiti hardware o licenze: WeVisOne-VL è indicato come Apache 2.0; Qwen-Image 2.1 adotta una licenza specifica che limita l’uso commerciale senza accordo separato. Pesi disponibili, condizioni d’uso e velocità sulla propria macchina sono aspetti da verificare separatamente.
Rispetto agli esperimenti con Gemini del 2025, possiamo riprendere alcuni degli stessi problemi con strumenti scaricabili e controllabili direttamente. Le alternative locali esistevano già; oggi abbiamo anche nuove architetture integrate da mettere alla prova.
La domanda utile, davanti al prossimo annuncio, diventa allora più precisa: quale parte del lavoro svolge il modello, quali output restituisce e quanto sono affidabili per il nostro scopo? È da queste risposte che si costruisce un’applicazione, sia scegliendo un modello unico sia combinando più strumenti.
Riferimenti e approfondimenti
- Segmentazione conversazionale con Gemini 2.5: il precedente articolo su Aladino Digitale
- Google: Conversational image segmentation with Gemini 2.5
- Qwen3-VL: capacità, modelli e istruzioni di inferenza
- Grounding DINO: localizzazione guidata dal testo
- PaddleOCR: riconoscimento e localizzazione del testo
- SAM 3: codice, modelli ed esempi
- Grounded-SAM: combinare grounding e segmentazione
- Matting Anything: SAM e stima dell’alpha
- LISA: Reasoning Segmentation via Large Language Model
- Qwen-Image 2.1: generazione, editing, trasparenza e licenza
- WeVisOne-VL: pagina del progetto
- WeVisOne-VL: report tecnico, architettura, valutazioni e limiti
- WeVisOne-VL: codice e pesi